1.2 猫鼠回合:对抗性训练如何运转
1.2 猫鼠回合:对抗性训练如何运转
对抗性训练是 GAN 的运转方式:每个训练回合分两步——先冻结生成器、用真假混合批训练判别器;再冻结判别器、以"骗过判别器"为目标更新生成器。两个网络在同一循环里互为陪练、交替变强。 本节把一个回合拆到逐步可见的程度,并用可复算的数值实验展示双方能力的拉锯。
上一节认清了双方的身份,这一节让他们真正交一次手。规则的数学记账(损失函数)留到第 2 章,本节只关注运转结构:回合怎么分、信息怎么流、强弱的此消彼长长什么样。读完你能画出训练循环的框图,并解释"为什么判别器不能强得太过分"。
一个回合的解剖
回合结构图
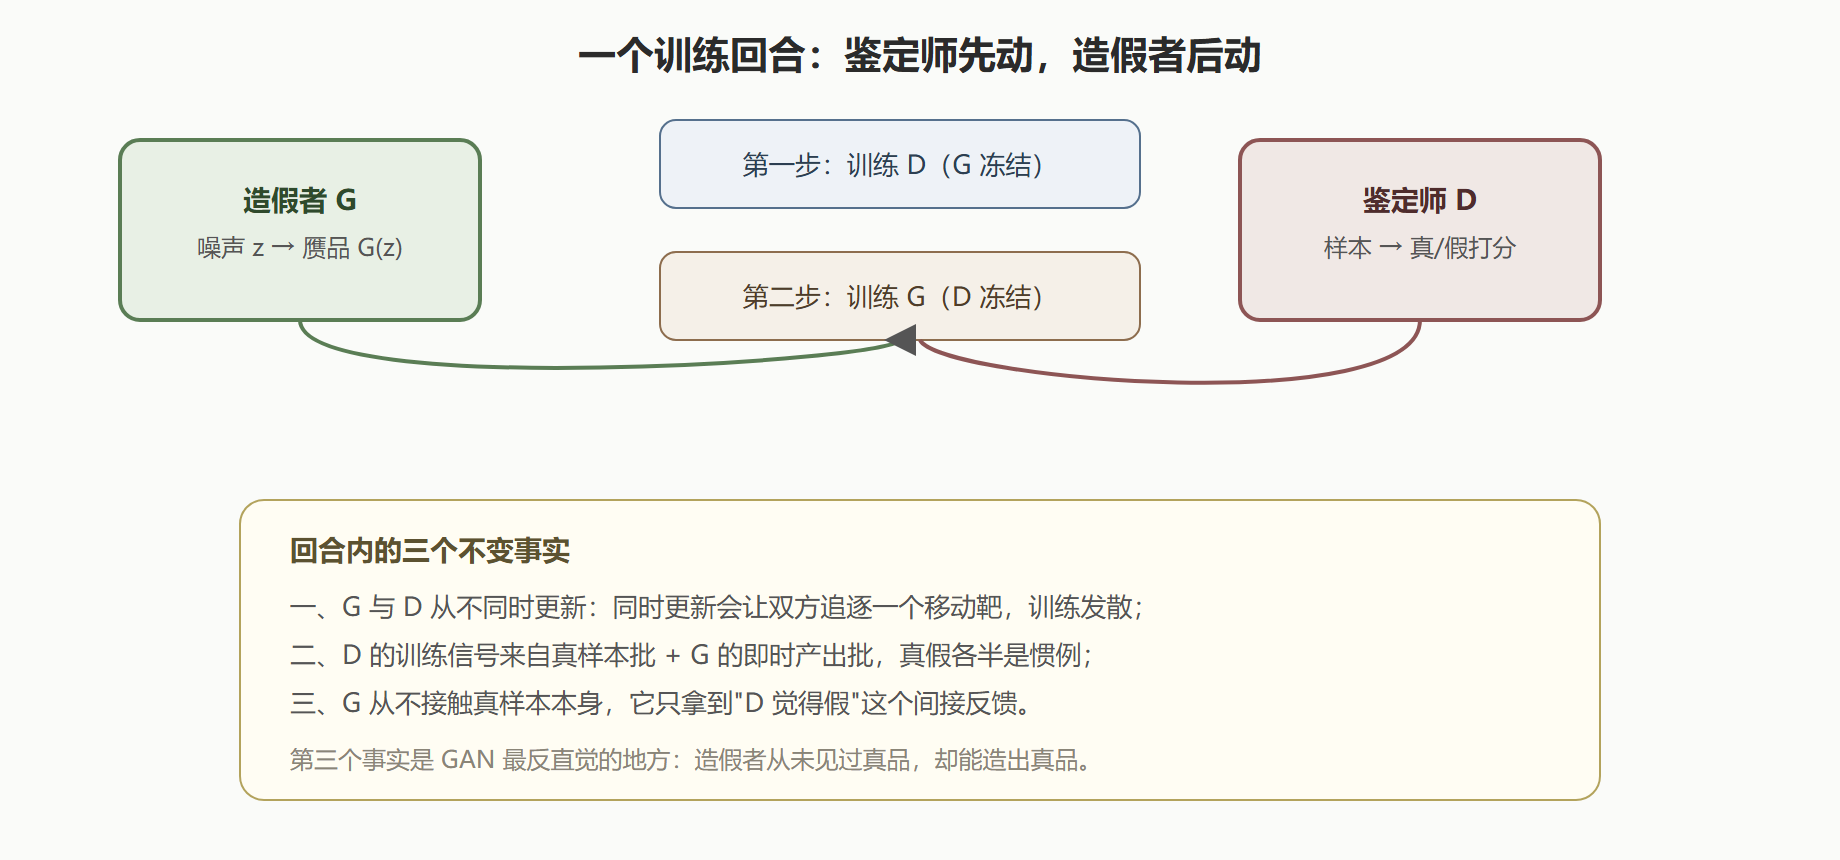
第三条事实值得单独咀嚼。传统监督学习里学生看得见标准答案;GAN 的生成器看不见,它只收到判别器回传的梯度——"往这个方向改,更像真的"。知识全部经由鉴定师这个中介传递。这解释了两件事:鉴定师水平太差时,造假者学不到东西(垃圾反馈);鉴定师水平断层式领先时,梯度通道也会失灵(细节见 6.2 节)。
数值实验:一场看得见的拉锯
空讲结构容易飘,直接跑一个一维玩具:真实数据服从均值 4 的正态;造假者只学一个"偏移量 mu"(把标准噪声平移);鉴定师是一个逻辑回归打分器。每个回合先训鉴定师若干步,再让造假者朝"鉴定师打分高的区域"挪一步。
import numpy as np rng = np.random.default_rng(42) mu = 0.0 # 造假者当前偏移:起点离真品很远 for step in range(5): xr = rng.normal(4, 1, 256) # 真样本批 xf = mu + 0.7 * rng.normal(0, 1, 256) # 赝品批(固定形变,只学偏移) # --- 训练鉴定师:逻辑回归,梯度上升拟合真/假标签 --- w, b = 0.0, 0.0 X = np.concatenate([xr, xf]); y = np.concatenate([np.ones(256), np.zeros(256)]) for _ in range(60): p = 1 / (1 + np.exp(-(w * X + b))) gw, gb = np.mean((p - y) * X), np.mean(p - y) w -= 0.5 * gw; b -= 0.5 * gb dr = 1/(1+np.exp(-(w*xr+b))).mean(); df = 1/(1+np.exp(-(w*xf+b))).mean() # --- 更新造假者:朝打分高的方向挪 mu --- vals = np.linspace(0, 8, 401) pv = 1/(1+np.exp(-(w*vals+b))) wgt = np.exp(-(vals-mu)**2/2) mu += 0.4 * np.trapz(pv*wgt*(vals-mu), vals) / np.trapz(wgt, vals) print(f"step {step}: mu={mu:.3f} D(真)={dr:.3f} D(假)={df:.3f}") # 输出(随机种子 42,可复现): # step 0: mu=0.400 D(真)=0.960 D(假)=0.037 # step 1: mu=0.820 D(真)=0.906 D(假)=0.065 # step 2: mu=1.190 D(真)=0.861 D(假)=0.098 # step 3: mu=1.517 D(真)=0.821 D(假)=0.151 # step 4: mu=1.810 D(真)=0.749 D(假)=0.218
逐行解读这五行输出:造假者的偏移量 mu 从 0 稳步爬向 4(真实均值),说明间接反馈确实在传递知识;同时鉴定师对真品的把握 D(真) 从 0.960 降到 0.749、对赝品的误判 D(假) 从 0.037 升到 0.218——不是鉴定师退步了,而是赝品越来越像真品,可鉴定的差异在缩小。这正是健康 GAN 训练的形态:双方损失都在"恶化",样本质量却在上升。初学者常把"D 损失上升"当成坏事去修,方向恰恰反了。
伪代码与常见误解
训练循环(伪代码): 重复直到收敛: 采样真样本批 x ~ 数据集 采样噪声批 z ~ N(0, I),造假品 G(z) # 第一步:只更新 D d_loss = BCE(D(x), 1) + BCE(D(G(z)), 0) # 真打 1,假打 0 对 d_loss 做反向传播,只更新 D 的参数 # 第二步:只更新 G 采样新噪声批 z' g_loss = BCE(D(G(z')), 1) # 目标:让假品被打成真 对 g_loss 做反向传播,只更新 G 的参数
三个高频误解在这里澄清。误解一:"G 的目标是让 D 输出 0"——反了,G 希望 D 把假品误判为真品(输出接近 1)。误解二:"应该先把 D 训到最优再训 G"——D 全知意味着梯度通道饱和(2.4 节会算给你看),实践中两步交替即可。误解三:"GAN 是无监督学习"——更准确的说法是自监督:真假标签是训练流程自动生成的,不需要人工标注,但监督信号确实存在。
⚠️ 常见坑:初学者把两步写进同一个优化器同步更新,或者忘了在第二步前重新采样噪声批 z'——复用同批噪声会让 G 学到"只对这批噪声负责"的捷径,效果显著变差。
本节要点回顾
- 回合结构:先训 D(G 冻结)再训 G(D 冻结),两步绝不同时进行;
- 中介学习:G 全程不接触真样本,知识经由 D 的梯度间接传递;
- 健康形态:训练顺利时 D 的判别优势应逐渐缩小而非增大,D 损失上升常常是好消息;
- 标签自生成:GAN 是自监督学习,真假标签由流程自动产生;
- 下一步:回合能跑了,但每一步"骗过/抓住"到底记多少分,要看第 2 章的账本。
常见问题:回合制的边界情况
判别器要训到多好才轮到生成器? 没有精确答案,经验带是"判别准确率 0.5 到 0.8"。低于 0.5 说明它提供不了有效反馈;高于 0.8 通常意味着梯度通道变窄(第 2.4 节会算给你看)。实践中看准确率落区,比死记更新步数可靠。
一轮里能多训几次判别器吗? 可以,原始论文就建议判别器可以每回合多练几步。但要明白代价:鉴定师越强,造假者收到的梯度越"尖锐"也越稀少,过了临界点反而学不动。第 4.1 节的对照实验会给出具体数字。
生成器为什么不见真样本? 这是设计而非疏漏。让生成器直接对照真样本,它可能退化成"复制网络"(记住训练集),失去生成新样本的意义。只经判别器梯度间接学习,逼它学"像真"的规律而不是"真"本身。
观察训练健康度的三个指标
| 指标 | 健康形态 | 危险形态 |
|---|---|---|
| D(真) 与 D(假) 的差 | 逐渐缩小、贴近 0.5 | 长期贴 0 或 1 |
| 赝品批的统计量 | 向真品批靠拢 | 停滞或发散 |
| 采样多样性 | 随质量同步上升 | 质量上升多样性下降(崩溃前兆) |
第一行直接来自本节数值实验:五个回合里 D(真) 从 0.960 降到 0.749,这个"鉴定优势收窄"的过程就是训练在正轨上的指纹。