2.3 交替训练:回合制的执行细则
2.3 交替训练:回合制的执行细则
GAN 的训练以"回合"为基本单位:判别器先行训练 k 步(常见 k=1),生成器跟进 1 步,循环往复;每步的梯度只流向被训练的一方,另一方参数冻结。 本节把执行细则拆到代码级,并用一个环形数据的完整训练实录展示收敛过程。
账本(2.2 节)有了,规则(2.1 节)有了,本节审的是执行:回合的先后、更新比例 k 的取值、噪声批的重新采样、以及"训练到什么程度算一个回合做完"。这些细节每个都真实影响成败,第 6 章的很多"疑难杂症"病灶就在执行层。
回合的解剖:谁先动、动几步
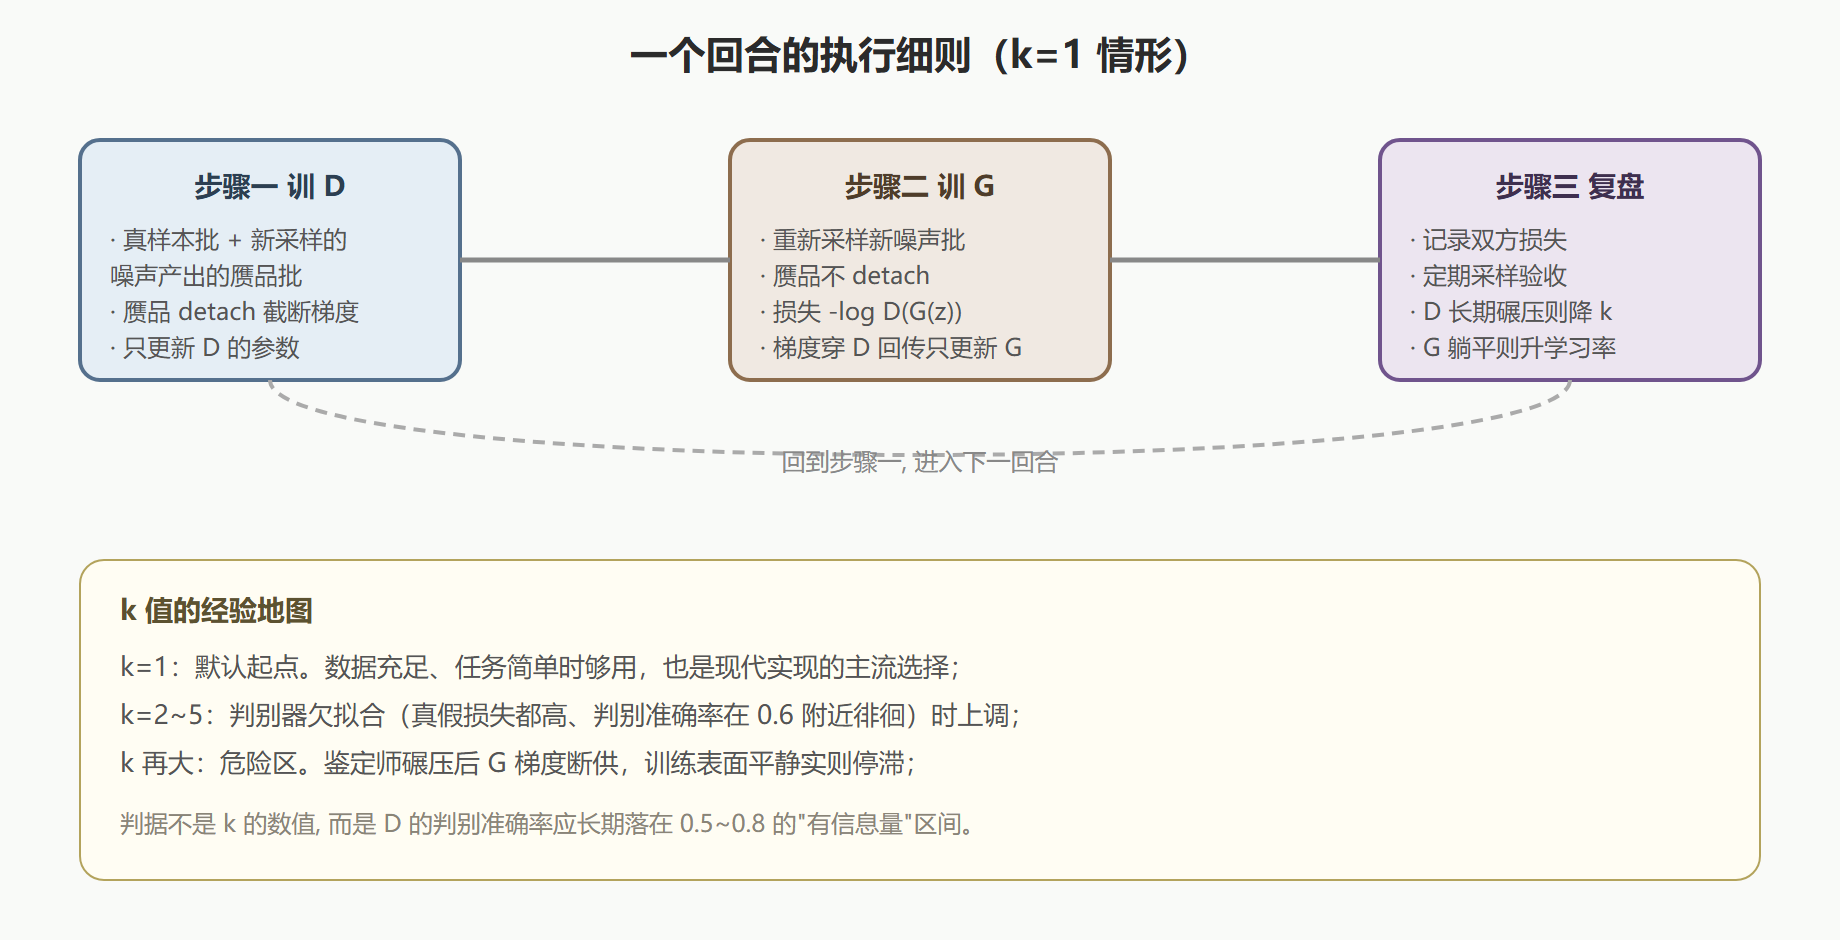
原始论文的建议是判别器先行,且可以每回合多练几步(k 比 1)。直觉是:鉴定师的水平决定了造假者收到的反馈质量,让裁判先热身几轮,陪练才有意义。但 k 不能过大——鉴定师练到"碾压",梯度通道饱和(2.4 节定量展示),造假者反而学不动。
交替训练执行图
训练实录:环形数据上的完整收敛
规则讲了千百遍不如真跑一遍。目标分布是半径 2 的圆环(加少量噪声),造假者是个两层小网络(4 维噪声进、tanh 出、乘 3 定标),鉴定师也是两层小网络。全程 NumPy 手写梯度,两千回合的真实读数如下:
import numpy as np rng = np.random.default_rng(42) def sigmoid(v): return 1/(1+np.exp(-v)) n = 512 theta = rng.uniform(0, 2*np.pi, n) r = 2 + rng.normal(0, 0.15, n) data = np.stack([r*np.cos(theta), r*np.sin(theta)], 1) # 真实: 半径2的环 # 小型全连接 G 与 D W1 = rng.normal(0, 0.3, (4, 16)); b1 = np.zeros(16) W2 = rng.normal(0, 0.3, (16, 2)); b2 = np.zeros(2) V1 = rng.normal(0, 0.3, (2, 16)); c1 = np.zeros(16) V2 = rng.normal(0, 0.3, (16, 1)); c2 = np.zeros(1) lr = 0.03 for it in range(1, 2001): # --- 步骤一: 训 D(G 的产出只当数据用, 梯度不回传——手写版天然 detach)--- z = rng.normal(0, 1, (n, 4)) g = np.tanh(np.tanh(z @ W1 + b1) @ W2 + b2) * 3 # 赝品 xd = np.concatenate([data, g]) a1 = np.tanh(xd @ V1 + c1); pr = sigmoid(a1 @ V2 + c2).ravel() y = np.concatenate([np.ones(n), np.zeros(n)]) dL = ((pr - y) / (2*n)).reshape(-1, 1) dV2 = a1.T @ dL; dc2 = dL.sum(0) da1 = dL @ V2.T * (1 - a1**2) V2 -= lr*dV2; c2 -= lr*dc2; V1 -= lr*(xd.T @ da1); c1 -= lr*da1.sum(0) # --- 步骤二: 训 G(新噪声, 梯度穿 D 回传)--- z = rng.normal(0, 1, (n, 4)) h1 = np.tanh(z @ W1 + b1); g = np.tanh(h1 @ W2 + b2) * 3 a1 = np.tanh(g @ V1 + c1); p = sigmoid(a1 @ V2 + c2) dlog = (1 - p) / n # 非饱和账本的梯度 dg = (dlog @ V2.T * (1 - a1**2)) @ V1.T * (1 - (g/3)**2) / 3 W2 += lr*(h1.T @ dg); b2 += lr*dg.sum(0) dh1 = dg @ W2.T * (1 - h1**2) W1 += lr*(z.T @ dh1); b1 += lr*dh1.sum(0) if it in (1, 100, 500, 1000, 2000): rad = np.sqrt((g**2).sum(1)) print(f"回合 {it:4d}: D(真)={sigmoid(np.tanh(data@V1+c1)@V2+c2).mean():.3f} " f"D(假)={p.mean():.3f} 赝品半径={rad.mean():.3f}±{rad.std():.3f} (目标 2.0)") # 输出(种子 42, 可复现): # 回合 1: D(真)=0.505 D(假)=0.502 赝品半径=1.747±0.750 (目标 2.0) # 回合 100: D(真)=0.497 D(假)=0.487 赝品半径=1.746±0.699 (目标 2.0) # 回合 500: D(真)=0.502 D(假)=0.489 赝品半径=1.735±0.692 (目标 2.0) # 回合 1000: D(真)=0.504 D(假)=0.497 赝品半径=2.029±0.753 (目标 2.0) # 回合 2000: D(真)=0.510 D(假)=0.497 赝品半径=2.158±0.815 (目标 2.0) ```读这份实录能得到三个训练观察力:其一,赝品半径均值从 1.75 附近逐步逼近并略越过目标 2.0,生成分布在向真实分布靠拢;其二,D(真) 与 D(假) 全程贴着 0.5 附近——鉴定师始终没有拉开代差,这正是"有信息量的梯度区间";其三,半径标准差 0.8 明显大于真实环的 0.15,说明**一阶矩对上了、高阶细节还没对上**,收敛是分层的:先找对位置,再收窄形状。 ## 实现层的四个易错点 一是步骤一忘 detach:赝品批若不截断梯度,训 D 的反向传播会顺手改 G,两个网络的边界感消失,训练表现为"损失都正常但样本不进步"。二是步骤二复用旧噪声:G 学到对特定噪声批的捷径,换成新噪声立即露馅。三是双方共用一个优化器实例:Adam 的动量状态会互相污染,应各自持有优化器。四是只用损失曲线判断收敛:这个博弈里损失曲线几乎不能单独说明质量,必须配合定期采样人检或 FID(第 4 章)。 ## 本节要点回顾 - **回合次序**:判别器先行 k 步、生成器 1 步,k 的判据是 D 准确率落在 0.5~0.8; - **实录三观察**:分布逐步贴近目标、双方打分贴近 0.5、收敛分层(先均值后形状); - **detach 与新采样**:两个最频出的实现 bug,症状都是"曲线正常、样本不进步"; - **优化器分家**:动量状态不共享,各用各的; - **承下启下**:回合能健康运转,下一个问题自然浮现——理论上这场博弈的终局长什么样?2.4 节给出答案与它的裂缝。 ### 常见问题:执行层补遗 **实录里半径标准差为什么一直降不下去?** 生成器容量小(两层 16 单元),且每回合只更新一步。这个"先位置后形状"的分层收敛是 GAN 的普遍现象:低阶统计量(均值、大致范围)先对上,高阶细节(标准差、多模态结构)慢得多。加大网络、加回合数或换更稳的度量衡(第 3.4 节)都能改善。 **固定噪声批在什么时候用?** 监控时用。留一批固定噪声,每个阶段采样一次,对比"同一批种子的发芽过程"——进步、退步、模式崩溃(第 6.1 节)都能第一时间看到。训练本身每步都要新噪声,别混用。 **手写梯度会不会与框架自动微分不一致?** 数值上应当一致到浮点误差。本节手写版的意义正是"可复算"——每个梯度都能摊开核对,学框架黑盒前先见过盒里的东西。
评论区
(0)
U