2.4 纳什均衡与理想终局
2.4 纳什均衡与理想终局
GAN 的理论终局是一个纳什均衡:最优判别器形如 D = p_data / (p_data + p_g),当生成分布 p_g 与真实分布 p_data 完全重合时 D 恒为 0.5,此时博弈价值函数等于 JS 散度,而 JS 散度在分布支撑不重叠时是常数——梯度消失的理论根源。** 本节完成从最优判别器推导到 JS 饱和数值实验的最后一环。
审讯室压轴一案。前三案把规则、账本、回合都立住了,本节回答终极问题:这场博弈理论上会停在哪?答案很美(一个解析的最优判别器 + 一个分布重合的均衡),裂缝也很深(通往均衡的梯度在支撑不重叠时是常数零)。这条裂缝是第 3 章 WGAN 翻案的全部动机。
最优判别器:一阶条件的直接产物
固定生成器 G,问"什么样的 D 让 V(D, G) 最大"。对 D(x) 求导置零,得到解析解:
D(x) = p_data(x) / (p_data(x) + p_g(x))*
读法:某点上真品密度占真假总密度的比例,就是最优打分。真品密度远高于赝品处打接近 1,两者相当处打 0.5,赝品占优处打低分。用几个数值体会它的行为:
for pd, pg in [(0.8, 0.2), (0.6, 0.2), (0.5, 0.5), (0.7, 0.0), (1.0, 1.0)]: print(f"p_data={pd}, p_g={pg} -> D*={pd/(pd+pg):.4f}") # 输出: # p_data=0.8, p_g=0.2 -> D*=0.8000 # p_data=0.6, p_g=0.2 -> D*=0.7500 # p_data=0.5, p_g=0.5 -> D*=0.5000 # p_data=0.7, p_g=0.0 -> D*=1.0000 # p_data=1.0, p_g=1.0 -> D*=0.5000
两组读数值得记住:生成分布"追平"真实分布的点,最优打分恰是 0.5(与 2.3 节实录里 D(真)≈0.5 的健康形态呼应);生成分布完全缺席的点,最优打分是 1——鉴定师在这类点上绝对自信,而绝对自信正是梯度灾难的现场。
把 D* 代回 V 并化简,得到著名的结论:最优判别器下,博弈等价于最小化 2·JS(p_data ‖ p_g) − log 4。也就是说,造假者面对最优裁判时,它真正在优化的距离是 JS 散度。问题在于 JS 这把尺子有个怪脾气。
JS 散度的饱和:数值实验
JS 散度衡量两个分布的差异,但它在"支撑不重叠"时会饱和到 log 2 ≈ 0.693 的常数。两条正态曲线,一条固定在 0,另一条逐渐挪远,JS 的读数如下:
import numpy as np def js_gauss(shift, n=200001): x = np.linspace(-15, 15, n) p = np.exp(-x**2/2) / np.sqrt(2*np.pi) q = np.exp(-(x-shift)**2/2) / np.sqrt(2*np.pi) m = 0.5 * (p + q) kl = lambda a, b: np.trapz(a*np.log(np.maximum(a, 1e-300) / np.maximum(b, 1e-300)), x) return 0.5*kl(p, m) + 0.5*kl(q, m) for d in [0.5, 1.0, 2.0, 4.0, 8.0]: print(f"两条正态相距 {d}: JS={js_gauss(d):.4f} nats | " f"同场景的 W1 距离={d:.1f}") # 输出: # 两条正态相距 0.5: JS=0.0303 nats | 同场景的 W1 距离=0.5 # 两条正态相距 1.0: JS=0.1114 nats | 同场景的 W1 距离=1.0 # 两条正态相距 2.0: JS=0.3368 nats | 同场景的 W1 距离=2.0 # 两条正态相距 4.0: JS=0.6327 nats | 同场景的 W1 距离=4.0 # 两条正态相距 8.0: JS=0.6931 nats | 同场景的 W1 距离=8.0
JS 饱和曲线与 W1 的对比
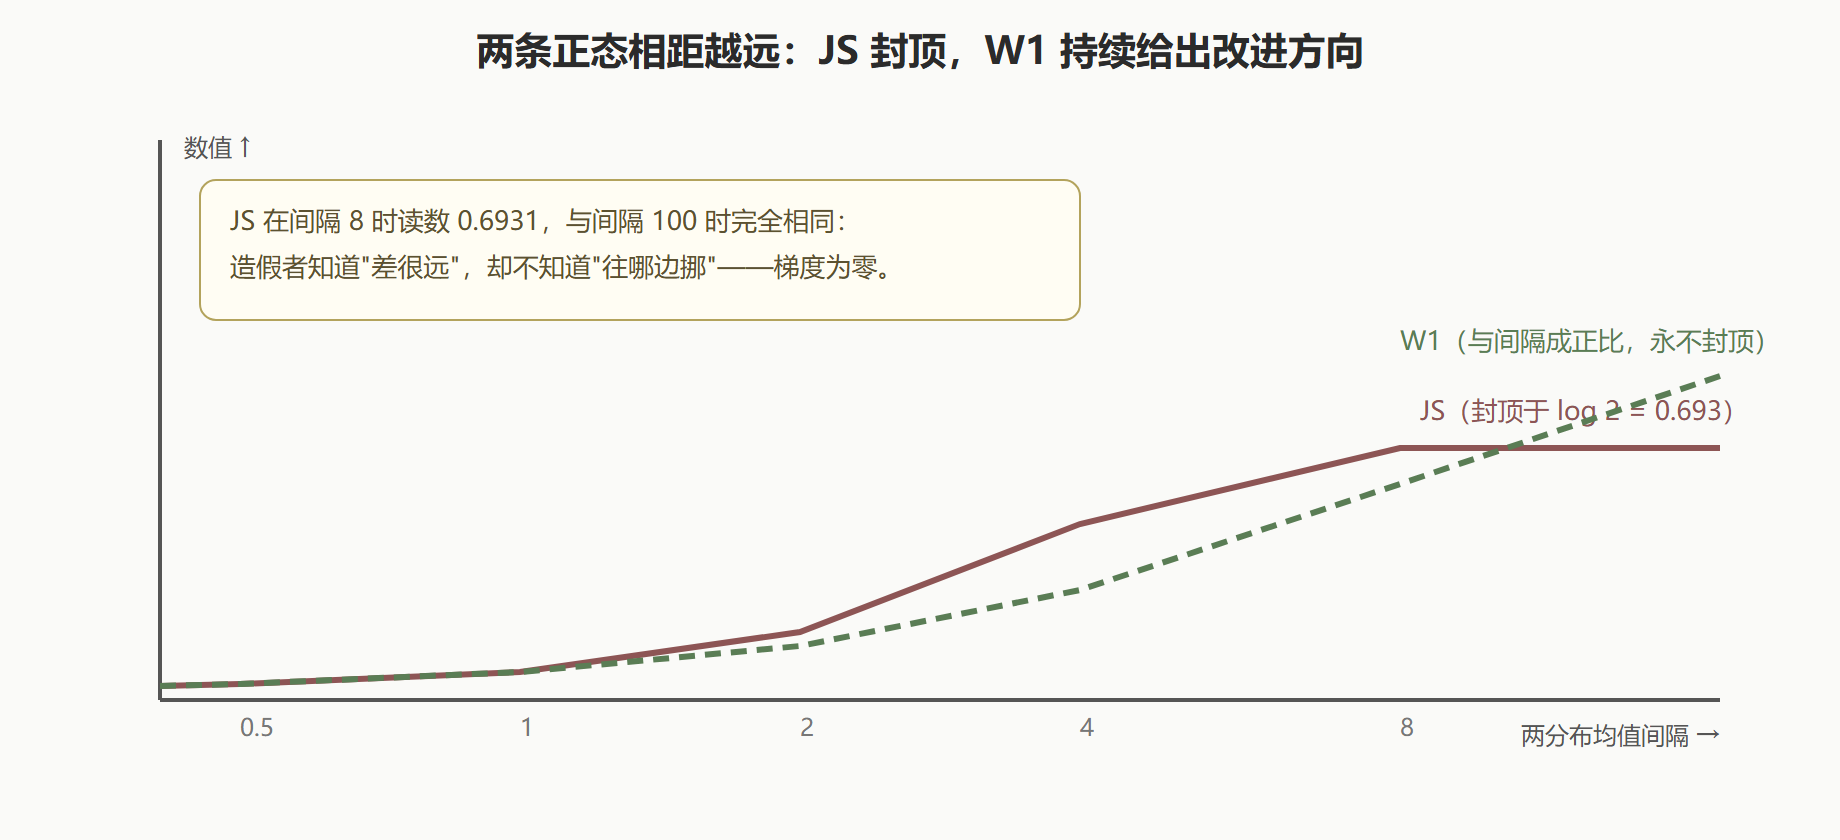
实验读数触目惊心:间隔从 4 拉到 8,JS 只从 0.6327 挪到 0.6931,之后再拉远读数纹丝不动;而 W1(Wasserstein 距离,两个均值差就是它的下界)始终与间隔成正比。这就是"梯度断供"的数学本体:JS 的曲面在高维不重叠的分布之间是一片平原,平原上没有下坡方向。图像生成恰恰是高维低维流形场景,支撑不重叠是常态而非例外——原始 GAN 开局即陷入平原,全靠非饱和改写的梯度和幸运的初始化续命。
理想终局的画像
把均衡态完整画出来:p_g = p_data 处处成立;D* 处处为 0.5;V 取全局最小值 −log 4;双方都没有单方面改动的动机——纳什均衡成立。与工程现实对照三点:
| 均衡态预言 | 工程现实 | 差距的解释 |
|---|---|---|
| D 输出恒 0.5 | D 输出在 0.5 附近波动 | 策略是连续参数,绕均衡震荡(2.1 节无鞍点矩阵的同款现象) |
| p_g 精确重合 | 大方向重合、细节缺失 | 收敛分层:先粗后细,细节收敛极慢 |
| 无单方改动动机 | 周期性"复发" | 批量采样的梯度噪声让系统在均衡附近随机游走 |
⚠️ 常见坑:见到 D 损失趋近 −log 4 附近且 G 损失同步平稳,就宣布收敛。这只是均衡的必要观察,不是充分证据——模式崩溃(第 6.1 节)时损失形态同样健康,必须采样人检或算 FID。
本节要点回顾
- 最优判别器 D* = p_data/(p_data + p_g),是 V 的一阶条件解;分布重合处打 0.5;
- 等价目标:最优 D 下博弈价值正比于 JS 散度,造假者实际在最小化 JS;
- 饱和实验:正态间隔 4→8,JS 仅 0.633→0.693 后封顶,梯度平原由此而来;
- W1 的启示:与间隔成正比、永不封顶——换这把尺子就是第 3.4 节 WGAN 的全部动机;
- 均衡三落差:震荡、细节缺失、随机游走,理论终局是灯塔不是码头。
常见问题:均衡与散度
JS 饱和为什么在图像任务里尤其致命? 图像分布集中在高维空间的低维流形上,两个低维流形几乎必然支撑不重叠——正态实验里"间隔 8 就封顶"的场景在高维是常态。也就是说,开局时生成器几乎注定站在梯度平原上。
W1 为什么不会饱和? 它度量的是"搬运代价",分布隔多远代价就多大,没有上限——平坦的平原变成了匀速的坡道。第 3.4 节的排序配对实验会给出它的一维精确算法。
均衡点达到后训练该停吗? 理论上该停,实际上你永远不确定自己到了。批量梯度噪声让系统在均衡附近随机游走,损失形态与均衡态的区别小到难以分辨。工程上靠验收指标(第 4.2 节)与人工抽查定停机,不靠损失曲线。
常见问题:散度家族速记
除了 JS 还有别的散度,为什么偏偏它出问题? KL 与 JS 都属于 f 散度家族,共同点是"只有当两个分布的支撑重叠时才连续"——不重叠时要么无穷(KL)要么常数(JS),都给不出梯度。Wasserstein 距离不属于这个家族,它度量的是几何搬运代价,与支撑是否重叠无关。一句话记忆:f 散度看"密度比值",W 距离看"搬家距离"。
均衡态的价值函数值是多少? 负 log 4,约负 1.386。这个数字可以当训练日志的参考锚点:判别器目标长期显著高于它,说明两个分布还没接近;但注意它只是必要条件,模式崩溃时(第 6.1 节)损失形态同样可以很"像"均衡。