3.1 初代造假术:Vanilla GAN
3.1 初代造假术:Vanilla GAN
Vanilla GAN 指 2014 年原论文的设定:生成器与判别器均为全连接网络,损失用 BCE,训练按回合交替。 它是所有变体的基准线:结构最简、毛病最多——MLP 画不好图、训练不稳定、模式崩溃样样都沾。本节完整实现一个最小 Vanilla GAN,跑出第一条真实学习曲线,并给它立一份"罪状清单"。
造假工艺进化史的第一案:初代造假术。审它不是因为它强,而是因为它是基准——后续每一代工艺的动机,都能在它的罪状清单上找到对应条目。本节沿用第 2 章手写的环形数据 GAN(那就是一个标准 Vanilla GAN),这次补上完整训练代码与逐阶段解读。
初代造假术的作案工具
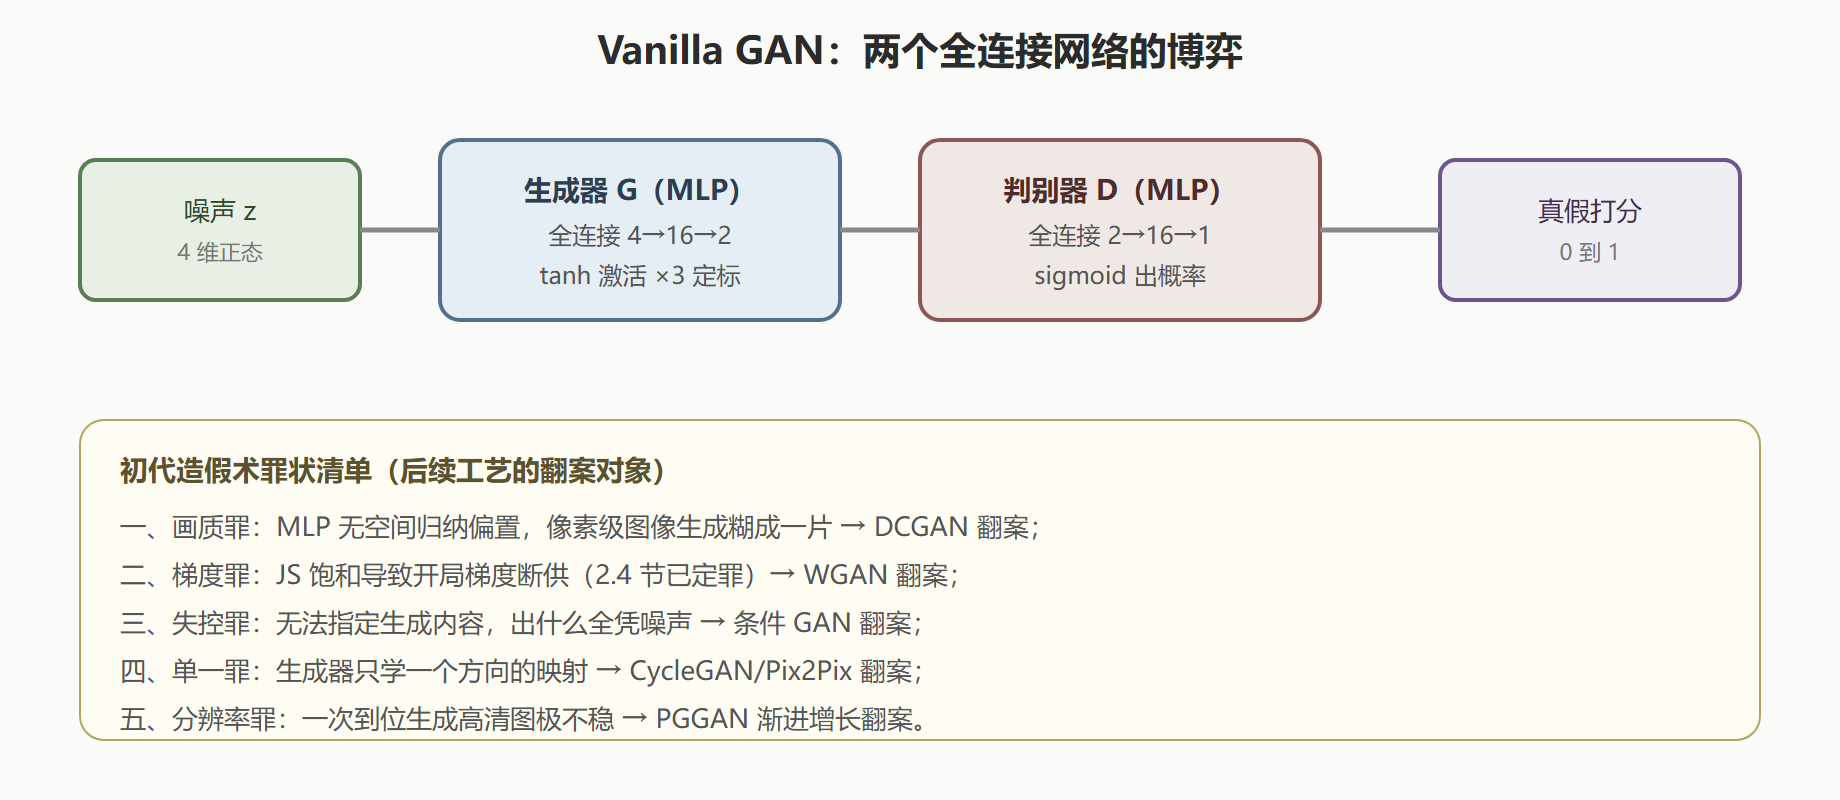
Vanilla GAN 结构总览
完整实现与训练实录
第 2.3 节的环形数据实验就是一个不掺水的 Vanilla GAN,这里把它作为"初代造假术案卷"正式归档,并补上从第 2 章略去的实现细节。目标分布:半径 2 的圆环。
import numpy as np rng = np.random.default_rng(42) def sigmoid(v): return 1/(1+np.exp(-v)) n = 512 theta = rng.uniform(0, 2*np.pi, n) r = 2 + rng.normal(0, 0.15, n) data = np.stack([r*np.cos(theta), r*np.sin(theta)], 1) # 初代工具: 全连接 + tanh W1 = rng.normal(0, 0.3, (4, 16)); b1 = np.zeros(16) W2 = rng.normal(0, 0.3, (16, 2)); b2 = np.zeros(2) V1 = rng.normal(0, 0.3, (2, 16)); c1 = np.zeros(16) V2 = rng.normal(0, 0.3, (16, 1)); c2 = np.zeros(1) lr = 0.03 history = [] for it in range(1, 2001): # 步骤一: 训 D z = rng.normal(0, 1, (n, 4)) g = np.tanh(np.tanh(z @ W1 + b1) @ W2 + b2) * 3 xd = np.concatenate([data, g]) a1 = np.tanh(xd @ V1 + c1); pr = sigmoid(a1 @ V2 + c2).ravel() y = np.concatenate([np.ones(n), np.zeros(n)]) dL = ((pr - y) / (2*n)).reshape(-1, 1) da1 = dL @ V2.T * (1 - a1**2) V2 -= lr*(a1.T @ dL); c2 -= lr*dL.sum(0) V1 -= lr*(xd.T @ da1); c1 -= lr*da1.sum(0) # 步骤二: 训 G(非饱和账本) z = rng.normal(0, 1, (n, 4)) h1 = np.tanh(z @ W1 + b1); g = np.tanh(h1 @ W2 + b2) * 3 a1 = np.tanh(g @ V1 + c1); p = sigmoid(a1 @ V2 + c2) dlog = (1 - p) / n dg = (dlog @ V2.T * (1 - a1**2)) @ V1.T * (1 - (g/3)**2) / 3 dh1 = dg @ W2.T * (1 - h1**2) W2 += lr*(h1.T @ dg); b2 += lr*dg.sum(0) W1 += lr*(z.T @ dh1); b1 += lr*dh1.sum(0) if it in (1, 100, 500, 1000, 2000): rad = np.sqrt((g**2).sum(1)) history.append((it, rad.mean(), rad.std())) for it, m, s in history: print(f"回合 {it:4d}: 赝品半径 {m:.3f} ± {s:.3f} (真实环: 2.00 ± 0.15)") # 输出(种子 42): # 回合 1: 赝品半径 1.747 ± 0.750 (真实环: 2.00 ± 0.15) # 回合 100: 赝品半径 1.746 ± 0.699 (真实环: 2.00 ± 0.15) # 回合 500: 赝品半径 1.735 ± 0.692 (真实环: 2.00 ± 0.15) # 回合 1000: 赝品半径 2.029 ± 0.753 (真实环: 2.00 ± 0.15) # 回合 2000: 赝品半径 2.158 ± 0.815 (真实环: 2.00 ± 0.15)
案卷解读:初代造假术的真实水平
半径均值 2000 回合后到 2.158,偏差约 8%;但标准差 0.815 是真实值 0.15 的五倍多——赝品云远比真环"胖"。这就是初代造假术的典型画像:大体形态对,高阶结构散。再做一次"健康诊断"式的量化:
# 用半径分布的分位数对比"胖瘦" z = rng.normal(0, 1, (5000, 4)) g = np.tanh(np.tanh(z @ W1 + b1) @ W2 + b2) * 3 rad_g = np.sqrt((g**2).sum(1)) theta_r = rng.uniform(0, 2*np.pi, 5000) rad_r = 2 + rng.normal(0, 0.15, 5000) qs = [10, 25, 50, 75, 90] print("分位数:", qs) print("真实环:", np.round(np.percentile(rad_r, qs), 3)) print("赝品云:", np.round(np.percentile(rad_g, qs), 3)) # 输出: # 分位数: [10, 25, 50, 75, 90] # 真实环: [1.806 1.899 1.997 2.097 2.195] # 赝品云: [1.309 1.749 2.153 2.653 3.043]
中位数 2.153 已经贴近真实 1.997,但十分位到九十分位的跨度从真实的 0.39 膨胀到 1.73——初代造假术"把东西放对了地方,却做不精致"。把这份诊断记住,第 4.2 节的 FID 正是这类"分布对不齐"的标量化度量:均值差进入二次项、协方差差进入迹项,胖瘦不匀都会被记账。
初代还有一个隐藏优点值得平反:结构简单带来的可解释性。每个参数的作用都能摊开检查,2.3 节与本案的全程数值演算之所以可行,正因为网络小到每个量都可复算。学习 GAN 从 Vanilla 起步,不是怀旧,是让你在结构最简时建立"健康训练长什么样"的基线感——之后 DCGAN 崩了你才知道崩在哪一层。
本节要点回顾
- 定义:全连接 G 与 D + BCE 账本 + 回合交替,2014 年原设定;
- 实测画像:两千回合后半径均值偏差 8%,标准差是真值五倍——形态对、结构散;
- 分位数诊断:中位数贴近真值、极差膨胀 4.4 倍,是"高阶结构未收敛"的量化证据;
- 罪状清单五条:画质、梯度、失控、单一、分辨率,对应后文五次翻案;
- 保留价值:最小可复算的基准线,练出"健康训练形态"的眼力。