3.2 卷积工坊:DCGAN 与图像生成
3.2 卷积工坊:DCGAN 与图像生成
DCGAN(深度卷积 GAN)把生成器与判别器全部换成卷积结构:生成器用转置卷积逐级上采样,判别器用带步幅卷积逐级下采样,并配上一整套"稳定守则"(批归一化、特定激活、去全连接层、优化器参数)。 它是 GAN 从玩具走向图像生成的第一次跨越,其结构守则影响至今。
翻案第二桩:画质罪。初代 MLP 造假者画图像时,每个像素独立对待,画出来的东西糊成一片。2016 年的 DCGAN 拿出卷积这套空间归纳偏置的工具箱,配合一份训练守则,把 64×64 的卧室图与人脸生成做到了"能看"的水准。本节拆工具、验尺寸、抄守则。
工具箱盘点:转置卷积如何"放大"图像
生成器的核心动作是上采样:把 4×4 的小特征图放大成 64×64 的图。转置卷积(核 4、步幅 2、填充 1)的输出尺寸是 (输入−1)×2+2,恰好边长翻倍。用 NumPy 模拟一维情形看清它的机制:
import numpy as np # 一维转置卷积直觉演示: 输入 3 点, 核 4 点, 步幅 2 x = np.array([1.0, 2.0, 3.0]) # 小特征图 k = np.array([0.5, 1.0, 1.0, 0.5]) # 可学习核 out_len = (len(x) - 1) * 2 + 4 - 2*1 # 公式: (in-1)*s - 2p + k = 4 out = np.zeros(out_len) for i, xi in enumerate(x): # 每个输入点把自己的核"印"到输出画布 out[i*2 : i*2+4] += xi * k print("输入:", x, "长度 3 -> 输出:", out, "长度", out_len) # 输出: 输入: [1. 2. 3.] 长度 3 -> 输出: [0.5 1.5 3.5 3.5 3. 1.5] 长度 4 # 相邻输入的核印迹重叠处数值叠加, 这就是"可学习的上采样"
重叠处的叠加正是转置卷积的可学习之处:普通插值只会固定混合,转置卷积让网络自己学"怎么放大"。棋盘伪影(相邻印迹不均匀造成的格纹)是它的职业病,守则里"核 4 步 2 填 1"的搭配正是为了让印迹均匀重叠、把伪影压到最低。
DCGAN 全家福与体格核算
DCGAN 双方结构对照
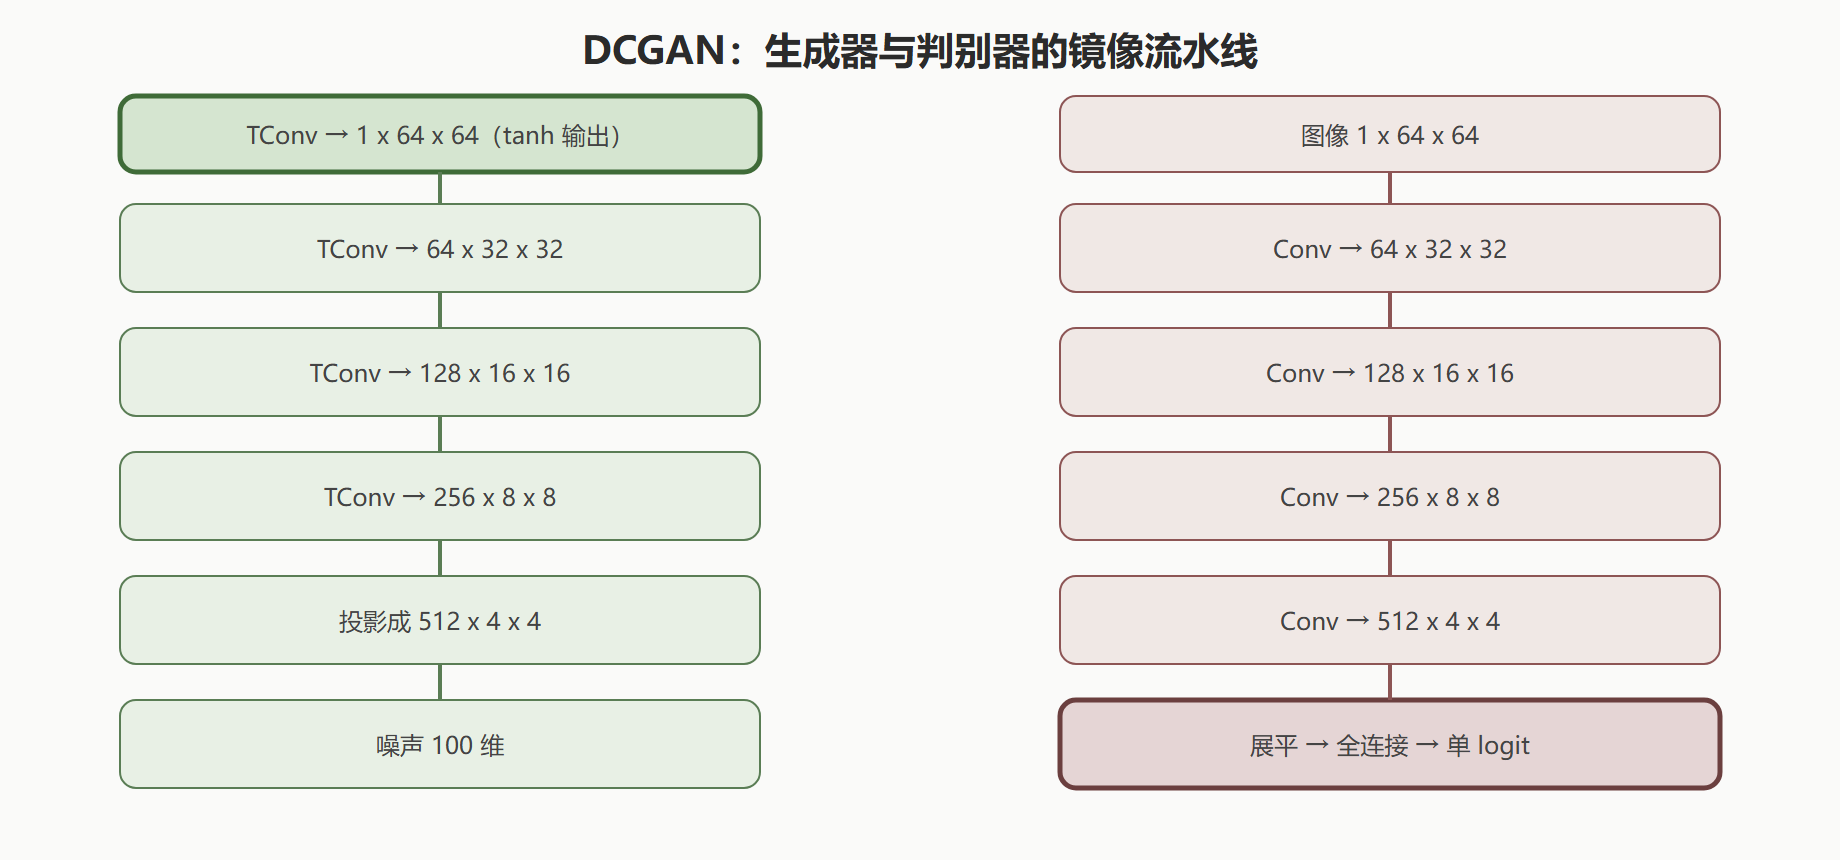
体格核算(1.3 节档案的延伸):生成器五层合计约 357 万参数,判别器四层卷积约 275 万加收尾全连接约 82 万,双方体格对称。这里再核一遍关键层的账并观察参数分布:
# 生成器各层参数占比 layers = [("投影 100→512x4x4", 100*512*16 + 512), ("TConv 512→256", 512*256*16 + 256), ("TConv 256→128", 256*128*16 + 128), ("TConv 128→64", 128*64*16 + 64), ("TConv 64→1", 64*1*16 + 1)] total = sum(p for _, p in layers) for name, p in layers: print(f"{name:16s}: {p:>10,} 参数 占比 {p/total*100:5.1f}%") print(f"{'合计':16s}: {total:>10,}") # 输出: # 投影 100→512x4x4 : 819,712 参数 占比 22.9% # TConv 512→256 : 2,097,408 参数 占比 58.7% # TConv 256→128 : 524,416 参数 占比 14.7% # TConv 128→64 : 131,136 参数 占比 3.7% # TConv 64→1 : 1,025 参数 占比 0.0% # 合计 : 3,573,697
参数重心落在第二层(512 通道到 256 通道的转置卷积占近六成)——通道数高的层参数贵,这是卷积工坊的经济学:想省参数先砍通道,想提质量先加通道。
稳定守则:DCGAN 论文的另一半贡献
DCGAN 常被记住的是卷积结构,但让训练真正稳定下来的是那份守则清单。逐条注明动机:
| 守则 | 内容 | 动机 |
|---|---|---|
| 归一化 | G 与 D 的中间层全用批归一化 | 平滑损失曲面,缓解梯度病 |
| 激活 | G 隐层用 ReLU、输出用 tanh;D 用 LeakyReLU(斜率 0.2) | 防死区;tanh 压像素范围 |
| 池化 | 用带步幅卷积替代最大池化 | 让下采样位置可学习 |
| 全连接 | 去掉深层的全连接层 | 减参数、稳训练 |
| 优化器 | Adam,学习率 0.0002,动量项 0.5 | 动量过高会震荡(默认 0.9 反而糟) |
最后一条最容易踩:Adam 的默认动量 0.9 在 GAN 上经常引起震荡,DCGAN 明确建议压到 0.5,学习率也压到 0.0002 量级。这些数字不是玄学,是大量实验换来的"低压区"。
⚠️ 常见坑:照抄 DCGAN 结构但用了默认 Adam 参数,训练几千步后损失开始剧烈震荡。先把动量改 0.5、学习率减半,再排查其他原因——这是最快的一刀。
本节要点回顾
- 翻案对象:MLP 画质罪;手段是卷积的空间归纳偏置与逐级上采样;
- 转置卷积机制:每个输入点把可学习核"印"到画布,重叠处叠加;核 4 步 2 填 1 是防棋盘伪影的搭配;
- 参数经济学:约 357 万参数中近六成在第二层,通道是参数大头;
- 守则五条:批归一化、混合激活、步幅卷积、去全连接、低压 Adam(0.0002/0.5);
- 延伸:守则没解决的梯度罪留给 WGAN(3.4 节),分辨率罪留给 PGGAN(3.6 节)。
常见问题:工具箱实操
为什么生成器输出用 tanh、判别器不用? tanh 把像素压进正负 1 的范围,配合训练数据缩放(第 4.3 节),保证生成值的数值稳定;判别器输出的是概率,最后一层用 sigmoid(或直接输出 logit 配合带 logits 的损失函数),中间层用 LeakyReLU 就够。
批归一化两边的用法一样吗? 不一样。生成器全层可用;判别器传统做法也是全层,但后来发现批量统计会泄露批内信息(一个样本能"感觉"到同批的其他样本),有些改法只在生成器用或换成实例归一化。守则要按年代读:DCGAN 时代全用,现代实现有更多选项。
64 乘 64 之外怎么扩展? 尺寸链按二倍生长:128 加一级转置卷积、256 再加一级,通道相应调整。但直接堆层数不是免费午餐——分辨率每翻倍,训练稳定性压力陡增,这正是第 3.6 节渐进增长要解决的问题,别在 DCGAN 骨架上硬扛 512 以上的分辨率。
一段值得记住的历史
DCGAN 的价值一半在结构,一半在"把 GAN 训练配方标准化"——在它之前,每个人的 GAN 都是自己的一套玄学参数。守则清单让后来者能站在同一起跑线上做改进,WGAN、Pix2Pix 的论文都直接复用这套骨架。学术贡献有时候不是提出新东西,而是把混沌变成公共设施。