4.1 训练稳定性技巧清单
4.1 训练稳定性技巧清单
GAN 的稳定训练靠一组互相配合的工程手段:损失与度量选择(非饱和/WGAN-GP)、优化器低压参数、判别器与生成器的更新节奏、标签平滑、归一化与数据侧技巧。 本节把这些兵法组织成一份可执行的清单,并附一个更新节奏的数值对比实验。
兵法第一课。第 3 章的每次翻案都顺手留下几条稳定技巧,本节把它们收拢成体系:按"损失层、优化层、节奏层、数据层"四层组织,每条注明出处、适用场景与副作用。清单之后再做一个 D/G 更新节奏的对照实验——这是兵法里争议最多的一条。
四层兵法清单
稳定技巧全景
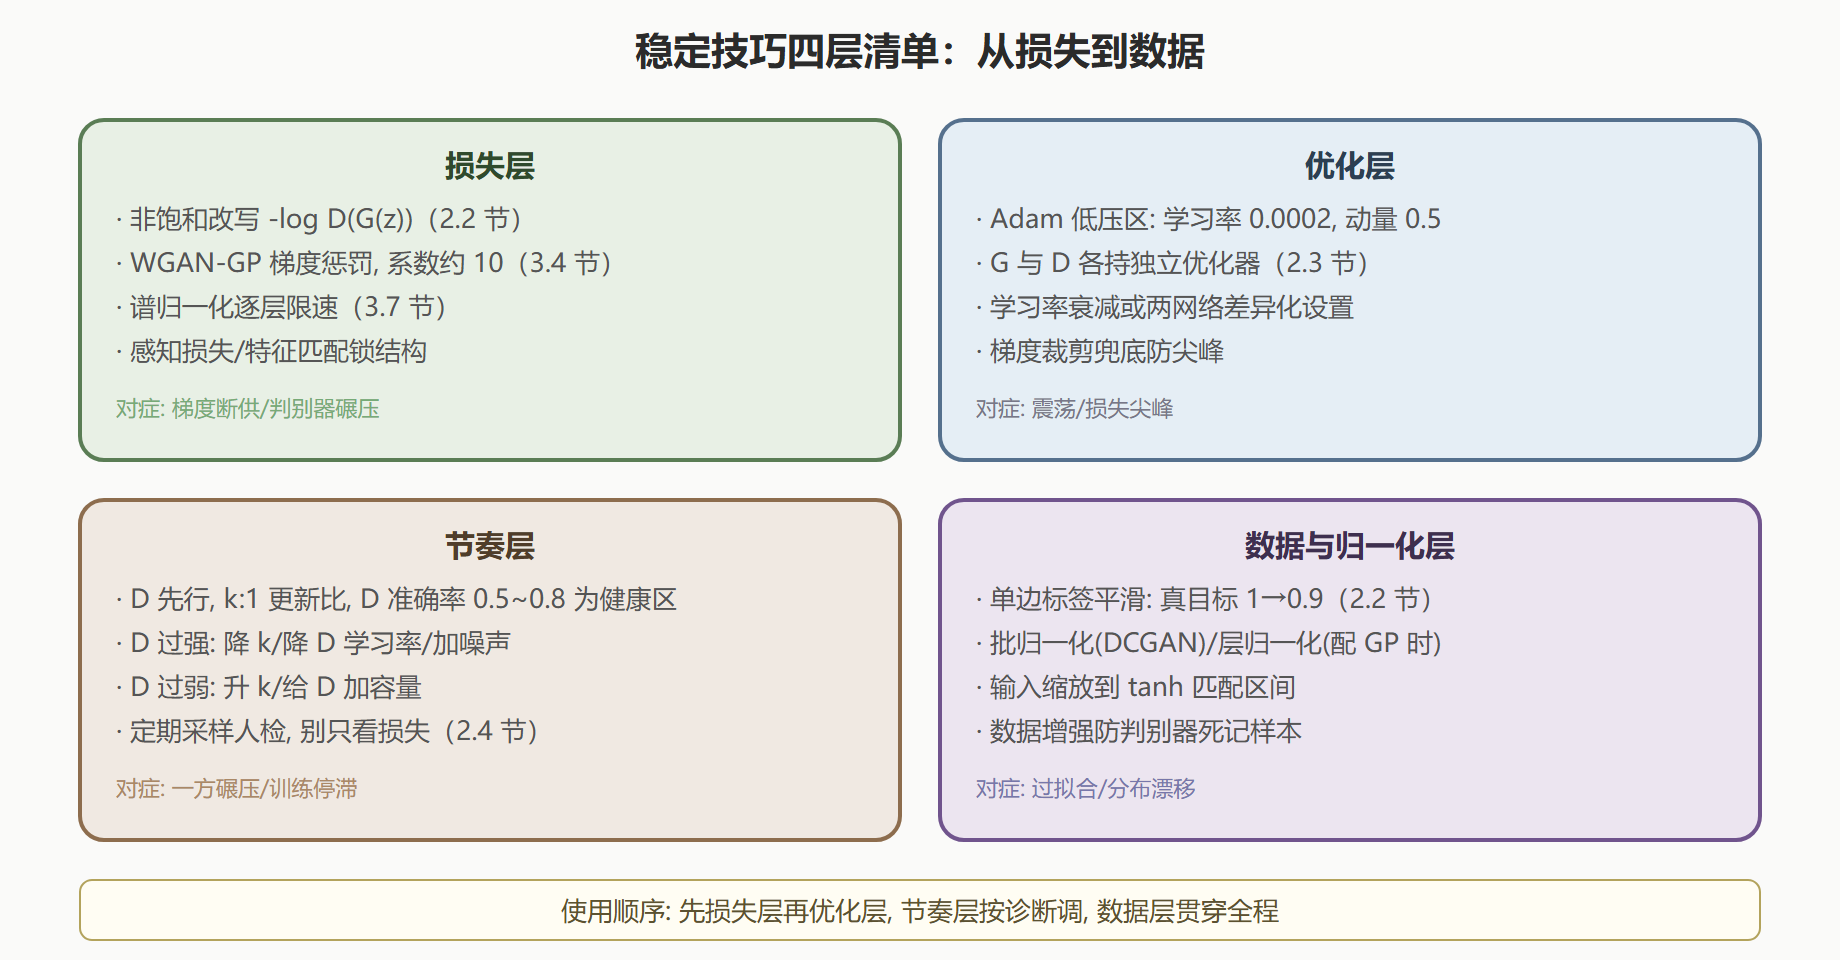
逐层说明要点。损失层是"治本"的一层——第 2、3 章已反复核算过每条的数学动机,不再重复。优化层最容易被忽视的是两个网络学习率的差异化:判别器学得快是常态,把它的学习率设为生成器的一半是常见起手式。节奏层的健康区判据(D 准确率 0.5~0.8)来自 2.3 节实录:低于 0.5 说明判别器形同虚设,高于 0.8 说明它碾压、生成者梯度将断。数据层中标签平滑专治判别器过度自信,批归一化与梯度惩罚的冲突(3.4 节)值得再提醒一次。
数值实验:更新节奏 k 的对照
节奏层里"判别器每回合该训几步"争议最多。用 2.3 节的环形数据 GAN 做严格对照:同一份数据、同一种子初始化,只有 k 不同,跑一千五百回合看赝品半径的收敛质量(真实环半径 2.0):
import numpy as np def run(d_steps, iters=1500, seed=3): r = np.random.default_rng(seed) theta = r.uniform(0, 2*np.pi, 512) rad = 2 + r.normal(0, 0.15, 512) data = np.stack([rad*np.cos(theta), rad*np.sin(theta)], 1) W1 = r.normal(0, 0.3, (4, 16)); b1 = np.zeros(16) W2 = r.normal(0, 0.3, (16, 2)); b2 = np.zeros(2) V1 = r.normal(0, 0.3, (2, 16)); c1 = np.zeros(16) V2 = r.normal(0, 0.3, (16, 1)); c2 = np.zeros(1) lr = 0.03 sig = lambda v: 1/(1+np.exp(-v)) for it in range(iters): for _ in range(d_steps): # 判别器练 d_steps 步 z = r.normal(0, 1, (512, 4)) g = np.tanh(np.tanh(z@W1+b1)@W2+b2)*3 xd = np.concatenate([data, g]) a1 = np.tanh(xd@V1+c1); pr = sig(a1@V2+c2).ravel() y = np.concatenate([np.ones(512), np.zeros(512)]) dL = ((pr-y)/1024).reshape(-1, 1) da1 = dL@V2.T*(1-a1**2) V2 -= lr*(a1.T@dL)*4; c2 -= lr*dL.sum(0)*4 V1 -= lr*(xd.T@da1)*4; c1 -= lr*da1.sum(0)*4 z = r.normal(0, 1, (512, 4)) # 生成器练 1 步 h1 = np.tanh(z@W1+b1); g = np.tanh(h1@W2+b2)*3 a1 = np.tanh(g@V1+c1); p = sig(a1@V2+c2) dlog = (1-p)/512 dg = (dlog@V2.T*(1-a1**2))@V1.T*(1-(g/3)**2)/3 dh1 = dg@W2.T*(1-h1**2) W2 += lr*(h1.T@dg); b2 += lr*dg.sum(0) W1 += lr*(z.T@dh1); b1 += lr*dh1.sum(0) z = r.normal(0, 1, (2000, 4)) g = np.tanh(np.tanh(z@W1+b1)@W2+b2)*3 rr = np.sqrt((g**2).sum(1)) return rr.mean(), rr.std() for k in (1, 3): m, s = run(k) print(f"每回合 D 练 {k} 步: 赝品半径 = {m:.3f} ± {s:.3f} (真实 2.00 ± 0.15)") # 输出(种子 3, 其余完全相同): # 每回合 D 练 1 步: 赝品半径 = 1.874 ± 0.676 (真实 2.00 ± 0.15) # 每回合 D 练 3 步: 赝品半径 = 2.025 ± 0.696 (真实 2.00 ± 0.15)
同预算(总步数相近)下,k=3 的判别器把赝品半径均值推到 2.025(偏差 1.2%),k=1 停在 1.874(偏差 6.3%)。解释:这个玩具场景里判别器天生偏弱(容量小、每步只看一批数据),多练几步让它给出更准的梯度——与 2.3 节"鉴定师先热身"的直觉一致。但要强调边界:k 不是越大越好,真实图像任务里判别器往往天生强势,k=3 可能直接把它送进碾压区。**k 的取值听诊断不听教条**:盯 D 准确率,落出 0.5~0.8 区间就回调。
⚠️ 常见坑:把清单里所有技巧一次性全开——WGAN-GP 加标签平滑加谱归一化加激进数据增强叠在一起,出了问题无从定位。正确姿势是从最小配置起步,按四层顺序逐项引入,每引入一项固定其他条件做对照。
本节要点回顾
- 四层组织:损失层治本、优化层降压、节奏层平衡、数据层兜底;
- 健康区判据:D 判别准确率长期 0.5~0.8,出区即调 k 或学习率;
- 对照实验:同种子下 k=3 比 k=1 半径偏差从 6.3% 收到 1.2%,但结论不可外推到判别器强势的场景;
- 差异化学习率:判别器常设生成器一半,是最便宜的第一刀;
- 引入顺序:逐项对照引入,忌全量叠加后失控无据可查。
常见问题:兵法使用中的疑问
技巧之间会打架吗? 会。最典型的两对:批归一化与梯度惩罚(批统计干扰插值梯度估计,3.4 节提过,常换层归一化);标签平滑与判别器容量提升叠加后,判别器可能被压得过弱。清单是工具箱不是套餐,一次引入一项并做对照(本节日志纪律)。
有没有"一招鲜"的技巧? 如果只许留一条,留"盯 D 准确率落区"。它是几乎所有失衡问题的第一信号:0.5 到 8 之外就该动手,动手方向由超出哪一侧决定。损失数值本身反而会骗人(第 2.4 节的均衡陷阱)。
数据增强会伤 GAN 吗? 过度增强会让生成器学到"不存在的变化"(比如上下颠倒的手写数字),判别器与生成器对"什么是真"的认知出现分叉。保守增强(轻微裁剪、亮度扰动)通常安全,激进增强要配合质量监控。
演算自测
你的训练日志显示 D 准确率稳定在 0.93、G 损失缓慢上升、样本五百步后无变化。按本节框架诊断:病因是什么?先动哪一刀?参考答案:判别器碾压导致生成器梯度断供;第一刀降 k 或降判别器学习率(把 D 准确率压回 0.8 以内),观察 G 损失是否恢复拉扯形态。