4.2 验收指标:IS 与 FID 的演算
4.2 验收指标:IS 与 FID 的演算
IS(Inception Score)用"单样本类别分布的自信程度"与"整体类别分布的多样程度"的 KL 散度给生成质量打分;FID(Fréchet Inception Distance)把真伪两组样本的特征分布当高斯算 Fréchet 距离,越低越像。 本节在合成数据上把两个指标亲手算一遍,并量化它们对模式崩溃与样本量的敏感度。
验收第一课。生成模型没有准确率可看:2.4 节已证明损失曲线读不出质量,肉眼鉴赏不客观也不可复现。行业最终收敛到两个自动化指标,本节各给一个能跑通的最小实现——不调用任何大模型,用合成数据把指标的行为摸透。
IS:自信且多样的账
IS 的设计思想:好生成器的样本应该单看自信(每张图能被分类器明确归类,条件分布 p(y|x) 尖锐)且整体多样(所有样本混起来的边缘分布 p(y) 均匀)。两者用 KL 散度绑在一起再取指数:
IS = exp( E_x[ KL( p(y|x) ‖ p(y) ) ] )
最小实现与崩溃实验:
import numpy as np rng = np.random.default_rng(7) def is_lite(pyx): # pyx: 每个样本的类别分布, 形状 N x 10 py = pyx.mean(0) # 边缘分布 kl = (pyx * (np.log(pyx + 1e-12) - np.log(py + 1e-12))).sum(1).mean() return np.exp(kl) # 场景一: 多样且自信 —— 1000 个样本均匀覆盖 10 类, 每个都很自信 labels = rng.integers(0, 10, 1000) diverse = np.eye(10)[labels] * 0.98 + 0.002 # 场景二: 模式崩溃 —— 全部样本挤进类别 3 collapsed = np.tile(np.eye(10)[3] * 0.98 + 0.002, (1000, 1)) print(f"多样且自信: IS-lite = {is_lite(diverse):.3f}") print(f"模式崩溃: IS-lite = {is_lite(collapsed):.3f}") # 输出: # 多样且自信: IS-lite = 8.741 # 模式崩溃: IS-lite = 1.000 # 理论上限: 完美自信 + 完美均匀 => 10 类时约等于 10 ```崩溃生成器每张图都很"自信"(分布尖锐),但边缘分布也退化成同一个尖峰,KL 项归零,IS 直接跌到 1。**IS 对模式崩溃极其敏感**——这是它的优点;缺点同样明显:它不看真数据分布,模型只要自信且类别均衡就得高分,哪怕生成的"猫"根本不像你数据集里的猫。正式实现里 p(y|x) 由 Inception 分类器在生成图像上给出,故得此名。 ## FID:两个高斯之间的距离 FID 换了个角度:把真假样本各过一遍特征提取器(正式实现用 Inception V3 的池化特征),假设两组特征各服从高斯,算两个高斯之间的 Fréchet 距离: **FID = ‖μ_r − μ_g‖² + Tr(Σ_r + Σ_g − 2(Σ_r Σ_g)^½)** 第一项罚均值错位,第二项罚形状(协方差)错位。在合成数据上完整实现并测三组对照: ```python def sqrtm_(M): # 对称正定矩阵的平方根 w, v = np.linalg.eigh(M) return v @ np.diag(np.sqrt(w)) @ v.T def fid(m1, c1, m2, c2): cm = sqrtm_(sqrtm_(c1) @ c2 @ sqrtm_(c1)) d = m1 - m2 return float(d @ d + np.trace(c1) + np.trace(c2) - 2*np.trace(cm)) # 真实分布: 四个高斯模式(二维)加噪声维, 共 16 维特征 modes = np.array([[0,0],[4,0],[0,4],[4,4]], float) def feat(k, collapse=False): idx = rng.integers(0, 4, k) pts = (modes[0] if collapse else modes[idx]) + rng.normal(0, 0.3, (k, 2)) return np.concatenate([pts, rng.normal(0, 0.05, (k, 14))], 1) Xr, Xf, Xc = feat(2000), feat(2000), feat(2000, collapse=True) print(f"真实 vs 健康生成: FID = {fid(Xr.mean(0), np.cov(Xr.T), Xf.mean(0), np.cov(Xf.T)):.2f}") print(f"真实 vs 崩溃生成: FID = {fid(Xr.mean(0), np.cov(Xr.T), Xc.mean(0), np.cov(Xc.T)):.2f}") Xo = feat(2000) + np.array([0.5] + [0]*15) # 整体偏移 0.5 print(f"真实 vs 偏移生成: FID = {fid(Xr.mean(0), np.cov(Xr.T), Xo.mean(0), np.cov(Xo.T)):.2f}") # 输出: # 真实 vs 健康生成: FID = 0.01 # 真实 vs 崩溃生成: FID = 13.93 # 真实 vs 偏移生成: FID = 0.15
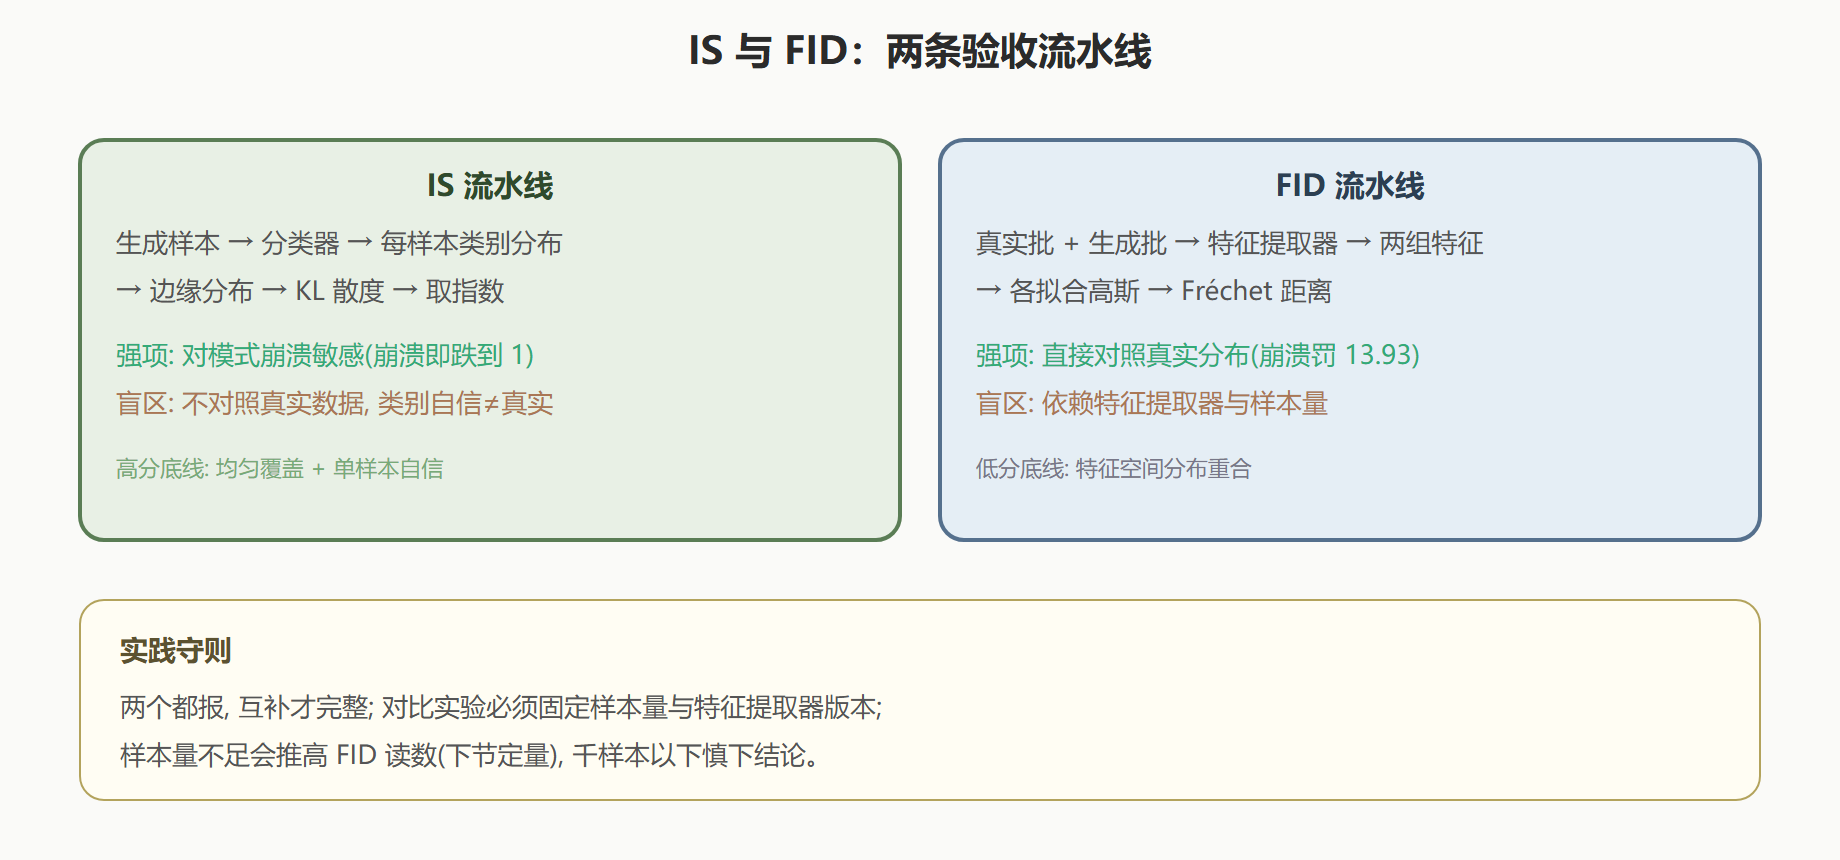
三组读数勾勒出 FID 的性格:健康生成 0.01(几乎重合);模式崩溃(丢了四分之三的模式)罚到 13.93——FID 对多样性缺失重罚;轻微整体偏移只罚 0.15。与 IS 合起来正好互补:IS 只看自信与均匀,FID 直接对照真实分布。
两个指标的计算流程与互补关系
FID 的样本量陷阱:读数前先看 n
FID 用样本统计量估计分布参数,样本少时协方差估不准,读数系统性偏高。量化一下这个偏差——同分布的真伪两组,只改样本量:
for n in (50, 100, 500, 2000): Xs = feat(n); Ys = feat(n) print(f"样本量 {n:4d}: FID = {fid(Xs.mean(0), np.cov(Xs.T), Ys.mean(0), np.cov(Ys.T)):.2f}") # 输出: # 样本量 50: FID = 2.34 # 样本量 100: FID = 1.21 # 样本量 500: FID = 0.23 # 样本量 2000: FID = 0.06
同分布的两组,50 样本读数 2.34、2000 样本 0.06——纯采样噪声就能制造 2 以上的 FID 差距。实践中比较两个模型时若一个用 5 千样本、另一个用 5 万样本算 FID,结论直接作废。正式论文的通行做法是五万样本起步并注明数量;复现论文时先核对样本量,再看分数。
💡 关键直觉:把 FID 读数当成"含系统偏差的温度计"——绝对值依赖特征提取器与样本量,只有同尺子下的相对比较才有意义。
本节要点回顾
- IS 公式:自信(条件分布尖)与多样(边缘分布匀)的 KL,取指数;崩溃即跌 1.0(实验值);
- FID 公式:均值差平方项加协方差迹项;四模式数据上崩溃罚 13.93、健康 0.01、微偏 0.15;
- 互补关系:IS 不看真数据、FID 直面真数据,两个都报才完整;
- 样本量陷阱:同分布两组从 2.34(n=50)虚高到 0.06(n=2000),对比必须同尺;
- 使用守则:FID 只做同条件相对比较,样本量与提取器版本必须写进报告。