2.1 卷积神经网络 (CNN) 核心概念
2.1 卷积神经网络 (CNN) 核心概念
本节摘要:CNN 是目标检测的引擎。本节回顾卷积、池化、感受野、特征图——理解这些,才能看懂检测器怎么从图像提取特征。
先说结论
阅读完本节,你应当能够:
- 解释卷积、池化的作用
- 理解感受野与下采样
- 说清特征图维度变化
概念脉络
一、卷积层
卷积是 CNN 的核心,用一个小核(kernel)在图像上滑动,做加权求和,提取局部特征。卷积核的每个权重都要在训练中学习,它学到的是"某种局部模式"——边缘、纹理、颜色块,层层组合出更复杂的语义。
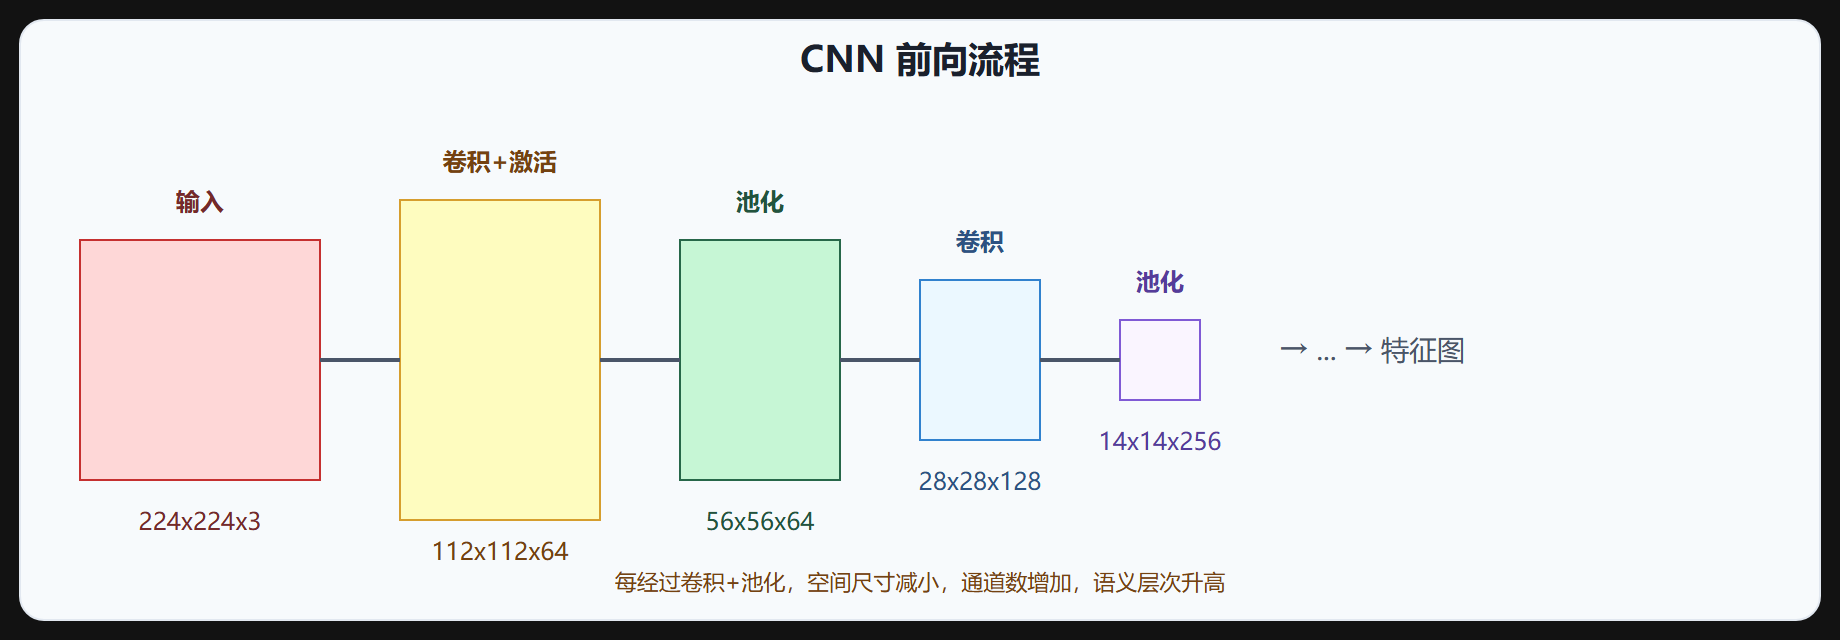
图 2-1 CNN 结构示意
关键参数:
- kernel size:核大小(如 3x3)
- stride:滑动步长
- padding:边缘补零
- 输出通道:核的数量,决定提取多少种特征
输出尺寸公式是后续所有网络设计的算术基础:
def conv_out_size(w, k, stride, padding): return (w - k + 2 * padding) // stride + 1 # 例:224x224 输入,3x3 核,stride=1,padding=1 print(conv_out_size(224, 3, 1, 1)) # 224,尺寸不变 print(conv_out_size(224, 3, 2, 1)) # 112,下采样 2 倍 print(conv_out_size(224, 7, 2, 3)) # 112,传统 7x7 下采样
注意:stride=2 的卷积会直接把分辨率砍半,很多现代骨干(如 ResNet、Darknet)都用它代替池化做下采样,减少信息损失。
二、激活函数
卷积是线性操作,加激活函数引入非线性:
- ReLU:f(x)=\max(0,x),简单高效,最常用
- Mish:x \cdot \tanh(\ln(1+e^x)),平滑,YOLOv4 用
- SiLU/Swish:x \cdot \text{sigmoid}(x),YOLOv5 用
为什么必须非线性?堆叠线性层等价于一个大线性变换,网络再深也表达不了复杂函数。激活函数把每层输出"扭曲"一下,网络才有能力拟合任意函数。ReLU 在负区间直接置零,会带来稀疏性和梯度稳定;Mish/SiLU 平滑非单调,在 YOLO 系实验中往往比 ReLU 高出零点几个点 mAP,代价是计算稍贵。
三、池化层
池化降采样,减小空间尺寸,增加感受野:
- 最大池化:取窗口最大值,保留强响应
- 平均池化:取平均
- 步长卷积:用 stride>1 的卷积代替池化(现代网络常用)
最大池化有轻微的不变性:窗口内最强的特征被保留,微小平移不影响输出。但它会丢掉位置信息,检测任务对位置敏感,所以现代检测骨干更倾向用步长卷积或保留特征图分辨率。
四、感受野
感受野是特征图上一个点对应输入图像的区域大小。网络越深,感受野越大,能看到更大范围上下文。
| 层 | 感受野 |
|---|---|
| conv 3x3 | 3 |
| conv 3x3 + conv 3x3 | 5 |
| ... 深层 | 几百 |
可以这样算:每过一个 stride=1 的 3x3 卷积,感受野 +2;每过一个 stride=2 的下采样,感受野翻倍。目标检测里感受野决定"一个特征点能看到多大区域"——感受野小于目标,特征点看到的只是目标的一角;感受野远大于目标,特征被背景稀释。
大目标要大感受野,小目标要小感受野——这是 FPN 多尺度设计的动因。
五、特征图维度
特征图尺寸 H \times W \times C:
- H, W:空间尺寸,随下采样减小
- C:通道数,随深度增加
下采样率(stride 累积)决定特征图分辨率:8x、16x、32x 下采样对应不同尺度目标检测。以 416x416 输入为例:8x 下采样得 52x52 特征图,16x 得 26x26,32x 得 13x13。YOLOv3 正是在这三个分辨率上分别检测小、中、大目标。通道数从输入的 3 增长到几百,是在把"空间信息"编码成"语义信息"。
六、BN 与归一化
Batch Normalization(BN)对每个 mini-batch 做归一化,加速训练、稳定收敛,是现代 CNN 标配。BN 的数学是:对每个通道,在 batch 内算均值方差,归一化后再用可学习的缩放和平移参数恢复表达能力。
检测中 BN 的统计在训练和推理不同:训练时用当前 batch 的统计,推理时用训练期累计的全局统计。部署时要把 BN 折叠进卷积(folding),否则推理多一步计算。小 batch 训练时 BN 统计噪声大,可改用 GroupNorm。
七、一个完整的小网络示例
把上面概念串起来:
import torch.nn as nn class MiniBackbone(nn.Module): def __init__(self): super().__init__() self.stem = nn.Sequential( nn.Conv2d(3, 32, 3, stride=2, padding=1), # 224 -> 112 nn.BatchNorm2d(32), nn.ReLU(), nn.Conv2d(32, 64, 3, stride=2, padding=1), # 112 -> 56 nn.BatchNorm2d(64), nn.ReLU(), nn.Conv2d(64, 128, 3, stride=2, padding=1), # 56 -> 28 nn.BatchNorm2d(128), nn.ReLU(), ) def forward(self, x): return self.stem(x)
每层输出分辨率减半、通道翻倍,这就是检测骨干网络的雏形。
⚠️ 常见坑:忽略感受野——小目标用大感受野特征图检测,特征早被下采样没了。小目标要用高分辨率(小下采样)特征图。
💡 关键直觉:CNN 用卷积提特征、激活加非线性、池化降采样。网络越深感受野越大但分辨率越低。大目标用深层大感受野,小目标用浅层高分辨率——FPN 的核心思想。
重点提炼
- 卷积:核滑动加权求和,参数有 kernel/stride/padding/通道,stride=2 可下采样。
- 激活:ReLU/Mish/SiLU 引入非线性,YOLO 系偏好 Mish/SiLU。
- 池化:降采样减尺寸增感受野,现代用步长卷积。
- 感受野:特征点对应输入区域,深层大、浅层小。
- 特征图:H \times W \times C,下采样率决定分辨率。
- BN:归一化加速收敛,部署注意统计差异,小 batch 用 GroupNorm。
- 关键:大目标大感受野,小目标高分辨率——FPN 动因。
下一节讲骨干网络。