2.2 常用骨干网络 (Backbones): VGG, ResNet, Darknet, ...
2.2 常用骨干网络 (Backbones)
本节摘要:骨干网络是检测器的特征提取器,决定检测性能上限。本节讲 VGG、ResNet、Darknet、CSPDarknet 等主流骨干——检测器的"发动机"。
核心问题
阅读完本节,你应当能够:
- 区分主流骨干网络
- 理解残差连接的意义
- 选合适的骨干网络
概念脉络
一、骨干网络的作用
骨干网络(Backbone)负责从图像提取特征,是检测器的"发动机"。检测精度很大程度取决于骨干网络的特征质量。通常用 ImageNet 预训练权重初始化。
为什么用预训练?ImageNet 上训好的权重已经学会了通用的边缘、纹理、形状特征,检测数据集通常只有几万到几十万张,从头训容易过拟合。预训练相当于把"通用视觉常识"拷进模型,检测训练只需在它基础上做领域适配。自监督预训练(MAE、MoCo)近年也在检测中流行,效果可与 ImageNet 监督预训练相比。
骨干的选型决策直接影响速度与精度的平衡:骨干越深越宽,特征越强,但推理越慢、显存越大。YOLO 系列迭代中不断换骨干,本质就是在精度与速度之间移动档位。
二、主流骨干网络
图 2-2 骨干网络对比
| 骨干 | 特点 | 用于 |
|---|---|---|
| VGG | 3x3 堆叠,简单 | 早期 R-CNN |
| ResNet | 残差连接,可深 | Faster R-CNN |
| Darknet-53 | YOLO 专用,快 | YOLOv3 |
| CSPDarknet53 | 跨阶段,省算力 | YOLOv4 |
| EfficientNet | 复合缩放 | 高精度检测 |
| MobileNet | 轻量 | 移动端检测 |
三、VGG
VGG 用堆叠的 3x3 卷积替代大核,结构规整,是早期检测器骨干。参数量大(VGG16 有 1.38 亿参数),现已少用。
VGG 的洞察是"用多个小核模拟大核感受野":两个 3x3 堆叠等价于一个 5x5,三个等价于 7x7,但参数更少、非线性更强。R-CNN、Fast R-CNN 都基于 VGG16。它的缺点也很明显:计算量大、结构呆板,很快被 ResNet 取代。
四、ResNet 与残差连接
ResNet 的核心是残差连接(shortcut):y = F(x) + x,让梯度直接回传,解决深层网络梯度消失,可训 152 层甚至更深。
为什么残差能训深?没有 shortcut 时,梯度要穿过几十个非线性层,连乘后指数衰减;有了 y=F(x)+x,梯度多了一条恒等通路,即使 F 的梯度很小,也能把误差传回去。实验上,34 层普通网络比 18 层还差(退化问题),而 34 层 ResNet 显著优于 18 层。
class ResBlock(nn.Module): def __init__(self, in_c, out_c, stride=1): super().__init__() self.conv1 = nn.Conv2d(in_c, out_c, 3, stride, 1, bias=False) self.bn1 = nn.BatchNorm2d(out_c) self.conv2 = nn.Conv2d(out_c, out_c, 3, 1, 1, bias=False) self.bn2 = nn.BatchNorm2d(out_c) self.shortcut = nn.Sequential() if stride != 1 or in_c != out_c: self.shortcut = nn.Sequential( nn.Conv2d(in_c, out_c, 1, stride, bias=False), nn.BatchNorm2d(out_c)) def forward(self, x): out = F.relu(self.bn1(self.conv1(x))) out = self.bn2(self.conv2(out)) return F.relu(out + self.shortcut(x))
ResNet 是 Faster R-CNN 系列默认骨干(ResNet-50/101)。
五、Darknet 系列
Darknet 是 YOLO 作者的框架,配套骨干网络:
- Darknet-19:YOLOv2 用,19 层,快
- Darknet-53:YOLOv3 用,53 层,加残差,精度速度平衡
Darknet-53 借鉴 ResNet 的残差思想,但整体更"瘦",专为检测设计。论文里与 ResNet-101 精度相当,但 FLOPs 少约一半、速度快约 1.5 倍,是当时"精度速度比"最好的骨干之一。它的名字来自 53 个卷积层,加上残差块结构,在 COCO 检测任务上表现均衡。
六、CSPDarknet
CSPDarknet53 引入 CSPNet 思想:把特征图分两部分,一部分走主干,一部分跨阶段直接拼接,减少计算量同时保持精度。YOLOv4 采用。
# CSP 结构:通道一分为二,一半走密集计算,一半直接合并 def csp_block(x, conv): half = x.shape[1] // 2 x1, x2 = x[:, :half], x[:, half:] x1 = conv(x1) # 主干分支 return torch.cat([x1, x2], dim=1) # 跨阶段拼接
这样把计算量大幅削减,梯度流也更丰富。YOLOv4 用 CSPDarknet53 + SPP + PANet 的组合在单 GPU 上训练出了当时 SOTA 的单阶段检测器。
七、EfficientNet
EfficientNet 用复合缩放(同时缩放深度、宽度、分辨率),在精度和效率上找到帕累托最优,是高精度检测器骨干选择。它的思路:网络三个维度(深度、宽度、输入分辨率)不是独立最优的,应该按固定比例一起缩放。通过神经架构搜索找到基础结构后,用复合系数缩放出一族模型 B0-B7,从轻量到高精度随意取档。
八、轻量骨干
移动端/边缘部署用轻量骨干:
- MobileNet 系列:深度可分离卷积
- ShuffleNet:通道洗牌
- GhostNet:廉价特征生成
深度可分离卷积把标准卷积拆成"逐通道卷积 + 1x1 逐点卷积",参数量和计算量都大幅下降——MobileNetV1 用 7x7 感受野的卷积,计算量只有标准卷积的约九分之一。轻量骨干精度略降,但换来了在手机、边缘盒子上的可部署性。
九、选型建议
| 需求 | 骨干 |
|---|---|
| 高精度 | ResNet-101、EfficientNet |
| 速度优先 | CSPDarknet53、MobileNet |
| 移动端 | MobileNetV3、GhostNet |
| 平衡 | ResNet-50、Darknet-53 |
选型口诀:先看部署平台(GPU/CPU/ARM),再看时延预算,最后定精度档位。服务器端追求精度用 ResNet/EfficientNet,边缘实时用 CSPDarknet/YOLO 系自带骨干,移动端用 MobileNet/GhostNet 加量化。
⚠️ 常见坑:换骨干不调超参——不同骨干最优学习率、BN 配置不同,直接换可能掉点。换骨干要重新调参。
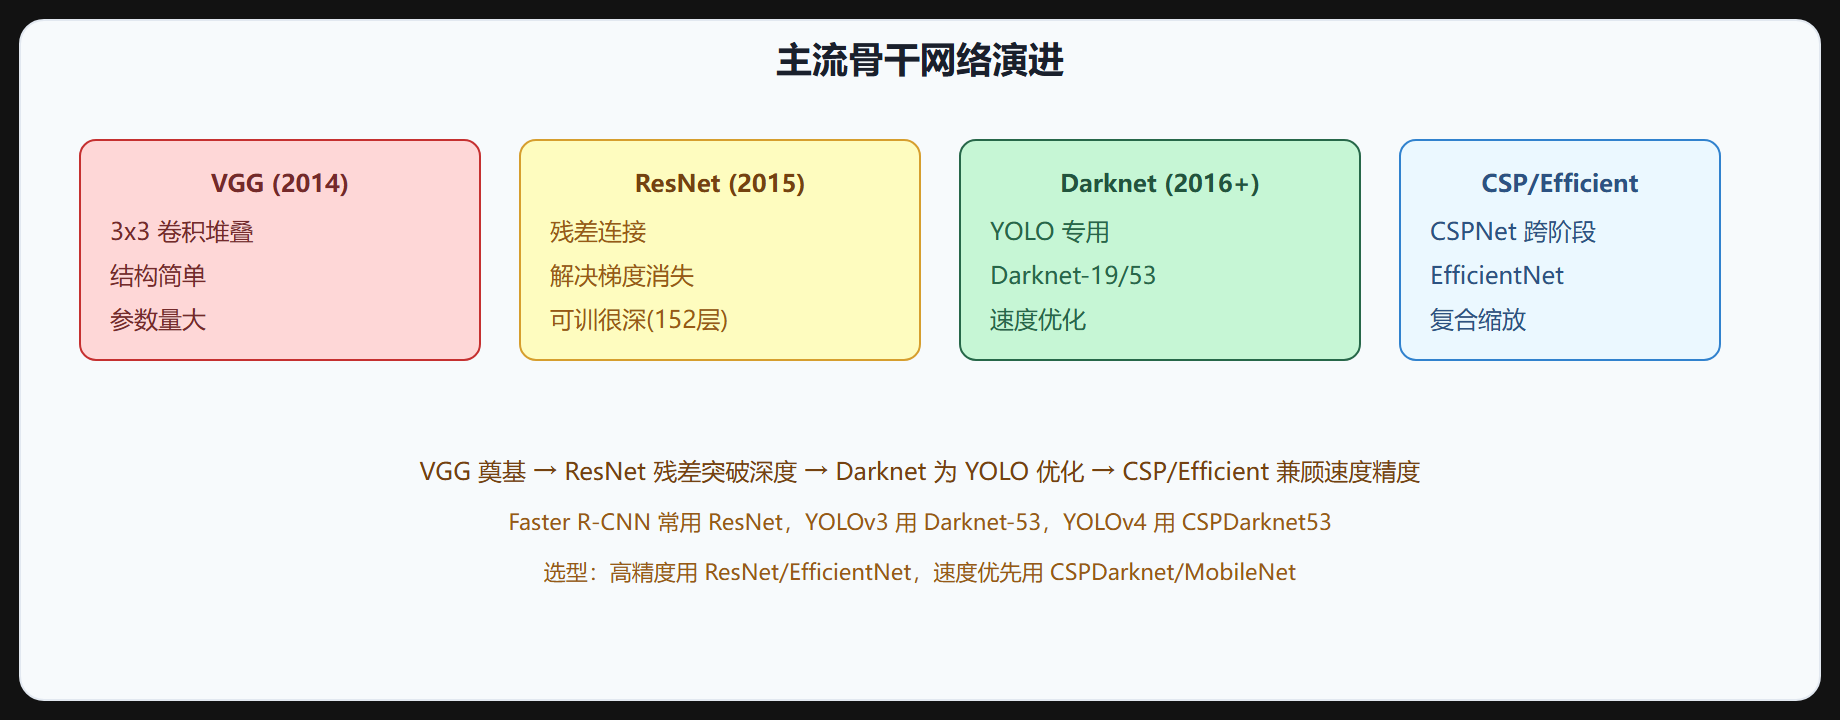
💡 关键直觉:骨干是检测器发动机,决定特征质量上限。VGG 奠基→ResNet 残差突破深度→Darknet 为 YOLO 优化→CSP/Efficient 兼顾速度精度。高精度用 ResNet/Efficient,速度用 CSPDarknet,移动用 MobileNet。
本章回顾
- 骨干作用:特征提取,决定检测上限,常用 ImageNet 预训练。
- VGG:3x3 堆叠,简单但参数大,早期用。
- ResNet:残差连接突破深度,Faster R-CNN 默认。
- Darknet:YOLO 专用,Darknet-19/53。
- CSPDarknet:跨阶段省算力,YOLOv4 用。
- EfficientNet:复合缩放,高精度。
- 轻量:MobileNet/ShuffleNet/GhostNet,移动端。
- 选型:高精度 ResNet/Efficient,速度 CSPDarknet,移动 MobileNet。
下一节讲损失函数。