3.1 R-CNN:区域卷积神经网络开山之作
3.1 R-CNN
本节摘要:R-CNN 是深度学习目标检测的开山之作。本节讲它的流程和痛点——慢得离谱但开启了 CNN 检测时代。
读前必看
阅读完本节,你应当能够:
- 描述 R-CNN 的流程
- 说出 R-CNN 的痛点
- 理解它为什么是里程碑
概念脉络
一、R-CNN 的历史地位
2014 年 Girshick 提出 R-CNN,把 CNN 引入目标检测,在 VOC 上 mAP 从 35% 飙到 58%,开启深度学习检测时代。但代价是——慢。
2012 年 AlexNet 在 ImageNet 分类上夺冠后,大家意识到 CNN 特征远强于手工特征,但怎么把 CNN 用到"找出目标在哪"上,R-CNN 给出了第一个可用的答案:不要试图在整图上滑窗扫 CNN,而是先用传统的候选框生成器圈出"可能有目标"的区域,再只对这些区域做 CNN 分类。这个"先粗筛、再细看"的思路,就是两阶段范式的雏形。
二、R-CNN 流程
图 3-1 R-CNN 流程
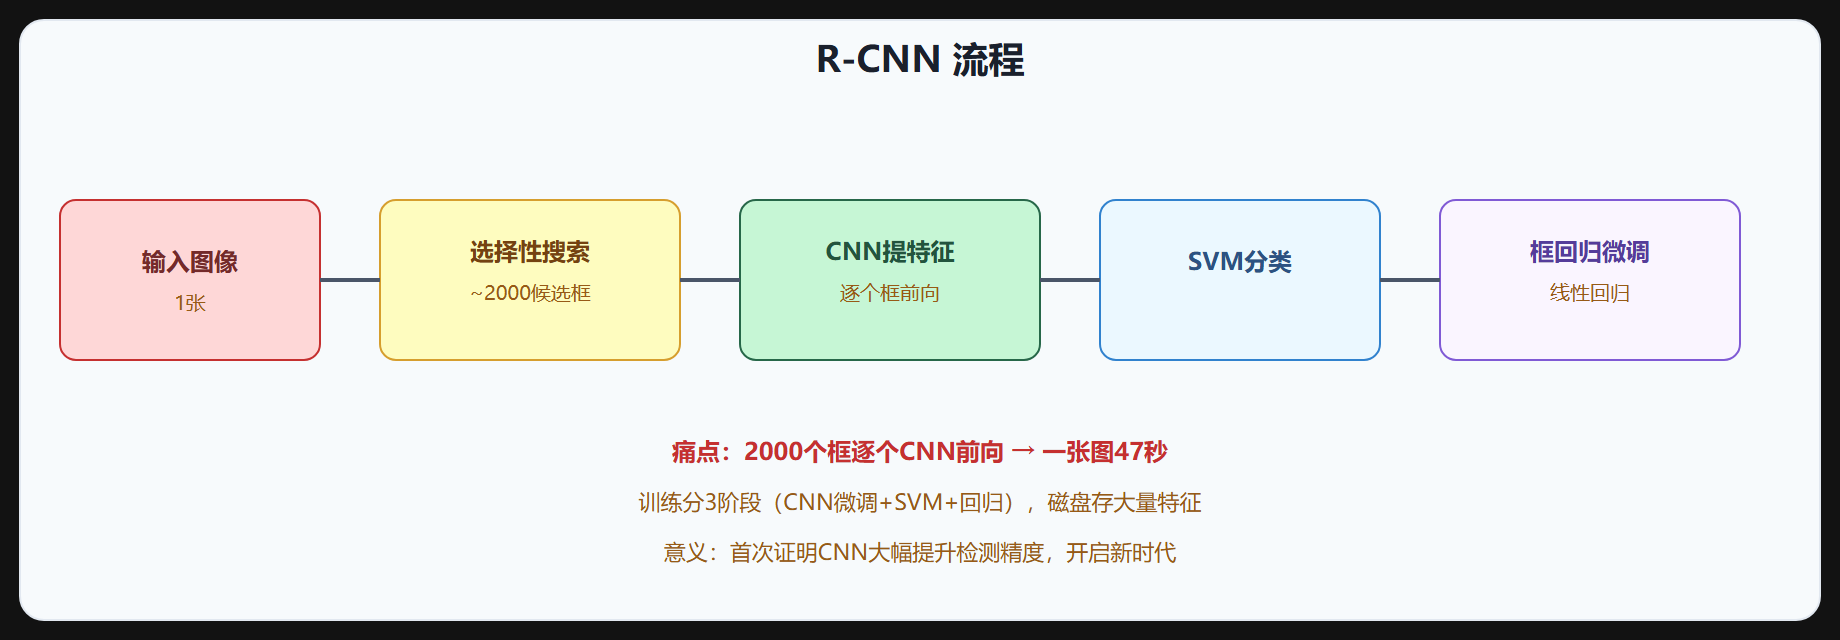
R-CNN 四步:
- 选择性搜索:生成约 2000 个候选框
- CNN 提特征:每个框缩放到固定大小,独立前向 CNN
- SVM 分类:每个类别一个 SVM
- 框回归:线性回归微调框
第 2 步里有个工程细节:CNN 需要固定尺寸输入,而候选框大小不一,R-CNN 把每个候选框区域裁剪出来并缩放到 227x227(AlexNet 的输入尺寸),再送入 CNN。缩放会带来形变,这是后来 Fast R-CNN 用 RoI Pooling 解决的一个问题。
三、选择性搜索
选择性搜索(Selective Search)用图像分割+层次合并生成候选框,约 2000 个,覆盖可能目标。这是 CPU 上的传统算法,慢且无法 GPU 加速。
选择性搜索先对图像做过度分割(小超像素),再按颜色、纹理、尺寸、形状相似度迭代合并相邻区域,每合并一次就记录一个候选框,最终得到几千个多尺度的候选区域。它比滑动窗口聪明(不用穷举所有位置和尺度),但仍然很慢,且和 CNN 是两套独立系统。
四、痛点
R-CNN 的痛点很明显:
| 痛点 | 说明 |
|---|---|
| 慢 | 2000 框逐个 CNN 前向,一张图 47 秒 |
| 训练复杂 | 3 阶段(CNN 微调 + SVM + 回归)分别训练 |
| 磁盘占用 | 存大量中间特征 |
| 候选框瓶颈 | 选择性搜索 CPU 慢 |
用代码模拟一下它的前向开销:
def rcnn_forward(image, cnn, svm): """R-CNN 推理:每个候选框独立过一次 CNN""" proposals = selective_search(image, k=2000) # CPU 生成候选框 feats = [] for box in proposals: crop = resize(image[box], (227, 227)) # 缩放到固定尺寸 feat = cnn(crop) # 一次完整 CNN 前向 feats.append(feat) scores = svm.predict(np.stack(feats)) # 逐类 SVM 打分 return scores
2000 次独立 CNN 前向,每次都要完整跑一遍卷积——这就是 47 秒/图的来源。对比后来 Fast R-CNN 整图只跑一次 CNN,计算量相差约 2000 倍。
五、为什么是里程碑
虽然慢,R-CNN 证明了两件事:
- CNN 特征远强于手工特征(HOG/SIFT)
- 检测可以拆成"候选框 + CNN 分类"框架
这为后续 Fast R-CNN、Faster R-CNN 奠定基础——后续工作都在解决 R-CNN 的"慢"。
六、从对比看演进
| 方法 | 候选框 | 特征提取 | 分类器 | 速度 |
|---|---|---|---|---|
| DPM(传统) | 滑窗+手工特征 | HOG | 潜在 SVM | 慢 |
| R-CNN | 选择性搜索 | 2000 次 CNN | 独立 SVM | 47s/图 |
| Fast R-CNN | 选择性搜索 | 整图 1 次 CNN | 网络 FC | 0.32s/图 |
R-CNN 的"慢"恰恰是后续两代改进的靶子:Fast R-CNN 干掉"2000 次 CNN",Faster R-CNN 干掉"选择性搜索"。理解 R-CNN 的痛点,就等于理解了整个两阶段演进史。
七、训练细节与数据技巧
R-CNN 训练时对候选框的 IoU 分配有明确规则:与真值框 IoU 大于 0.5 的候选框作为该类的正样本,IoU 小于 0.3 的作为背景负样本,介于两者之间的样本直接忽略。这个"IoU 阈值分配正负样本"的做法被后续所有检测器继承,只是阈值和实现不同。
另外一个常被忽略的点:R-CNN 的 SVM 是在 CNN 特征上训练的,而 CNN 本身先在 ImageNet 分类任务上预训练、再在检测数据上微调。预训练提供了通用的低层特征(边缘、纹理、颜色块),微调让高层特征向检测任务对齐。没有预训练,小规模检测数据训不出好特征——这也是后来"预训练 + 微调"成为检测标配的原因。
R-CNN 的候选框数量也值得琢磨:选择性搜索出 2000 个框,其中真正含目标的可能只有几十个,正负比接近 1:40。R-CNN 用 SVM 加难例挖掘缓解:把分错的负样本重新收集进训练集,让 SVM 更专注难背景。这套"难例挖掘"思路在 SSD 等单阶段方法里也继续使用。
⚠️ R-CNN 的慢:2000 个候选框各自做一次 CNN 前向,计算量是 Fast R-CNN 的 2000 倍。这是它被淘汰的直接原因。
💡 关键直觉:R-CNN 是开山之作:选择性搜索找框→CNN 提特征→SVM 分类→框回归。慢(47s/图)但证明 CNN 检测可行,开启时代。后续工作都在解决它的"慢"。
核心回顾
- 地位:2014 开山之作,CNN 引入检测,VOC mAP 35%→58%。
- 流程:选择性搜索(2000 框)→CNN 提特征→SVM 分类→框回归。
- 选择性搜索:CPU 算法,慢,无法 GPU 加速。
- 痛点:慢(47s/图)、训练 3 阶段、磁盘大、候选框瓶颈。
- 意义:证明 CNN 特征强,奠定"候选框+CNN 分类"框架。
- 演进靶子:Fast R-CNN 解决 2000 次 CNN,Faster R-CNN 解决选择性搜索。
下一节看 Fast R-CNN 怎么提速。