3.2 Fast R-CNN
3.2 Fast R-CNN
本节摘要:Fast R-CNN 解决了 R-CNN 的"慢"——让整张图只做一次 CNN 前向。本节讲 RoI Pooling 和多任务损失,看它如何提速但仍卡在候选框。
学习目标
阅读完本节,你应当能够:
- 理解 RoI Pooling 的作用
- 说清 Fast R-CNN 的提速原理
- 指出它仍剩的瓶颈
概念脉络
一、Fast R-CNN 的核心改进
R-CNN 慢在 2000 框各自 CNN 前向。Fast R-CNN 的洞察:整张图只做一次 CNN 前向,候选框在特征图上截取,省 2000 倍计算。
为什么可行?卷积层的计算天然共享——重叠的候选框在输入图像上有重叠区域,重叠区域的特征不必重复计算。R-CNN 却把每个候选框单独送进 CNN,同一块像素被算了几千次。Fast R-CNN 先让整图过一次 CNN 得到特征图,再从特征图上"切"出每个候选框对应的特征区域,一次前向全部搞定。
二、RoI Pooling
候选框在特征图上大小不一,全连接层要固定输入。RoI Pooling 把任意大小的候选区域池化成固定尺寸(如 7x7):
图 3-2 RoI Pooling
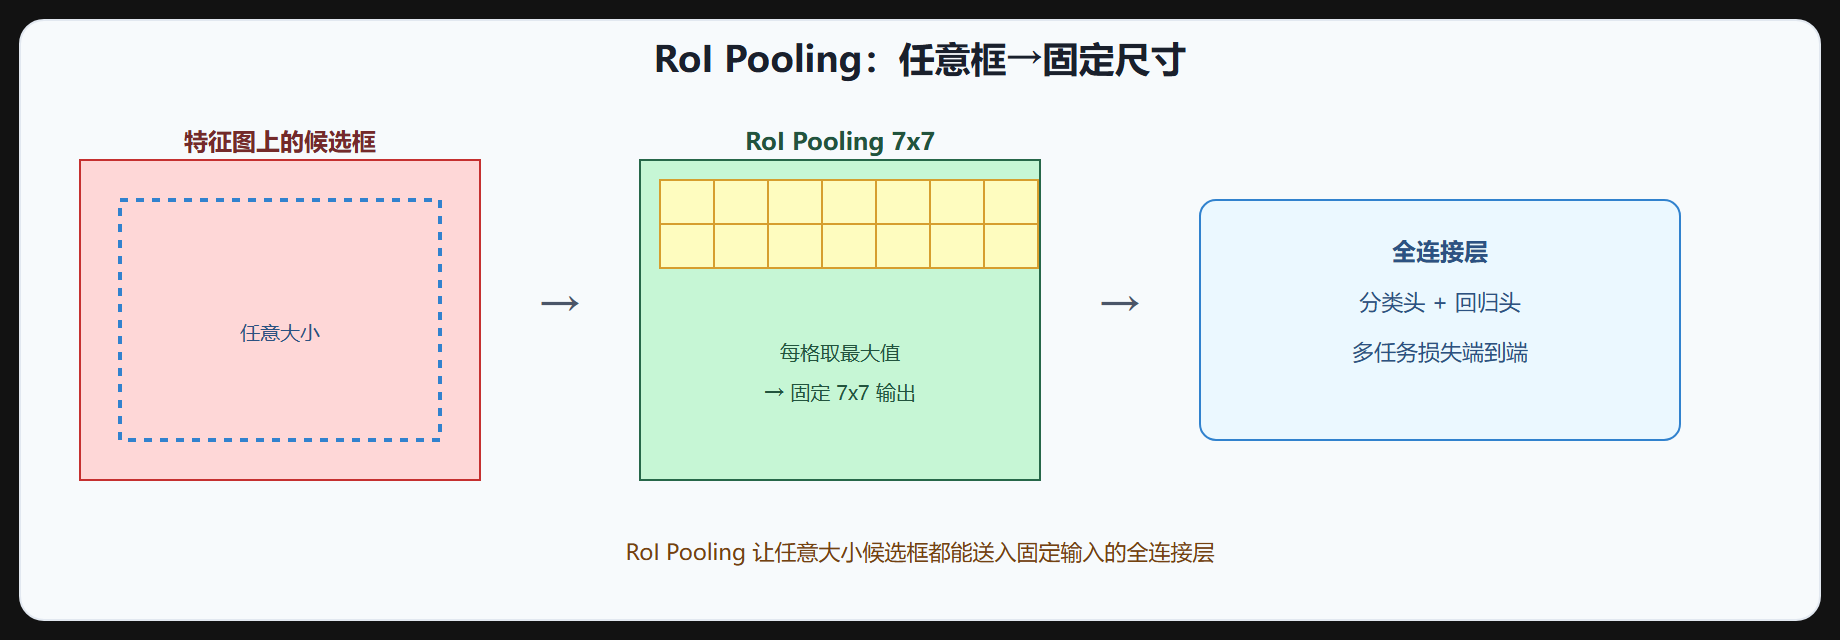
RoI Pooling 把候选区域分成 7x7 网格,每格取最大值,输出固定 7x7 特征,送入全连接层。
def roi_pool(feature_map, roi_box, out_size=7): """把任意大小的 RoI 池化成固定尺寸""" x1, y1, x2, y2 = roi_box roi = feature_map[:, y1:y2, x1:x2] pooled = F.adaptive_max_pool2d(roi, (out_size, out_size)) return pooled
实现上的小问题:RoI 的坐标和特征图分辨率之间需要按 stride 换算,池化时如果区域尺寸不能整除 7,会有取整误差。这个误差对分类影响不大,但对像素级任务(分割)是硬伤,后来的 Mask R-CNN 为此提出 RoIAlign。
三、多任务损失
Fast R-CNN 把分类和回归整合到一个网络,端到端训练:
- L_{cls}:分类损失(交叉熵)
- L_{loc}:回归损失(Smooth L1)
- [u \geq 1]:只对正样本算回归
相比 R-CNN 的 3 阶段训练,Fast R-CNN 一次训练,简化流程。R-CNN 要先后训 CNN(分类监督)、SVM(检测监督)、回归器(框监督),三个组件各训各的,特征不是为检测任务端到端优化的。Fast R-CNN 把分类和回归放进同一个网络、同一个损失里联合训练,梯度同时更新特征提取器和检测头,模型整体为检测目标服务。
四、Fast R-CNN 流程
- 整图 CNN 前向,得特征图
- 选择性搜索生成候选框(仍是 CPU)
- RoI Pooling 从特征图截取候选区域,池化成固定尺寸
- 全连接层分类 + 框回归
- 多任务损失端到端训练
五、提速效果
| 指标 | R-CNN | Fast R-CNN |
|---|---|---|
| 训练 | 84 小时 | 9.5 小时 |
| 测试 | 47 秒/图 | 0.32 秒/图 |
| mAP | 58 | 66 |
Fast R-CNN 比 R-CNN 快 146 倍,精度还更高。速度提升来自共享特征:CNN 前向从 2000 次降到 1 次,剩下的时间主要花在 RoI Pooling 和全连接层上。精度提升则来自端到端多任务训练。
六、剩余瓶颈
Fast R-CNN 解决了 CNN 前向慢,但选择性搜索仍是 CPU 瓶颈:每张图 2 秒生成候选框,比 CNN 前向(0.32 秒)还慢。这个瓶颈催生了 Faster R-CNN 的 RPN。
也就是说:Fast R-CNN 把检测时间从 47 秒压到 0.32 秒,但其中 2 秒还是花在候选框生成上——候选框反而成了最慢的一环。同时,选择性搜索是独立于网络的启发式算法,它"圈不到"的区域,网络再好也检测不到,这是召回率的上限。
七、小结对比
| 维度 | R-CNN | Fast R-CNN |
|---|---|---|
| CNN 前向次数 | 2000 | 1 |
| 训练方式 | 3 阶段分离 | 端到端多任务 |
| 特征共享 | 无 | 有 |
| 候选框 | 选择性搜索 | 选择性搜索(瓶颈) |
| 速度 | 47s | 0.32s |
Fast R-CNN 站在 R-CNN 的肩膀上,把"慢"字拆掉了一半。剩下的"候选框瓶颈",正是下一节 Faster R-CNN 要攻克的。
八、两个实现细节
第一,SVD 加速全连接:Fast R-CNN 的时间大头在 RoI 后的全连接层,作者用截断 SVD 把大 FC 分解成两个小矩阵,参数减少、速度提升约 30%,精度几乎无损。这类"等价变换减计算"的思路在工程优化里非常常见,YOLOv5 的 SPPF 也是同类思路。
第二,RoI 的坐标映射:候选框坐标是在原图上算的,进入特征图时要除以主干网络的累积 stride,再按特征图分辨率取整。stride 越大,这个映射越粗糙,小框的定位误差越大。这个误差在分类任务里无所谓,却是后来 Mask R-CNN 改用 RoIAlign 的动机之一。
⚠️ Fast R-CNN 的瓶颈:CNN 快了(0.32s),但选择性搜索 2s/图,候选框生成成了新瓶颈。Faster R-CNN 就是为解决这个而生。
💡 关键直觉:Fast R-CNN 核心是"整图一次 CNN + RoI Pooling",省 2000 倍计算。多任务损失端到端训练。但选择性搜索仍是 CPU 瓶颈,催生 Faster R-CNN。
本节速览
- 核心改进:整图一次 CNN 前向,候选框在特征图截取,省 2000 倍计算。
- RoI Pooling:任意大小候选区域池化成固定 7x7,送全连接层。
- 多任务损失:分类+回归整合,端到端训练,简化流程。
- 提速:测试 47s→0.32s(146 倍),mAP 58→66。
- 剩余瓶颈:选择性搜索 2s/图(CPU),比 CNN 还慢,催生 Faster R-CNN。
下一节看 Faster R-CNN 怎么用 RPN 解决候选框瓶颈。