3.3 Faster R-CNN
3.3 Faster R-CNN
本节摘要:Faster R-CNN 用 RPN 取代选择性搜索,真正端到端。本节讲 RPN、锚点、共享特征——两阶段检测器的成熟形态。
本节目标
阅读完本节,你应当能够:
- 理解 RPN 的工作原理
- 说清锚点机制
- 描述 Faster R-CNN 完整流程
概念脉络
一、Faster R-CNN 的突破
Fast R-CNN 卡在选择性搜索(CPU 2s/图)。Faster R-CNN 用**区域建议网络(RPN)**取代它,把候选框生成也搬上 GPU,真正端到端,速度从 0.32s 降到 0.198s。
RPN 的妙处不只是快:它和检测网络共享骨干特征,候选框质量由数据驱动学习得到,而不是靠启发式规则。选择性搜索"看不到"的语义信息,RPN 能通过高层特征发现,这直接抬高了召回率上限。
二、RPN(区域建议网络)
RPN 在共享特征图上滑动一个小网络,每个位置预测 k 个锚点的前景/背景分数和框偏移。
图 3-3 Faster R-CNN 架构
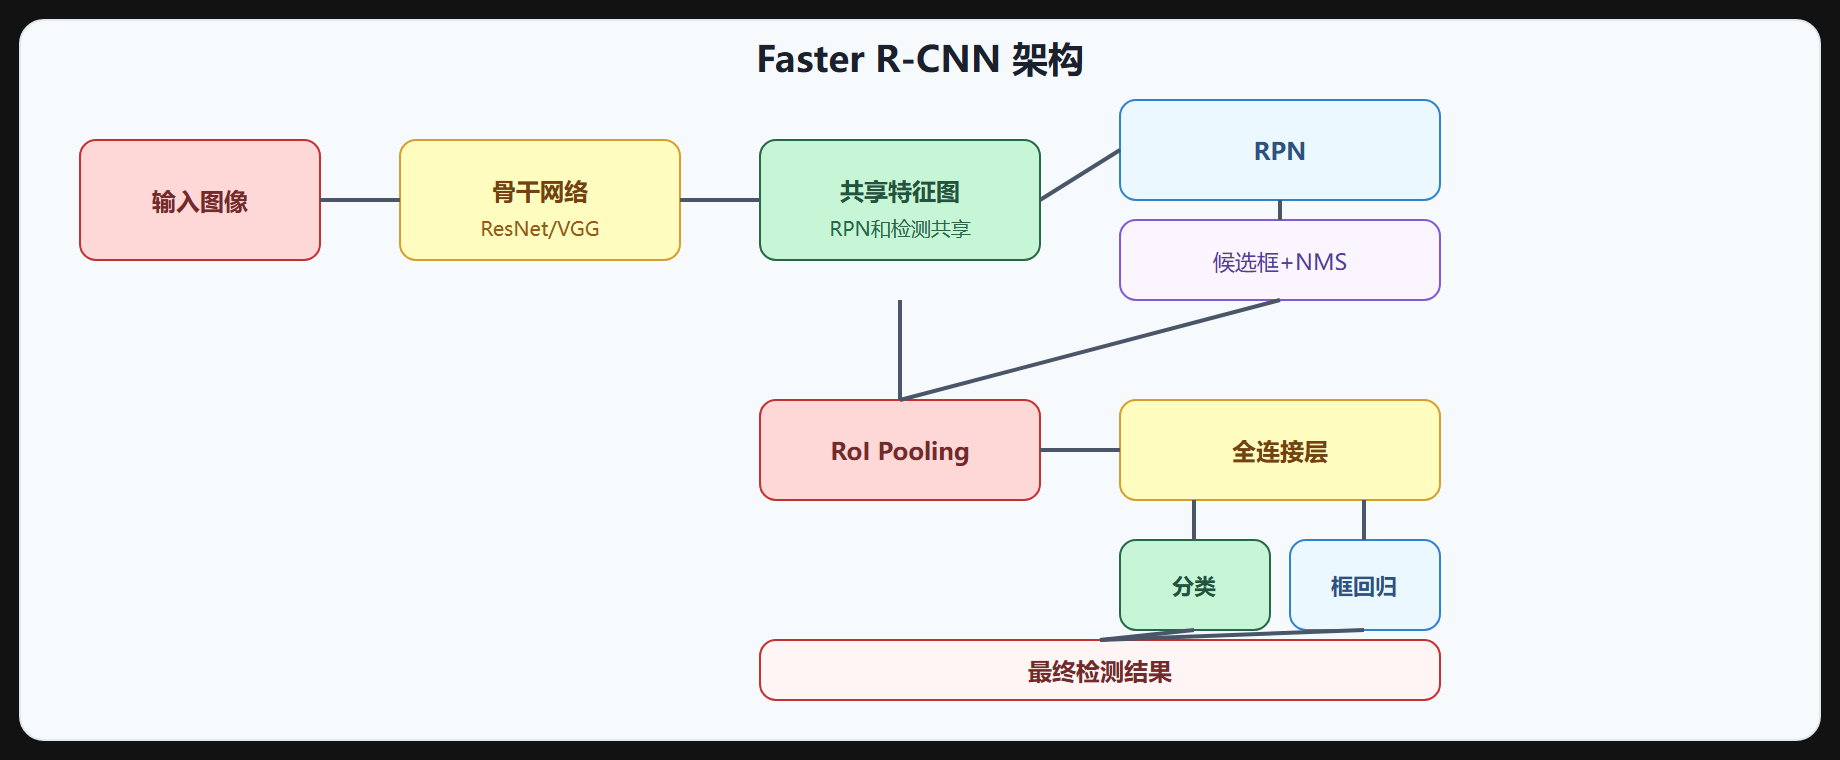
RPN 工作流程:
- 在特征图每个位置滑动 3x3 窗口
- 映射到低维特征(256 维)
- 分两支:分类支(前景/背景)+ 回归支(框偏移)
- 每个位置预测 k 个锚点
- NMS 后输出候选框
三、锚点(Anchors)
锚点是预定义的参考框,不同尺度和长宽比。Faster R-CNN 用 3 种尺度(128/256/512)× 3 种长宽比(1:1/1:2/2:1)= 9 种锚点。
每个特征图位置预测 9 个锚点的前景分数和框偏移。RPN 实际是在锚点基础上回归微调,而非凭空预测框。
# 生成单个位置的 9 个锚点(按原图尺度) def make_anchors(base=16, scales=(128,256,512), ratios=(0.5,1.0,2.0)): anchors = [] for s in scales: area = s * s for r in ratios: w = round((area * r) ** 0.5) h = round((area / r) ** 0.5) anchors.append((-w/2, -h/2, w/2, h/2)) # 相对中心点 return anchors
锚点让"预测框"这个任务变得好学:模型不用从零想出一个框的绝对坐标,只需要在预设锚点上做小幅度修正。锚点的尺度和长宽比要覆盖数据里目标的分布,这也是后来 YOLOv2 用 K-means 在数据上自动聚类锚点的由来。
四、共享特征
RPN 和检测网络共享骨干特征图,联合训练:
- RPN 用特征图生成候选框
- 检测网络用同一特征图做 RoI Pooling 分类
共享特征让两个任务互相促进,端到端训练。RPN 训练时也给骨干回传梯度,所以骨干学到的不只是"分类友好"的特征,还是"既能找候选、又能分类"的特征。
五、Faster R-CNN 完整流程
- 图像经骨干网络得共享特征图
- RPN 在特征图上生成候选框(GPU,~10ms)
- 候选框经 RoI Pooling 得固定特征
- 全连接层分类 + 框回归
- NMS 输出最终结果
六、性能
| 指标 | Fast R-CNN | Faster R-CNN |
|---|---|---|
| 候选框生成 | 选择性搜索 2s | RPN 10ms |
| 总测试速度 | 0.32s | 0.198s |
| mAP (VOC) | 66 | 73.2 |
Faster R-CNN 真正端到端,速度和精度都提升。速度提升来自候选框生成从 CPU 搬到 GPU 并大幅变快;精度提升来自候选框由学习获得,比启发式算法更能贴合数据。
七、训练策略
Faster R-CNN 交替训练:
- 训 RPN(用 ImageNet 预训练骨干)
- 用 RPN 候选框训 Fast R-CNN
- 用检测网络微调 RPN
- 再微调检测网络
也可端到端联合训练(现代实现常用)。原始论文用交替训练收敛更稳,后来发现联合训练(一个损失同时含 RPN 和检测头)也能收敛,mmdetection 等框架默认端到端训练,并配合一些实现细节(如 RoI 只取正样本、梯度裁剪)保证稳定。
八、RPN 的标签分配细节
训练 RPN 时每个锚点要打标签:与某个真值框 IoU 最高的锚点,以及与任意真值框 IoU > 0.7 的锚点,标为前景;IoU < 0.3 的标为背景;介于两者之间的锚点在损失里忽略。这个"正负样本界定"逻辑在后续所有检测器里都能看到变体,YOLO 的 center-in-grid、RetinaNet 的 IoU 阈值分配都是同一思路的演化。
九、影响
Faster R-CNN 奠定了现代两阶段检测的标准骨架:骨干 + RPN + RoI 头。之后十多年,两阶段研究大多在替换这三块的组件(FPN 换特征、RoIAlign 换池化、Cascade 换训练范式),骨架本身保持稳定。这也说明 Faster R-CNN 的设计已经足够"对"。
⚠️ RPN 的关键:锚点是参考框,RPN 在锚点基础上回归,不是凭空预测。理解锚点就理解了 RPN。
💡 关键直觉:Faster R-CNN 用 RPN(GPU)取代选择性搜索(CPU),真正端到端。RPN 在共享特征图上用锚点回归候选框。共享特征让两任务互相促进。速度 0.198s,mAP 73.2。
重点提炼
- 突破:RPN 取代选择性搜索,候选框生成搬上 GPU,端到端。
- RPN:特征图滑动,每位置预测 k 个锚点的前景分数+框偏移,NMS 输出候选框。
- 锚点:预定义参考框(3 尺度×3 长宽比=9),RPN 在锚点基础上回归。
- 共享特征:RPN 和检测共享骨干特征图,联合训练互相促进。
- 流程:骨干→特征图→RPN 候选框→RoI Pooling→分类+回归→NMS。
- 性能:候选框 2s→10ms,总速度 0.198s,mAP 73.2。
- 标签分配:锚点按 IoU 分前景/背景/忽略,贯穿后续所有检测器。
下一节看 Faster R-CNN 的变体。