4.1 YOLOv1 (You Only Look Once)
4.1 YOLOv1 (You Only Look Once)
本节摘要:YOLOv1 把检测当回归,"只看一次"就出结果。本节讲它的网格划分、回归思想和痛点——单阶段检测的开端。
先说结论
阅读完本节,你应当能够:
- 理解 YOLOv1 的回归思想
- 描述网格划分机制
- 指出 YOLOv1 的痛点
概念脉络
一、YOLOv1 的革命性思想
两阶段检测器先找候选框再分类,流程长。YOLOv1 的洞察:把检测当回归,输入图像直接输出所有框和类别,"只看一次"。
这个转变是范式级的:两阶段把检测拆成"建议+分类"两个模块,YOLOv1 直接问 CNN"图里有哪些目标、各自在哪",用一个端到端的回归网络一次前向回答完。速度从每秒几张(两阶段)跳到 45 FPS,实时检测成为可能。代价是精度先降后追,这正是第 1 章讲的精度-速度取舍。
二、网格划分
YOLOv1 把图像划分成 S \times S 网格。如果一个目标中心落入某网格,该网格负责预测这个目标。
图 4-1 YOLOv1 网格划分
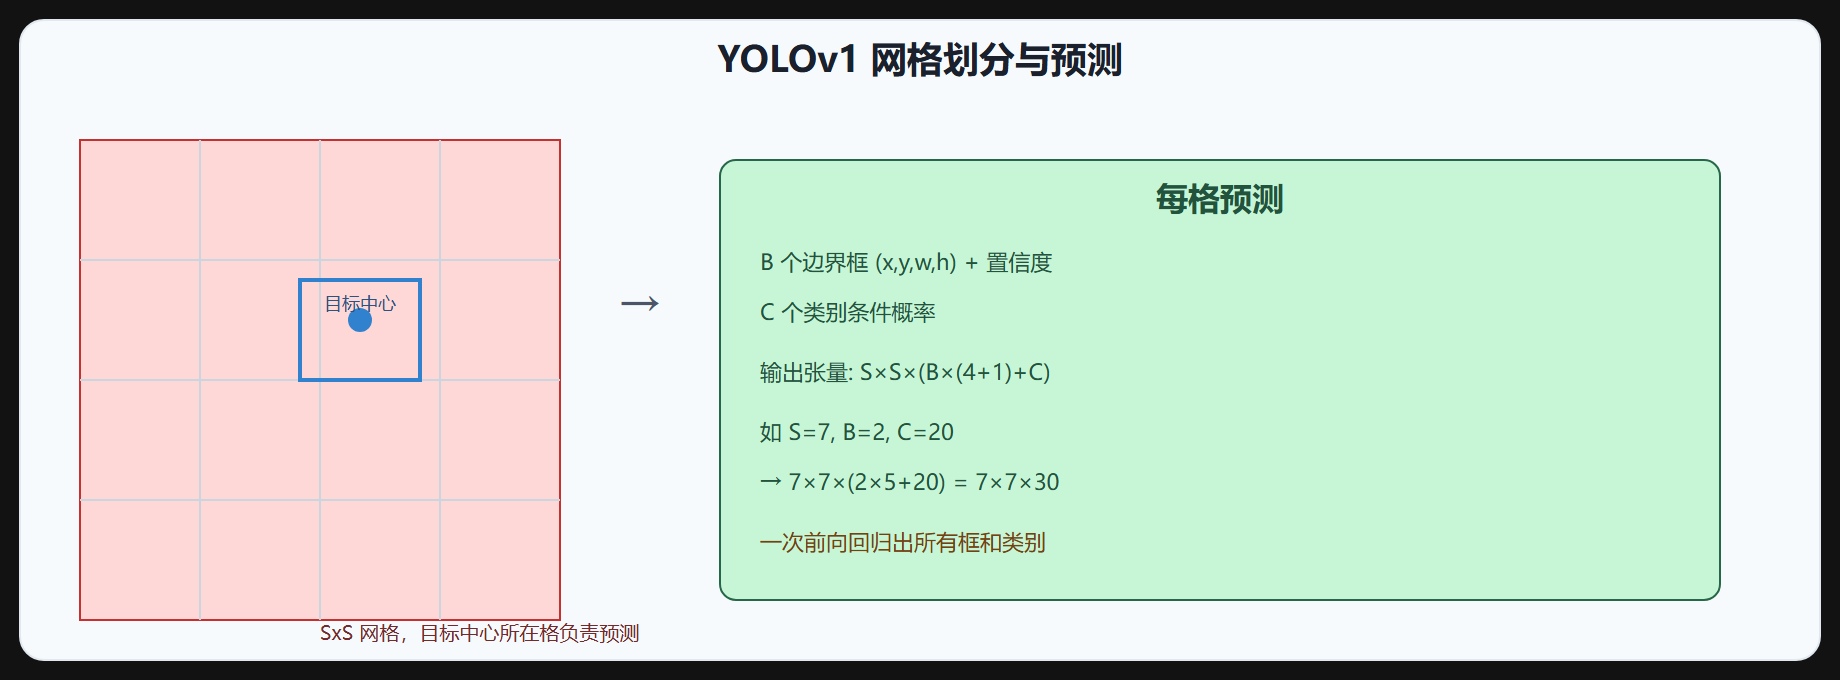
每个网格预测:
- B 个边界框 (x,y,w,h) + 置信度
- C 个类别的条件概率
输出张量 S \times S \times (B \times 5 + C)。如 S=7, B=2, C=20 → 7 \times 7 \times 30。
网格划分是"空间责任分配":每个网格只对中心落在自己区域的目标负责,把一个全局检测问题分解成 S×S 个局部回归问题。置信度定义是"框里有目标的概率 × 框的准确度",训练时用 IoU 监督。
# YOLOv1 输出张量布局:7x7 网格,每格 30 维 # 维度含义:[框1(5维), 框2(5维), 类别20维] def yolo_v1_output(grid=7, b=2, c=20): """构造 YOLOv1 输出的伪代码""" return np.zeros((grid, grid, b * 5 + c)) # 7x7x30 # 解码:每个网格取置信度最高的框 + 类别概率 def decode(grid_out): boxes, scores, classes = [], [], [] for i in range(grid_out.shape[0]): for j in range(grid_out.shape[1]): cell = grid_out[i, j] box1_conf, box2_conf = cell[4], cell[9] cls = cell[10:].argmax() if max(box1_conf, box2_conf) > 0.3: boxes.append(...) # 该格的最优框 return boxes, scores, classes
三、损失函数
YOLOv1 损失综合:
- 坐标误差(框位置)
- 置信度误差(含目标与否)
- 分类误差
对含目标的格和不含目标的格分别加权,平衡正负样本。
损失里有个重要设计:不负责目标的格,置信度损失权重降低。因为一张图里绝大多数网格是背景,如果不加权,背景格的"无目标"损失会淹没目标格的梯度。这已经是"正负样本不均衡"意识的雏形,只是 YOLOv1 用固定权重处理,RetinaNet 后来用 focal loss 做得更精细。
四、优点
- 极快:一次前向出结果,45 FPS(Titan X),实时
- 端到端:从图像直接到检测结果
- 全局视野:看整图,误检少(不像滑窗局部)
全局视野是 YOLOv1 常被低估的优点:两阶段在候选框内分类,天然看不到框外上下文;YOLOv1 的每个预测都基于整图特征,能利用上下文区分"背景里像人的物体"和"真的人",误检(尤其把背景当目标)比滑窗方法少。
五、痛点
YOLOv1 的痛点明显:
| 痛点 | 说明 |
|---|---|
| 定位精度低 | 每格只预测一个类别,多目标同格处理不了 |
| 召回率低 | 每格只 B 个框,小目标密集易漏 |
| 长宽比敏感 | 对不常见长宽比泛化差 |
| 小目标差 | 网格粗,小目标信息不足 |
本质原因:7x7 网格太粗,一个格子可能同时包含多个目标中心;B=2 个框太少,密集场景放不下;w,h 直接回归绝对尺寸,对尺度不鲁棒。YOLOv1 自己也承认,定位误差是主要错误来源。
六、历史意义
YOLOv1 虽精度不及 Faster R-CNN,但证明了检测可以当回归做,速度碾压两阶段。这开启了单阶段检测时代,后续 YOLO 版本和 SSD、RetinaNet 都在这思路上改进。
七、与两阶段的第一组对比
| 维度 | Faster R-CNN | YOLOv1 |
|---|---|---|
| 候选框 | RPN(GPU) | 无,网格直出 |
| 一次前向 | 骨干+RPN+RoI头 | 骨干+检测头 |
| 速度 | 0.198s | 45 FPS |
| VOC mAP | 73.2 | 63.4 |
YOLOv1 用 10 个点的 mAP 换来了 10 倍以上的速度。这个取舍是否划算,取决于场景——这组数字也预示了后面十年的竞争主题:单阶段怎么把精度追回来。
⚠️ YOLOv1 的痛点根源:每格只预测一个类别 + 少量框,导致密集小目标处理不了。v2 用锚点解决,v3 用多尺度解决。
💡 关键直觉:YOLOv1 把检测当回归,网格划分+一次前向出结果,极快(45FPS)但精度低(每格一类、框少)。痛点:定位低、召回低、小目标差。开启单阶段时代。
温故知新
- 思想:检测当回归,"只看一次",一次前向出所有框和类别。
- 网格划分:S \times S 网格,目标中心所在格负责预测。
- 每格预测:B 个框+置信度,C 个类别概率,输出 S \times S \times (B \times 5+C)。
- 优点:极快(45FPS)、端到端、全局视野误检少。
- 痛点:定位低、召回低、长宽比敏感、小目标差(每格一类+框少)。
- 意义:证明检测可回归,开启单阶段时代。
下一节看 YOLOv2 怎么用锚点解决痛点。