4.2 YOLOv2 (YOLO9000)
4.2 YOLOv2 (YOLO9000)
本节摘要:YOLOv2 用锚点和维度聚类解决 v1 的精度痛点。本节讲它的改进——精度大幅提升仍保持速度。
核心问题
阅读完本节,你应当能够:
- 理解锚点机制如何提升精度
- 说清维度聚类
- 列举 v2 的其他改进
概念脉络
一、YOLOv2 的目标
YOLOv1 快但精度低(VOC mAP 63.4,比 Faster R-CNN 73.2 差 10 个点)。YOLOv2 的目标:提升精度同时保持速度。
二、锚点机制(核心改进)
YOLOv1 每格直接预测框,难学。YOLOv2 引入 Faster R-CNN 的锚点:每格预测相对锚点的偏移,而非凭空预测框,学习更稳定。
引入锚点后,每格预测 9 个锚点(而非 v1 的 2 个),召回率大幅提升。为什么锚点更好学?预测绝对坐标 (x,y,w,h) 时,模型要同时猜"位置在哪"和"多大",目标空间大且尺度不一;预测相对锚点的偏移时,位置被锚点"固定"在附近,模型只需要微调,任务变简单,收敛也快。
三、维度聚类
锚点的尺寸和长宽比怎么定?Faster R-CNN 手动设定。YOLOv2 用 K-means 聚类在训练集边界框上自动找最佳锚点尺寸:
图 4-2 YOLOv2 改进
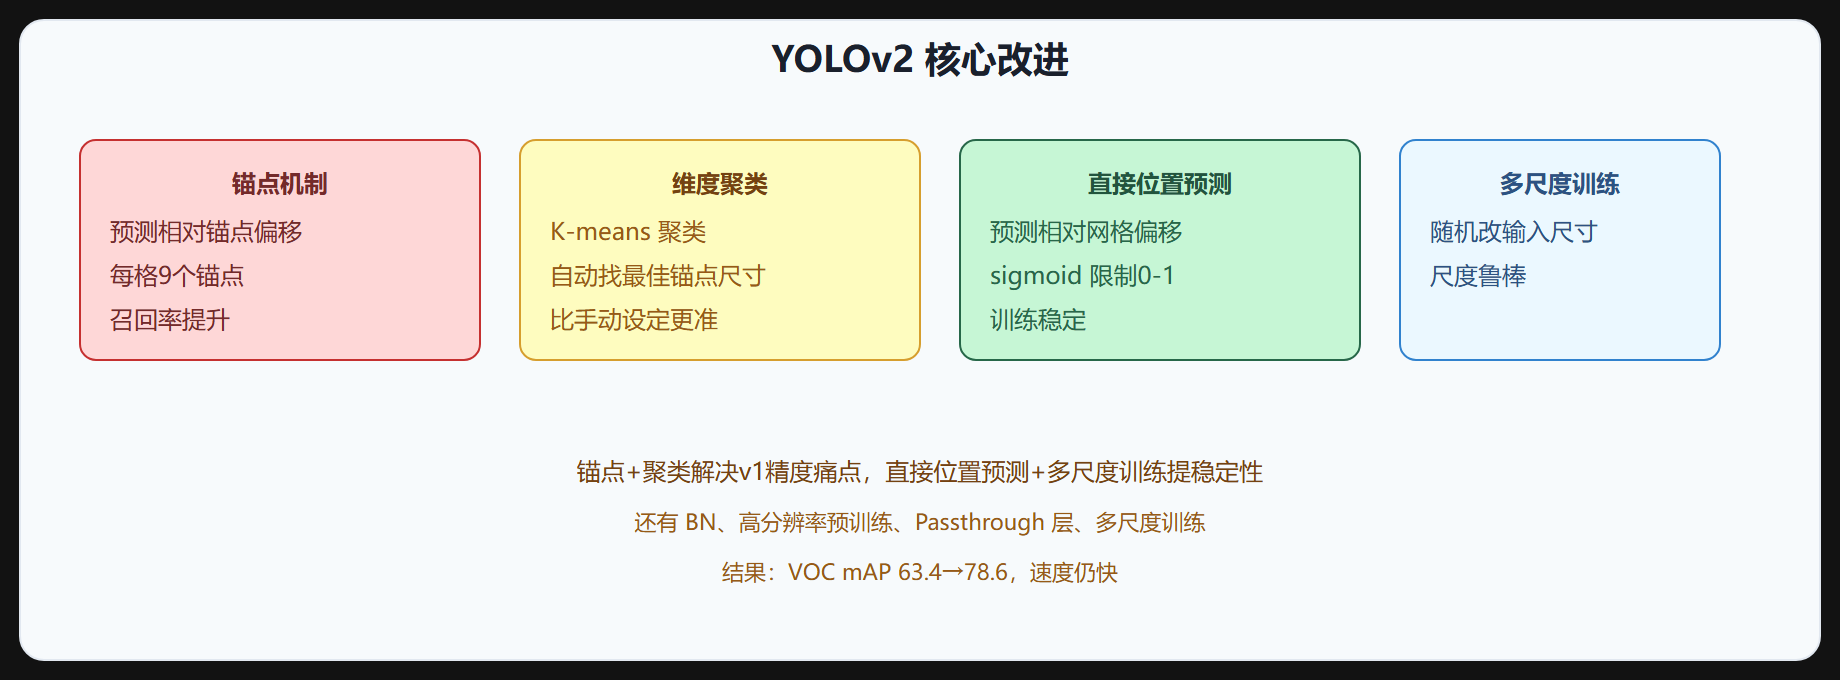
用距离度量(1-IoU)而非欧氏距离聚类,找到训练集真实的框尺寸分布,比手动设定更贴合数据。
# K-means 聚类锚点(距离用 1-IoU,避免大框主导) def cluster_anchors(box_whs, k=5, iters=50): """box_whs: 训练集所有标注框的宽高列表""" centers = box_whs[np.random.choice(len(box_whs), k, replace=False)] for _ in range(iters): # 距离 = 1 - IoU(假设两框中心对齐) dists = np.array([[1 - iou_center(wh, c) for c in centers] for wh in box_whs]) labels = dists.argmin(axis=1) centers = [box_whs[labels == i].mean(axis=0) for i in range(k)] return np.array(centers)
为什么不用欧氏距离?欧氏距离对大框敏感:同样差 10 像素,大框的 IoU 损失很小,小框的 IoU 损失很大,聚类结果会被大框带偏。用 1-IoU 作为距离,聚类结果直接反映"框的形状分布",和检测任务的目标一致。这也是 YOLO 系列区别于 Faster R-CNN 手动设锚点的地方。
四、直接位置预测
YOLOv2 不直接预测框绝对坐标,而是预测相对网格左上角和锚点尺寸的偏移,用 sigmoid 限制到 0-1,训练更稳定。
如果不加 sigmoid,回归值可能跑到任意位置,导致训练早期框乱跳。sigmoid 把中心点偏移限制在所在网格内,配合锚点宽高,预测始终"有界",训练稳定性大幅提升。这套"网格内中心 + 锚点尺寸"的编码,后来 YOLOv3-v5 基本沿用。
五、其他改进
| 改进 | 说明 |
|---|---|
| Batch Normalization | 所有卷积加 BN,收敛快,去掉 dropout |
| 高分辨率预训练 | 先 224 训练再 448 微调,适应高分辨率 |
| Passthrough 层 | 高分辨率特征与低分辨率拼接,助小目标 |
| 多尺度训练 | 随机改输入尺寸,尺度鲁棒 |
| Darknet-19 | 更深的骨干网络 |
高分辨率预训练值得注意:分类预训练用 224x224,检测输入提到 448x448,直接切换会让网络不适应大输入。YOLOv2 先在 448 上微调分类网络 10 个 epoch,再转检测训练,mAP 提升了约 4 个点。这种"预训练和下游输入分辨率对齐"的思路,后来被广泛应用。
六、性能
| 指标 | YOLOv1 | YOLOv2 |
|---|---|---|
| VOC mAP | 63.4 | 78.6 |
| 速度 (FPS) | 45 | 67 |
YOLOv2 精度大幅提升(+15 mAP),速度还更快,是显著进步。提速来源:Darknet-19 比 v1 的 GoogLeNet 风格骨干更快,配合 BN 收敛更快。注意这些增益大多来自训练技巧而非单纯加层——这也说明检测的进步经常是"工程配方"的胜利。
七、YOLO9000
YOLOv2 还提出 YOLO9000,用 WordTree 层次分类,在 COCO+ImageNet 联合训练,能检测 9000 类,探索检测+分类联合。它把 ImageNet 的类别组织成树,节点是类别,边是包含关系;训练时检测数据走完整检测损失,分类数据只走分类分支。这让模型对没有检测标注的类别也能"认出但说不准位置",是弱监督检测的早期探索。
八、对比视角
| 维度 | YOLOv1 | YOLOv2 |
|---|---|---|
| 框预测 | 直接回归绝对框 | 锚点偏移 + sigmoid 约束 |
| 锚点来源 | 无 | K-means 聚类 |
| 骨干 | GoogLeNet 风格 | Darknet-19 |
| 输入 | 448 | 448(多尺度 320-608) |
| VOC mAP | 63.4 | 78.6 |
v2 的每一项改动都有明确的"治什么病":锚点治难学,聚类治锚点不贴合,BN 治收敛,高分辨率治大目标,Passthrough 治小目标,多尺度治尺度鲁棒。
⚠️ 锚点的意义:v1 凭空预测框难学,v2 用锚点做参考,预测偏移,学习更稳定,召回率提升。这是单阶段精度提升的关键。
💡 关键直觉:YOLOv2 用锚点(预测偏移而非凭空)+维度聚类(自动找锚点尺寸)解决 v1 精度痛点。加 BN、多尺度训练、Passthrough。mAP 63→79,速度仍快。
要点速记
- 目标:提升精度保持速度。
- 锚点机制:预测相对锚点偏移,每格 9 锚点,召回提升。
- 维度聚类:K-means(1-IoU 距离)自动找最佳锚点尺寸,比手动准。
- 直接位置预测:相对网格+锚点偏移,sigmoid 限 0-1,训练稳定。
- 其他:BN、高分辨率预训练、Passthrough、多尺度训练、Darknet-19。
- 性能:mAP 63.4→78.6,速度 67FPS。
- YOLO9000:WordTree 联合检测+分类,9000 类。
下一节看 YOLOv3 怎么解决小目标。