4.7 其他单阶段检测器 (SSD, RetinaNet)
4.7 其他单阶段检测器 (SSD, RetinaNet)
本节摘要:YOLO 之外,SSD 和 RetinaNet 是单阶段的重要分支。本节讲 SSD 的多尺度多框和 RetinaNet 的 focal loss——单阶段检测的另两条路。
读前必看(上)
阅读完本节,你应当能够:
- 理解 SSD 的多尺度多框设计
- 理解 RetinaNet 的 focal loss
- 对比单阶段检测器
概念脉络
一、SSD (Single Shot MultiBox Detector)
SSD 2016 年发布,和 YOLO 同期,是单阶段另一代表。
图 4-7 SSD 与 RetinaNet
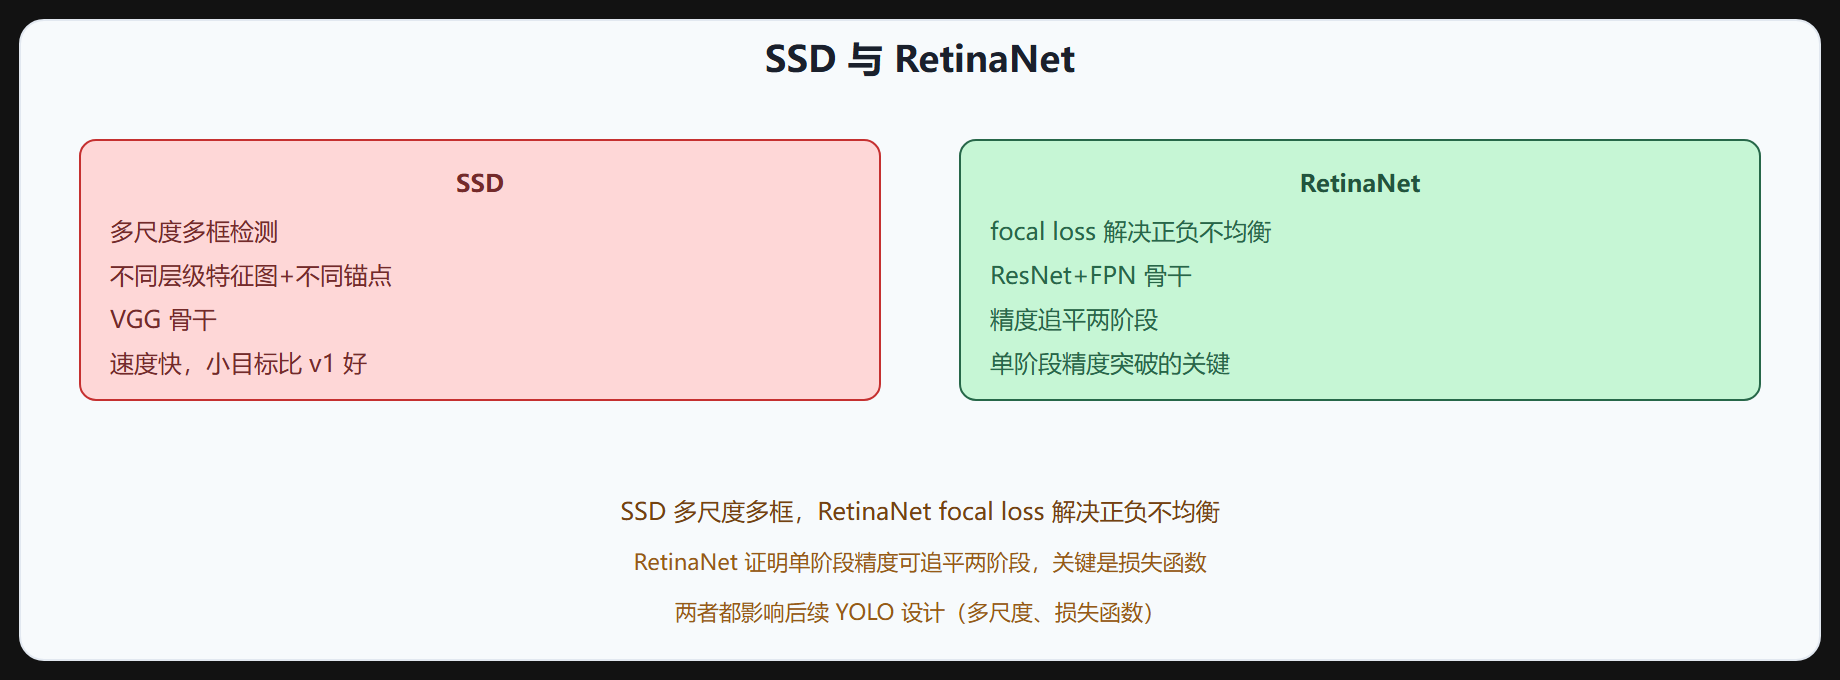
SSD 核心思想:
- 多尺度特征图:在不同层级的特征图上检测(不同尺度目标)
- 多框预测:每个特征图位置用多种长宽比的锚点
- VGG 骨干:加额外卷积层得不同尺度特征图
SSD 比 YOLOv1 小目标好,速度快,但精度不及两阶段。SSD 是第一个把"多尺度特征图检测"做扎实的单阶段方法:浅层特征图分辨率高,负责小目标;深层特征图感受野大,负责大目标。这个思想直接启发了 YOLOv3 的多尺度头。
二、SSD 架构
SSD 在 VGG 基础上加多个卷积层,得到 6 个不同尺度特征图(38x38 到 1x1),每个位置用 4-6 个锚点,覆盖多尺度多长宽比。
损失 = 分类损失(交叉熵)+ 回归损失(Smooth L1),用难例挖掘平衡正负样本。
# SSD 多尺度锚点:每层特征图配不同尺度的锚点 def ssd_default_boxes(layer_sizes): """layer_sizes: 各层特征图尺寸,如 [38,19,10,5,3,1]""" default_boxes = [] for i, size in enumerate(layer_sizes): s = base_scale[i] # 该层锚点基础尺度 for cx in np.linspace(0, 1, size): for cy in np.linspace(0, 1, size): for ratio in ratios[i]: w = s * ratio ** 0.5 h = s / ratio ** 0.5 default_boxes.append([cx, cy, w, h]) return np.array(default_boxes)
SSD 也面临正负样本不均衡,它用难例挖掘(hard negative mining):排序所有负样本的损失,只取损失最大的前 3 倍正样本数量来训练。这和 focal loss 是解决同一问题的两种路线——一个挑难样本,一个给难样本加权。
三、RetinaNet 与 focal loss
RetinaNet 2017 年发布,核心是 focal loss,解决单阶段检测的正负样本不均衡问题。
单阶段的痛点:正负不均衡
单阶段检测每张图生成数万个候选位置,绝大多数是背景(负样本),正样本(含目标)极少。普通交叉熵让大量易分背景样本主导损失,模型学不到有效信息。
focal loss
- (1-p_t)^\gamma:降低易分样本(p_t 高)的权重
- \gamma:聚焦参数(通常 2)
- 让模型专注难分样本
focal loss 让单阶段精度首次追平两阶段,是单阶段的关键突破。
# focal loss 实现(二分类版) def focal_loss(logits, targets, gamma=2.0, alpha=0.25): p = torch.sigmoid(logits) ce = F.binary_cross_entropy_with_logits(logits, targets, reduction='none') p_t = p * targets + (1 - p) * (1 - targets) # 样本被分对的置信度 alpha_t = alpha * targets + (1 - alpha) * (1 - targets) return (alpha_t * (1 - p_t) ** gamma * ce).mean()
当 \gamma=0 时 focal loss 退化为带 \alpha 加权的交叉熵;\gamma=2 时,一个被分对的背景样本(p_t=0.99)权重是 (0.01)^2=0.0001,几乎不贡献梯度;而难分样本(p_t=0.5)权重是 0.25。模型被迫把注意力放在那些"像目标却分错"的区域。
四、RetinaNet 架构
- 骨干:ResNet + FPN
- 检测头:分类 + 回归,anchor-based
- 损失:focal loss(分类)+ Smooth L1(回归)
RetinaNet 证明:单阶段精度不如两阶段,不是范式问题,而是损失函数问题。focal loss 解决不均衡后,单阶段也能 SOTA。
RetinaNet 的检测头还有个细节:分类和回归是解耦的两个子网络(各 4 层卷积)。早期单阶段方法用共享头,分类和回归的需求不同(分类要区分前景背景,回归要对正样本精修),共享会互相干扰。解耦头后来被 YOLOv6/v8 继承。
五、单阶段检测器对比
| 检测器 | 特点 | 优势 |
|---|---|---|
| YOLO 系列 | 回归思想,迭代快 | 速度极快,生态好 |
| SSD | 多尺度多框 | 速度快,小目标可 |
| RetinaNet | focal loss | 精度追平两阶段 |
| FCOS | anchor-free | 无锚点,简洁 |
| CenterNet | 中心点预测 | 极简 |
六、对后续的影响
- SSD 的多尺度思想被 YOLOv3 吸收
- RetinaNet 的 focal loss 被广泛采用
- anchor-free 思想(FCOS/CenterNet)影响 YOLOv6/v8
七、怎么选择
| 需求 | 选择 |
|---|---|
| 与 YOLO 生态衔接 | YOLO 系 |
| 要可解释的多尺度基线 | SSD |
| 正负样本严重失衡 | RetinaNet(focal loss) |
| 无锚点简洁实现 | FCOS / CenterNet |
SSD 和 RetinaNet 已经很少作为生产首选,但它们的两个贡献活在每个现代检测器里:SSD 的多尺度检测思想被 YOLOv3 吸收,RetinaNet 的 focal loss 被无数模型采用。学它们不是为了"用",而是为了看懂"多尺度"和"样本不均衡"这两个问题的标准解法。
⚠️ 单阶段精度瓶颈的真相:不是范式不行,而是正负样本不均衡。RetinaNet 用 focal loss 解决后单阶段追平两阶段,这是关键认知。
💡 关键直觉:SSD 多尺度多框(不同层级+多锚点),RetinaNet focal loss 解决正负不均衡(单阶段精度追平两阶段的关键)。两者影响后续 YOLO 设计。单阶段精度瓶颈是损失函数问题非范式问题。
本章回顾
- SSD:多尺度特征图(6 层级)+多框(多锚点),VGG 骨干,速度快小目标可。
- SSD 损失:交叉熵+Smooth L1,难例挖掘平衡。
- RetinaNet:focal loss 解决正负不均衡,ResNet+FPN,精度追平两阶段。
- focal loss:(1-p_t)^\gamma 降低易分样本权重,专注难分样本。
- 解耦头:分类回归分离,被 YOLOv6/v8 继承。
- 关键认知:单阶段精度瓶颈是损失函数问题非范式问题。
- 影响:SSD 多尺度→YOLOv3,focal loss→广泛采用,anchor-free→YOLOv6/v8。
- 对比:YOLO(回归快)、SSD(多尺度)、RetinaNet(focal loss)、FCOS/CenterNet(anchor-free)。
第 4 章结束。下一章讲核心技术与通用模块。