4.6 YOLOv6 / YOLOv7 / YOLOv8 (简要概述最新进展与趋势)
4.6 YOLOv6 / YOLOv7 / YOLOv8
本节摘要:YOLOv5 之后,各家推出 v6/v7/v8,进入"YOLO 诸国时代"。本节简述这些版本的改进和趋势——单阶段检测的当下。
本节导航
阅读完本节,你应当能够:
- 了解 YOLOv6/v7/v8 的来源和改进
- 理解 anchor-free 趋势
- 知道当前 YOLO 生态格局
概念脉络
一、YOLO 诸国时代
YOLOv5 之后,多家机构各自发布 YOLO 版本,命名混乱但都基于单阶段回归思想:
| 版本 | 来源 | 特点 |
|---|---|---|
| YOLOv6 | 美团 | 工业部署优化 |
| YOLOv7 | YOLOv4 作者团队 | 架构创新 |
| YOLOv8 | Ultralytics | 集大成,anchor-free |
二、YOLOv6(美团)
美团 2022 年发布,面向工业部署:
- RepVGG 风格骨干:训练多分支,推理单分支,部署友好
- EfficientRep:高效重参数化结构
- anchor-free:去掉锚点,直接预测中心点
- 解耦头:分类和回归头分离
- 定位:工业场景,速度优先
重参数化(reparameterization)是 YOLOv6 的关键词:训练时网络有多分支(如残差旁路),推理时把多分支合并成单分支卷积,训练性能不损失、推理变快。这是"训练和推理用不同结构"的代表做法。
三、YOLOv7(原作者团队)
YOLOv4 作者团队 2022 年发布,架构创新:
- E-ELAN:扩展的高效层聚合网络
- 模型重参数化:训练多分支推理单分支
- 辅助头训练:用辅助监督提升
- 标签分配:动态标签分配
- 在 COCO 上达到高精度,速度领先
YOLOv7 提出"辅助头"训练技巧:主检测头之外加一个辅助头,让梯度从两条路径回传,深层特征训练得更充分,推理时辅助头去掉不影响结构。
四、YOLOv8(Ultralytics)
图 4-6 YOLOv8 与 anchor-free 趋势
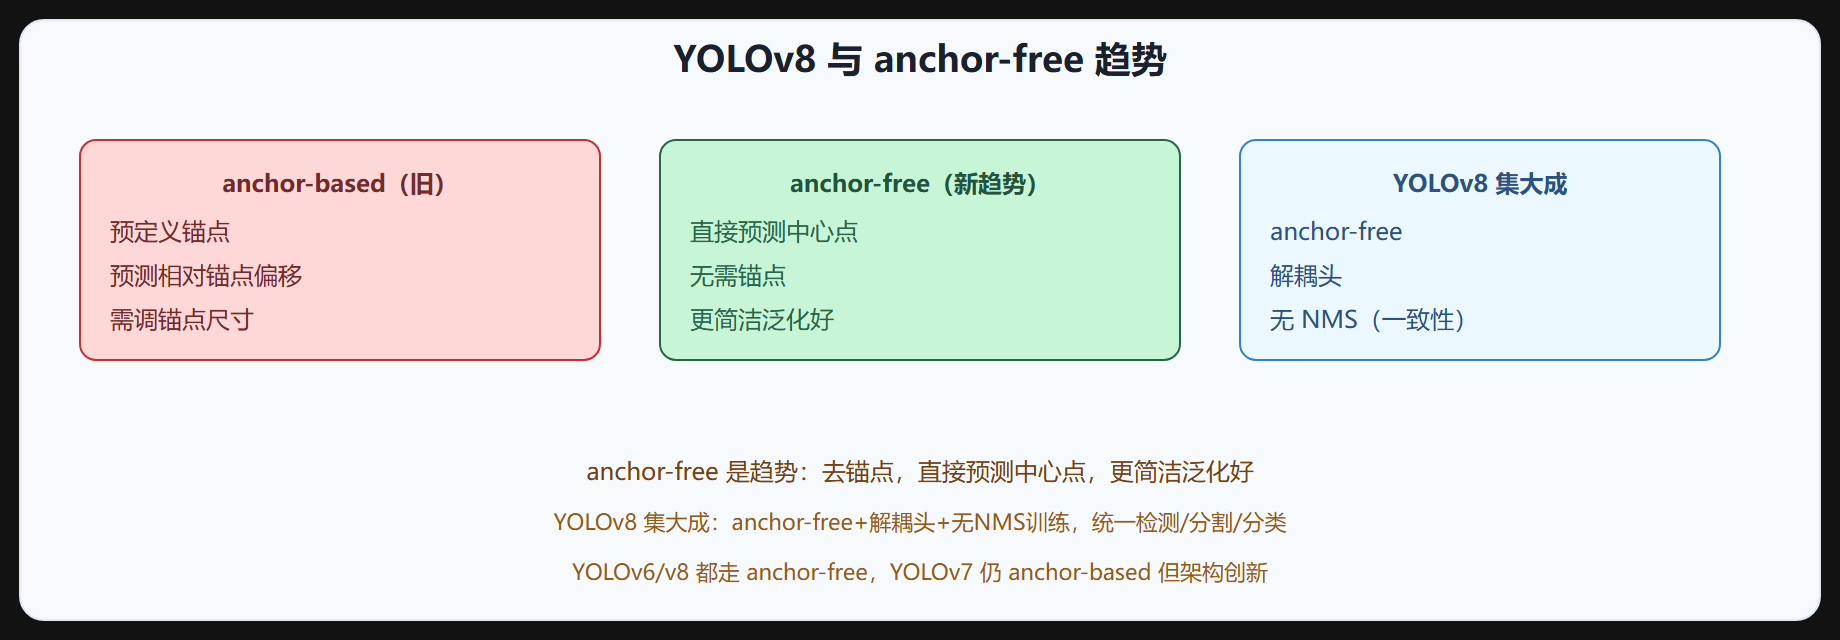
Ultralytics 2023 年发布 YOLOv8,集大成:
- anchor-free:去掉锚点,直接预测中心点(趋势)
- 解耦头:分类和回归头分离
- 无 NMS 训练:一致性损失,推理可去 NMS
- 统一框架:检测、实例分割、姿态估计、分类一体
- C2f 模块:改进 CSP,更强特征
- 提供 n/s/m/l/x 五种尺寸
YOLOv8 是当前 Ultralytics 主推版本,工程化延续 v5 易用性。
五、anchor-free 趋势
早期 YOLO(v2-v5)用 anchor-based,需预设锚点尺寸。新版本(v6/v8)转向 anchor-free:
- 直接预测中心点,无需锚点
- 无需调锚点超参
- 更简洁,泛化好
- 代表:FCOS、CenterNet、YOLOX、YOLOv6/v8
# anchor-free 解码:直接回归中心点 + 宽高 def decode_anchor_free(raw): """raw 形状 [N, 4+num_cls, H, W]""" cx = sigmoid(raw[:, 0]) * stride + grid_x # 中心点 x cy = sigmoid(raw[:, 1]) * stride + grid_y # 中心点 y w = raw[:, 2].exp() * base_size # 宽 h = raw[:, 3].exp() * base_size # 高 return cx, cy, w, h
anchor-free 的意义:不用再 K-means 聚类锚点、不用处理锚点分配,训练配置更少;对长尾形状目标的泛化也更好。代价是早期训练稳定性略差,需要用中心采样等技巧兜底。
六、其他新版本
- YOLOX:旷视,早期 anchor-free 探索
- YOLOv9(2024):可编程梯度信息,进一步突破
- YOLOv10(2024):无 NMS 设计
七、当前格局
YOLO 生态已非单一主线,多家并行:
- Ultralytics:v5、v8(及后续),工程化强,社区大
- 美团:v6,工业部署
- 原作者团队:v4、v7,架构创新
- 学术界:YOLOX、v9/v10,前沿探索
选型时按需求(精度/速度/部署/生态)选,不必拘泥版本号。
八、选型对比表
| 需求 | 推荐 |
|---|---|
| 工程落地、生态最全 | YOLOv5 / YOLOv8 |
| 极致推理速度 | YOLOv6(重参数化) |
| 精度优先的 YOLO 系 | YOLOv7 / YOLOv9 |
| 需要分割/姿态/分类一体 | YOLOv8 统一框架 |
| 去掉 NMS 的端到端 | YOLOv10 |
问:这么多版本怎么入门? 从 YOLOv8 或 YOLOv5 上手,它们的文档、教程、权重最全;理解一个之后,其他版本看结构差异即可。
九、从对比理解趋势
把 v1 到 v8 放在一起看,单阶段检测的演进其实是三条线的叠加:骨干越来越强(Darknet-19→Darknet-53→CSPDarknet→C2f),预测方式越来越直接(网格回归→锚点→anchor-free),训练配方越来越重(普通增强→Mosaic→无 NMS 训练)。每次"换头"(改检测头)的收益正在变小,而"换配方"(改训练与部署策略)的收益越来越大——这正是 YOLOv4 开启的工程优化时代延续至今的原因。选型时不用追最新版本号,先看自己卡在哪个环节:速度不够调重参数化,精度不够调训练配方,部署麻烦换统一框架。对多数业务而言,把训练配方和部署链路打磨好,比换一个更新版本号收益更确定。
⚠️ 版本混乱:YOLOv6/v7/v8 来自不同团队,命名不连续,别纠结"正统"。按需求选:工程化用 v5/v8,工业部署看 v6,架构创新看 v7。
💡 关键直觉:YOLO 进入诸国时代:v6(美团工业)、v7(原作者架构创新)、v8(Ultralytics 集大成)。趋势是 anchor-free(去锚点直接预测中心)。选型按需求,别纠结版本号。
重点提炼
- 诸国时代:v6(美团)、v7(原作者团队)、v8(Ultralytics)多家并行。
- YOLOv6:美团,RepVGG 风格、anchor-free、解耦头,工业部署。
- YOLOv7:E-ELAN、重参数化、辅助头,架构创新。
- YOLOv8:anchor-free、解耦头、无 NMS 训练、统一框架(检测/分割/姿态/分类)。
- anchor-free 趋势:去锚点直接预测中心,更简洁泛化好(FCOS/CenterNet/YOLOX/v6/v8)。
- 其他:YOLOX、v9(可编程梯度)、v10(无 NMS)。
- 选型:按需求选,别纠结版本号。
下一节看其他单阶段检测器。