5.1 非极大值抑制 (NMS) 及其改进
5.1 非极大值抑制 (NMS) 及其改进
本节摘要:检测器输出大量重叠框,NMS 去重保留最优。本节讲 NMS 原理和 Soft-NMS、DIoU-NMS 等改进——检测后处理的关键。
本节目标
阅读完本节,你应当能够:
- 理解 NMS 原理
- 知道 NMS 的痛点
- 了解 Soft-NMS 和 DIoU-NMS
概念脉络
一、为什么需要 NMS
检测器对同一目标会输出多个重叠框(不同锚点、不同位置预测),需要去重,只保留最优框。NMS(Non-Maximum Suppression)就是这个去重过程。
为什么会有大量重叠框?以 anchor-based 为例,同一个目标附近可能有几十个锚点都被预测成前景,输出几十个框,它们 IoU 都很高。如果不抑制,最终结果会重复报告同一个目标。NMS 的思路是"留下最自信的那个,压掉和它高度重叠的"。
二、NMS 原理
图 5-1 NMS 流程
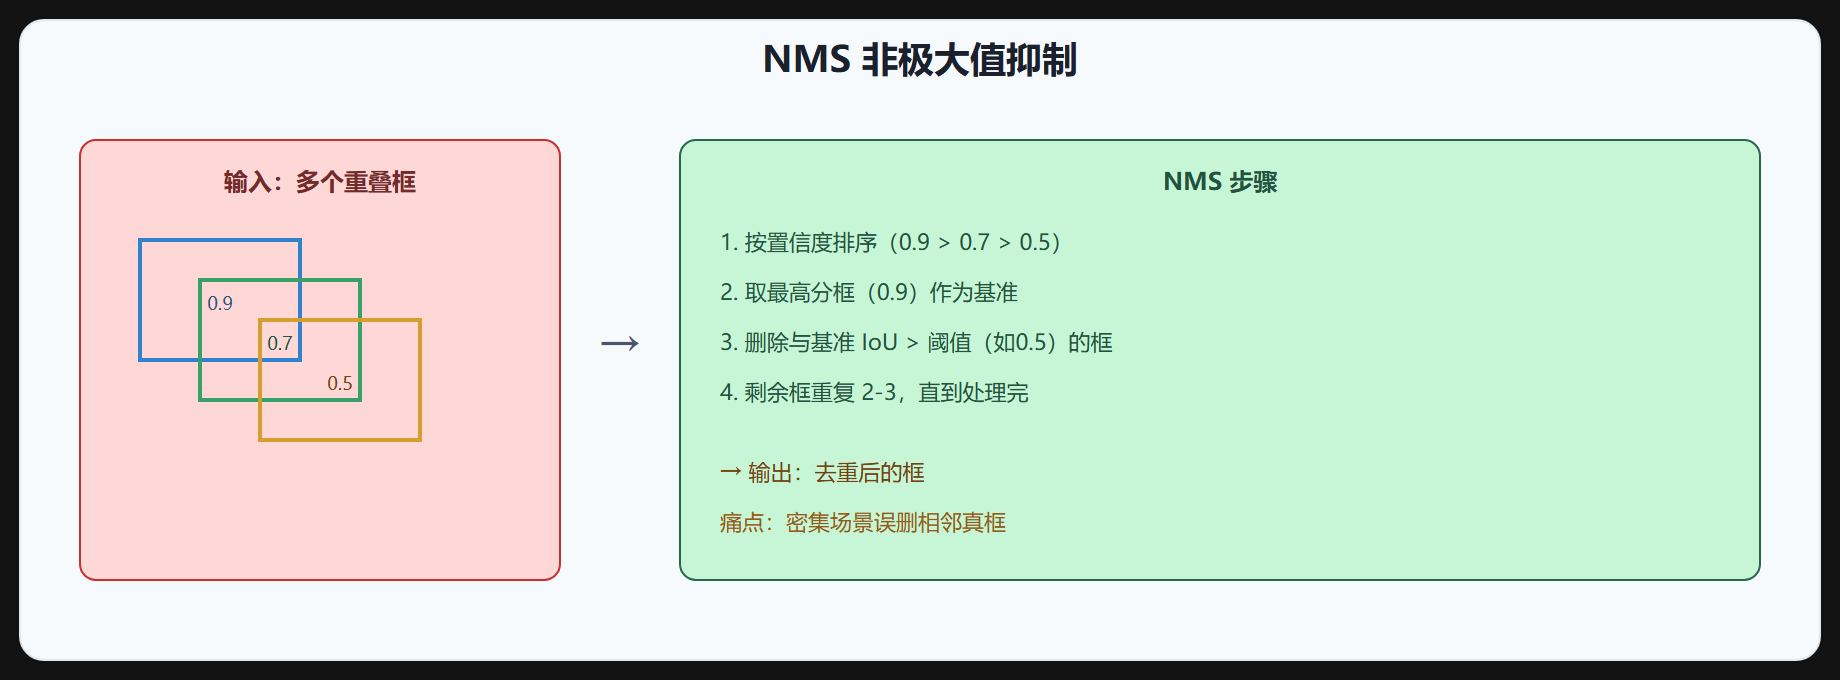
NMS 步骤:
- 按置信度排序所有框
- 取最高分框作为基准,加入结果
- 删除与基准 IoU > 阈值(如 0.5)的框
- 剩余框重复 2-3,直到处理完
def nms(boxes, scores, iou_threshold=0.5): order = scores.argsort()[::-1] # 按分数降序 keep = [] while order.size > 0: i = order[0]; keep.append(i) ious = iou(boxes[i], boxes[order[1:]]) order = order[1:][ious < iou_threshold] # 删除高IoU框 return keep
注意 NMS 是逐类别进行的:不同类别的框即使完全重叠也不互相抑制,因为一个目标只能对应一个类别(多标签场景除外)。实际实现里先按类别分组,每组单独做 NMS,再把结果合并。
三、NMS 的痛点
NMS 在密集场景会误删:
- 密集目标:相邻行人框 IoU 高,NMS 误删真框
- 阈值敏感:阈值低漏删,阈值高误删
- 硬删除:直接删框,不可恢复
NMS 的假设是"同一目标的高分框应该获胜,重叠的是冗余"。但密集场景里这个假设不成立:两个相邻行人的框 IoU 可能超过 0.5,后一个行人框被当成"冗余"直接删除,造成漏检。阈值调低(0.3)会保留更多框但重复增多,调高(0.7)误删更严重——NMS 对阈值的选择很脆弱。
四、Soft-NMS
Soft-NMS 不直接删除重叠框,而是降低其分数:
重叠框分数降低而非删除,密集场景保留更多真框。Soft-NMS 不增加推理开销,是即插即用改进。
# Soft-NMS:重叠框降分而不是删除 def soft_nms(boxes, scores, sigma=0.5, thresh=0.001): order = scores.argsort()[::-1] keep = [] while order.size > 0: i = order[0] keep.append(i) ious = iou(boxes[i], boxes[order[1:]]) # 线性或高斯降权 scores[order[1:]] *= np.exp(-ious ** 2 / sigma) # 高斯版 order = order[1:][scores[order[1:]] > thresh] return keep
关键区别:标准 NMS 把重叠框"杀"掉(从候选列表删除),Soft-NMS 只是"削弱"(分数乘衰减系数)。如果被削弱后分数仍高于最终阈值,框还能保留下来。实验上 Soft-NMS 在密集场景能挽回 1~2 个点的 mAP,且不改训练、不增加延迟。
五、DIoU-NMS
YOLOv4 提出 DIoU-NMS,在 NMS 判断时不仅看 IoU,还看中心点距离:
- 两个框 IoU 高但中心距离远 → 可能是不同目标,保留
- 两个框 IoU 高且中心近 → 同一目标,删除
DIoU-NMS 在密集场景比标准 NMS 更准。
# DIoU-NMS:抑制条件 = IoU 高 且 中心距离近 def diou_nms(boxes, scores, iou_threshold=0.5): order = scores.argsort()[::-1] keep = [] while order.size > 0: i = order[0]; keep.append(i) dious = diou(boxes[i], boxes[order[1:]]) # DIoU 包含中心距离惩罚 order = order[1:][dious < iou_threshold] return keep
DIoU 的值等于 IoU 减去中心距离惩罚项,两个框 IoU 相同但中心离得远,DIoU 更小,更不容易被抑制。密集人群里相邻行人的框 IoU 高但中心点分离,DIoU-NMS 能把它们都保住。
六、其他改进
| 改进 | 说明 |
|---|---|
| Soft-NMS | 降分而非删除 |
| DIoU-NMS | 加中心距离 |
| Adaptive NMS | 自适应阈值(密集用低阈值) |
| Center NMS | 中心点检测配 NMS |
| 无 NMS(YOLOv8/v10) | 一致性损失训练,推理免 NMS |
七、无 NMS 趋势
NMS 是后处理,增加延迟和超参。新趋势用一致性损失训练,让模型直接输出无冗余框,推理免 NMS(YOLOv8、YOLOv10)。这是端到端检测的方向。
无 NMS 的思路:在训练时用"一对一匹配"(每个真值只分配一个预测),配合一致性损失惩罚重复预测,模型学到"每个目标只出一个框"。推理时直接按分数阈值取框,省掉 NMS 环节,减少延迟也减少一个调参点。代价是训练需要更精细的标签分配,早期收敛略慢。
八、工程实践建议
- 先用标准 NMS 跑通,看重复框和漏检情况
- 密集场景换 Soft-NMS 或 DIoU-NMS,成本几乎为零
- 阈值从 0.5 起步,在验证集上扫 0.3-0.7 选最优
- 追求端到端再考虑无 NMS 方案
问:NMS 阈值和置信度阈值的关系? 置信度阈值过滤低分框(前置),NMS 去重(后置),两者配合使用。置信度阈值提高会减少进入 NMS 的框数,也影响最终召回。
⚠️ NMS 阈值:阈值低(0.3)漏删多框,阈值高(0.7)误删真框。密集场景用低阈值或 Soft-NMS/DIoU-NMS。
💡 关键直觉:NMS 去重保留最优框(按分数排序,删高 IoU 框)。密集场景误删真框,Soft-NMS 降分不删,DIoU-NMS 加中心距离。趋势是无 NMS(一致性损失训练)。
温故知新
- 作用:去重,同一目标多个框只保留最优。
- NMS 步骤:按分数排序→取最高→删高 IoU 框→重复,逐类别进行。
- 痛点:密集场景误删真框、阈值敏感、硬删除。
- Soft-NMS:降分而非删除,密集场景保留更多真框,即插即用。
- DIoU-NMS:加中心点距离,IoU 高但中心远则保留。
- 其他:Adaptive NMS(自适应阈值)。
- 无 NMS 趋势:一致性损失训练,推理免 NMS(YOLOv8/v10)。
- 实践:密集场景先换 Soft/DIoU-NMS,阈值在验证集上扫。
下一节讲 FPN。