5.2 特征金字塔网络 (Feature Pyramid Network, FPN)
5.2 特征金字塔网络 (FPN)
本节摘要:FPN 解决多尺度检测难题。本节讲它的自底向上、自顶向下、横向连接——让检测器同时处理大小目标。
你能学到什么
阅读完本节,你应当能够:
- 理解多尺度检测难题
- 说清 FPN 的结构
- 知道 PANet 等改进
概念脉络
一、多尺度检测难题
同一张图里,目标尺度差几十倍(近处人占满画面,远处人几十像素)。单一尺度特征图处理不了——浅层分辨率高但语义弱,深层语义强但分辨率低。
这是目标检测里最根本的矛盾之一:分辨率 vs 语义。浅层特征图(如 stride 4/8)保留细节但没"看懂"内容,深层特征图(如 stride 32)语义明确但小目标早已消失。单尺度检测被迫二选一,怎么选都会有一类目标遭殃。
二、早期方案
- 图像金字塔:多分辨率输入,各自检测,慢且费内存
- 单层特征:只用最后一层,小目标差
- SSD 多层:用不同层级特征图,但无融合
图像金字塔把输入缩放成多个分辨率,每个分辨率单独跑一遍网络再合并结果,能解决多尺度但计算量成倍增加,实时场景根本用不起。SSD 直接用不同层特征图做检测,比单层好,但浅层特征"语义弱"的问题没解决——它只是在"矮子里拔将军"。
三、FPN 核心思想
FPN(Feature Pyramid Network)融合深层语义和浅层细节,生成多层级特征金字塔,每层都语义强且分辨率合适。
图 5-2 FPN 结构
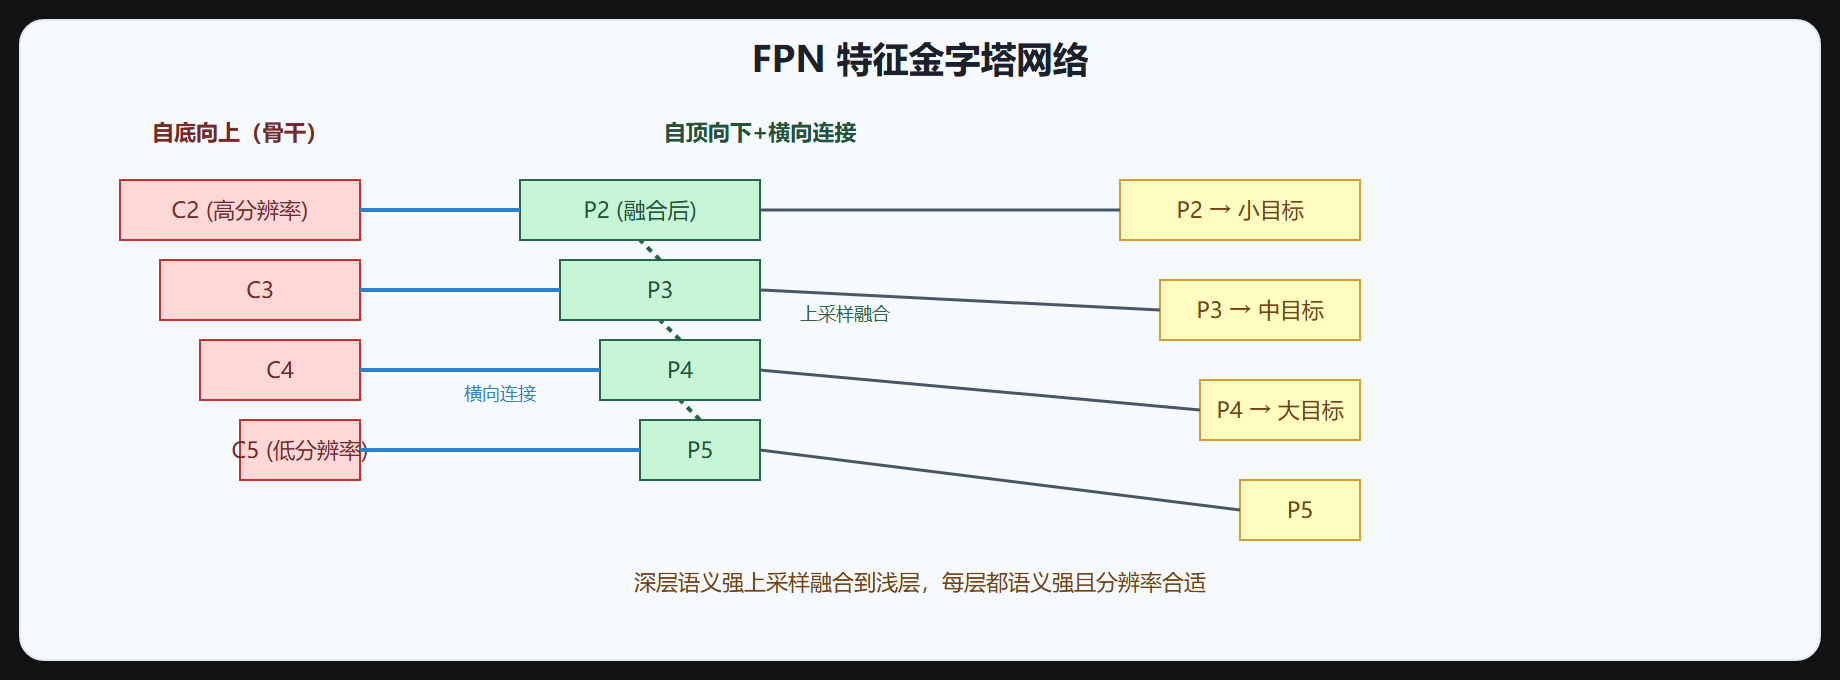
FPN 三部分:
- 自底向上:骨干网络前向,得各层级特征图(C2-C5,分辨率递减)
- 自顶向下:深层特征上采样
- 横向连接:上采样特征与同层浅层特征融合(1x1 卷积对齐通道 + 相加)
结果:每层特征图(P2-P5)都语义强且分辨率合适,不同尺度目标用不同层检测。
# FPN 核心:横向连接 + 自顶向下融合 def fpn(c2, c3, c4, c5): """c2..c5 是骨干输出,分辨率递减""" p5 = conv1x1(c5) # 先 1x1 对齐通道 p4 = conv1x1(c4) + upsample(p5) # 上采样相加融合 p3 = conv1x1(c3) + upsample(p4) p2 = conv1x1(c2) + upsample(p3) # 每层再接 3x3 卷积消除上采样锯齿 return [conv3x3(p2), conv3x3(p3), conv3x3(p4), conv3x3(p5)]
为什么加 1x1 卷积?深层特征(如 256 通道)和浅层特征(如 512 通道)通道数不一致,相加前要先对齐;1x1 卷积顺带做了通道投影。相加是逐元素求和,位置一一对应,上采样的深层特征刚好"指导"浅层特征的语义。
四、FPN 检测
FPN 的各层特征图分别接检测头:
- P2(高分辨率)→ 小目标
- P3/P4 → 中等目标
- P5(低分辨率)→ 大目标
检测时还有个分配规则:RoI(候选框)按面积大小分配到对应层级,小框去 P2/P3,大框去 P4/P5。这样每个检测头专注自己擅长的尺度,不用一个头硬扛所有目标。
五、PANet 改进
PANet 在 FPN 自顶向下基础上加自下而上路径,增强特征融合:
- FPN:自顶向下(深层→浅层)
- PANet:加自下而上(浅层→深层),双向融合
YOLOv4/v5 用 PANet,特征融合更强,小目标提升。
为什么只自顶向下不够?自顶向下路径把"语义"从深层传到浅层,但"位置/细节"从浅层传到深层缺少捷径,大目标的定位信息要到很后面才被利用。PANet 加一条自下而上路径,让浅层细节也能快速到达深层,双向融合后各层特征更全面。
六、其他改进
| 改进 | 说明 |
|---|---|
| PANet | 加自下而上路径,双向融合 |
| BiFPN | 加权双向 FPN,EfficientDet |
| NAS-FPN | 神经架构搜索 FPN 结构 |
| FPN+PANet | YOLOv4/v5 标准 |
BiFPN 给不同层级的融合加可学习权重:浅层细节和深层语义对最终特征贡献不同,权重让网络自己学谁更重要。同时去掉单输入节点,进一步减计算。EfficientDet 用 BiFPN + 复合缩放,在效率和精度上都取得了好成绩。
七、FPN 的影响
FPN 是多尺度检测的标准方案,几乎所有现代检测器都用:
- Faster R-CNN + FPN
- RetinaNet(FPN 是基础)
- YOLOv3+(多尺度思想源自 FPN)
可以说,FPN 之后"多尺度"从可选技巧变成了标配。凡是在 2020 年后出现的检测器,几乎都能在结构图里找到金字塔式的特征融合——这个影响的广度,只有 NMS 能与之相比。
八、工程注意
- 输入分辨率:FPN 的 P2 层需要足够大的输入才能保住小目标,小输入(320)时 P2 只有 40x40,小目标信息仍有限
- 计算开销:每层都接检测头会增加计算量,轻量版可以只保留 P3-P5
- 训练分配:标签分配要配合多尺度,小目标样本集中到浅层,别让深层检测头背小目标锅
问:FPN 和图像金字塔可以一起用吗? 可以。FPN 是特征空间的多尺度,图像金字塔是输入空间的多尺度,两者叠加(如多尺度测试、TTA)还能再提精度,代价是推理时间成倍增加。
⚠️ FPN 不是简单用多层:SSD 也用多层特征图,但无融合,浅层语义弱。FPN 关键是融合深层语义到浅层,让每层都语义强。
💡 关键直觉:FPN 融合深层语义和浅层细节,自顶向下上采样+横向连接,生成多层级特征金字塔。不同尺度目标用不同层检测。PANet 加自下而上双向融合。FPN 是多尺度检测标准。
要点速记
- 难题:目标尺度差几十倍,单一特征图处理不了(分辨率 vs 语义矛盾)。
- 早期:图像金字塔(慢)、单层(小目标差)、SSD 多层(无融合)。
- FPN:自底向上(骨干)+自顶向下(上采样)+横向连接(融合),每层语义强分辨率合适。
- 检测:P2 小目标,P3/P4 中,P5 大目标,RoI 按面积分配层级。
- PANet:加自下而上路径,双向融合,YOLOv4/v5 用。
- 其他:BiFPN(加权双向)、NAS-FPN(架构搜索)。
- 影响:多尺度检测标准,现代检测器标配。
下一节讲 anchor 范式之争。