5.4 关键技术:数据增强、训练策略、模型蒸馏、量化等
5.4 关键技术:数据增强、训练策略、模型蒸馏、量化
本节摘要:检测器的性能不只靠架构,还靠训练和部署优化。本节讲数据增强、训练策略、模型蒸馏、量化——让模型训得更好、跑得更快的工程手段。
先说结论
阅读完本节,你应当能够:
- 掌握检测训练策略
- 理解模型蒸馏
- 理解模型量化
概念脉络
一、数据增强(回顾)
第 2.5 节详述,这里强调检测特有:
- Mosaic:4 图拼接,丰富上下文,YOLOv4 首创
- MixUp/CutMix:混合增强
- Copy-Paste:把目标粘贴到不同背景(实例分割)
- 多尺度训练:随机改输入尺寸,尺度鲁棒
数据增强在检测里的地位:同样的骨干和损失,增强策略不同可以差 3~5 个点 mAP。它不是锦上添花,而是训练配方的主料。Copy-Paste 特别适合实例分割和小目标场景:把标注好的目标"抠"出来随机粘贴,等于凭空造出大量多样样本。
二、训练策略
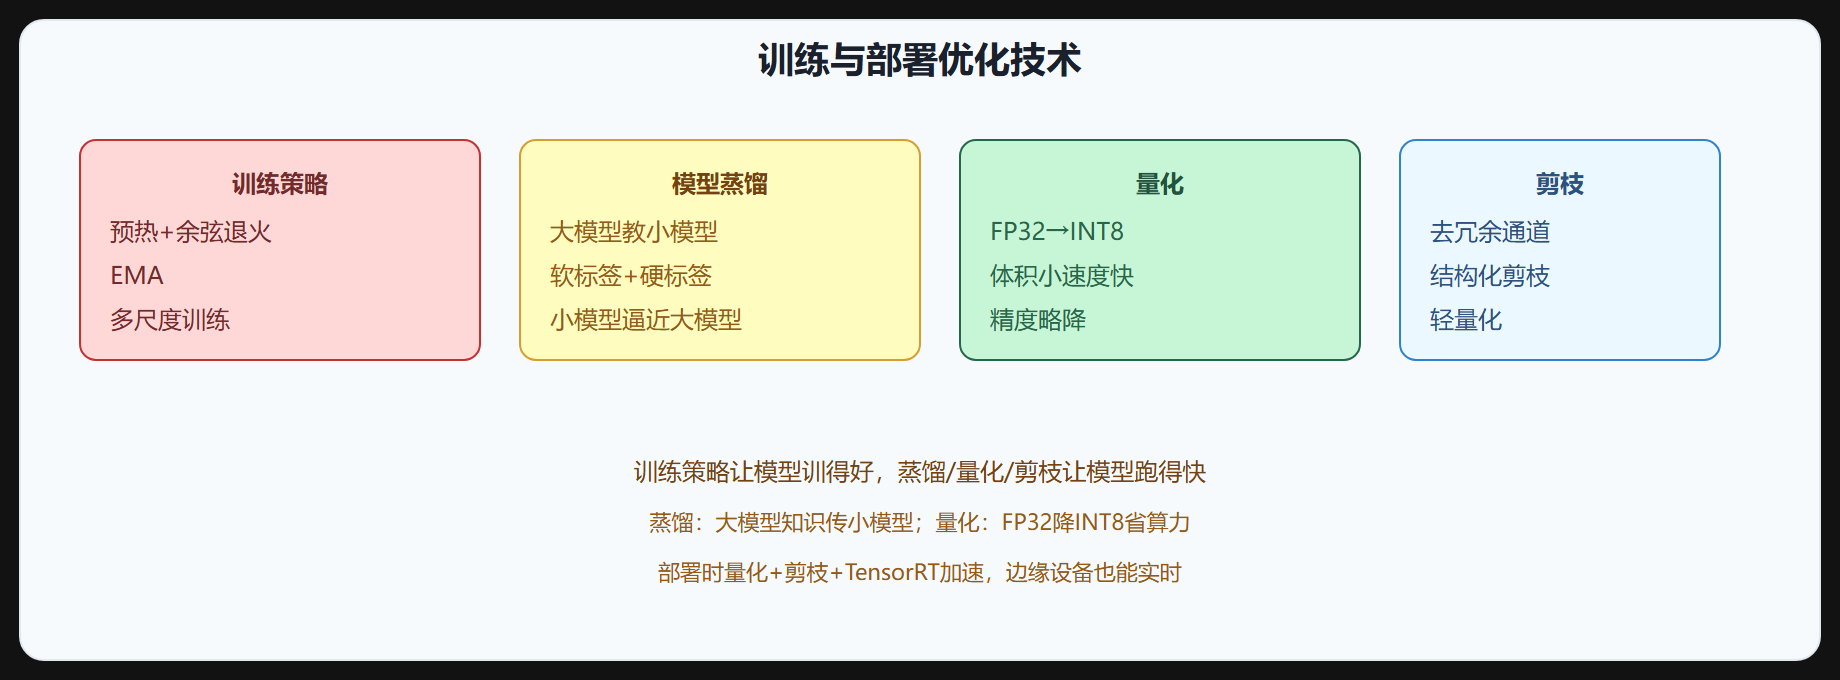
图 5-4 训练与部署优化
| 策略 | 说明 |
|---|---|
| 预热 | 小学习率起步,稳定初期 |
| 余弦退火 | 平滑降学习率,精调收敛 |
| EMA | 指数移动平均权重,提升泛化 |
| 多尺度训练 | 随机改输入尺寸,尺度鲁棒 |
| 混合精度 | FP16 加速省显存 |
| 梯度裁剪 | 防梯度爆炸 |
两个容易被忽略的策略:EMA 在训练末尾常带来 0.5~1 个点提升,几乎零成本;多尺度训练让模型对部署时的输入分辨率不敏感,YOLO 系默认开启。这些策略叠加起来,往往比换一个更大的模型更划算。
三、模型蒸馏
模型蒸馏(Knowledge Distillation)用大模型(教师)指导小模型(学生):
- 软标签:教师输出的概率分布(含类间关系)
- 硬标签:真实标签
- 学生损失 = 软标签损失 + 硬标签损失
# 蒸馏损失 loss = α * soft_loss(student_logits, teacher_logits) + (1-α) * hard_loss(student_logits, labels)
蒸馏让小模型接近大模型精度,部署用小模型省算力。检测中可蒸馏特征、框预测、分类。
为什么软标签有效?真实标签(硬标签)只告诉学生"这是猫",教师输出的软标签还带"它 0.7 像猫、0.2 像狗、0.1 像狐狸"的信息,把类间相似结构传授给学生。学生从软标签里学到的不只是答案,还有"知识形状"。检测蒸馏比分类复杂:除了分类软标签,还要蒸馏框回归的中间特征(feature distillation)、候选区域分布等,实现上更讲究。
# 检测特征蒸馏示意:让学生特征对齐教师特征 def feature_distill_loss(student_feat, teacher_feat): # 教师特征不反传梯度 return F.mse_loss(student_feat, teacher_feat.detach())
四、模型量化
量化把 FP32 权重降到低精度(INT8/FP16):
| 量化 | 说明 |
|---|---|
| FP32 | 默认,精度高 |
| FP16 | 混合精度,2 倍加速 |
| INT8 | 量化,4 倍加速,精度略降 |
| INT4 | 极致压缩,精度降明显 |
量化分:
- 训练后量化(PTQ):训练完直接量化,简单
- 量化感知训练(QAT):训练时模拟量化,精度保持好
# PyTorch 量化感知训练 model.qconfig = torch.quantization.get_default_qconfig('fbgemm') model = torch.quantization.prepare_qat(model) # 训练后转换 model = torch.quantization.convert(model)
为什么 INT8 量化会掉精度?把连续浮点权重映射到 256 个离散值有舍入误差,且激活值分布不均时误差被放大。QAT 在训练时就模拟量化(前向用量化权重、反向仍用浮点梯度),让网络适应量化噪声,掉点从 1~2 个 mAP 压到 0.3 以内。检测模型的量化还要小心:分类分支和回归分支对量化敏感度不同,常见做法是分类量化、回归保持高精度。
五、剪枝
剪枝去掉冗余参数:
- 非结构化剪枝:去单个权重,稀疏但硬件难加速
- 结构化剪枝:去整个通道/层,硬件友好,常用
剪枝后微调恢复精度。
非结构化剪枝产生稀疏矩阵,理论上压缩率高,但当前硬件对稀疏矩阵的加速支持有限,收益主要在存储。结构化剪枝整通道移除,配合标准卷积库直接提速,是工程落地的主流。检测里常按"通道重要度"(如 BN 缩放因子大小)排序剪枝,剪完微调几个 epoch 恢复精度。
六、部署加速
| 技术 | 说明 |
|---|---|
| TensorRT | NVIDIA 推理优化,层融合+量化 |
| ONNX Runtime | 跨平台推理 |
| OpenVINO | Intel CPU 优化 |
| NCNN/MNN | 移动端推理 |
七、端到端部署流程
- 训练大模型(高精度)
- 蒸馏到小模型(保精度)
- 量化(INT8/FP16)
- 剪枝(去冗余)
- 转 ONNX/TensorRT
- 部署推理
问:这些技术的顺序能换吗? 建议先蒸馏再量化:蒸馏把教师知识迁给学生后,学生再量化,比直接量化原模型更稳。剪枝和量化可以组合(结构化剪枝 + INT8),每一步做完都要在验证集上确认掉点。
八、工程收益估算
| 手段 | 典型收益 | 代价 |
|---|---|---|
| EMA | mAP +0.5~1 | 训练内存略增 |
| 多尺度训练 | 尺度鲁棒 +1~2 | 训练时间略增 |
| 蒸馏 | 小模型接近大模型 | 需要训练好的教师 |
| INT8 量化 | 推理 4 倍加速 | mAP -0.3~2 |
| 结构化剪枝 | 推理 1.5~2 倍加速 | 微调恢复精度 |
⚠️ 量化精度损失:INT8 量化可能掉几个 mAP,关键场景用 QAT(量化感知训练)保持精度,或用 FP16 折中。
💡 关键直觉:训练策略(预热/余弦/EMA/多尺度)让模型训得好。蒸馏(大模型教小模型)压缩保精度。量化(FP32→INT8)省算力。剪枝去冗余。部署用 TensorRT/ONNX 加速。端到端:训大→蒸馏→量化→剪枝→部署。
核心回顾
- 数据增强:Mosaic、MixUp、Copy-Paste、多尺度训练。
- 训练策略:预热、余弦退火、EMA、混合精度、梯度裁剪。
- 蒸馏:教师软标签+硬标签指导学生,小模型接近大模型精度。
- 量化:FP32→FP16/INT8,PTQ 简单、QAT 保精度,4 倍加速。
- 剪枝:结构化剪枝去冗余通道,硬件友好。
- 部署加速:TensorRT、ONNX Runtime、OpenVINO、NCNN/MNN。
- 流程:训大→蒸馏→量化→剪枝→转格式→部署。
第 5 章结束。下一章讲评估与工程实践。