5.3 Anchor-based 与 Anchor-free 检测器
5.3 Anchor-based 与 Anchor-free 检测器
本节摘要:检测器要不要预设锚点?本节讲 anchor-based 和 anchor-free 两种范式——预测框的两种思路。
阅读收获
阅读完本节,你应当能够:
- 理解 anchor-based 范式
- 理解 anchor-free 范式
- 知道两者的优劣
概念脉络
一、预测框的两种思路
检测器要预测边界框,有两种范式:
- anchor-based:预设一组参考框(锚点),预测相对锚点的偏移
- anchor-free:不预设锚点,直接预测框(中心点、角点等)
这个选择决定了检测器的"预测语言":是"在参考框上做修正",还是"从零说出框"。它影响训练稳定性、超参数量、泛化能力,是 2019 年前后目标检测最热闹的范式之争。
二、anchor-based
图 5-3 anchor-based vs anchor-free
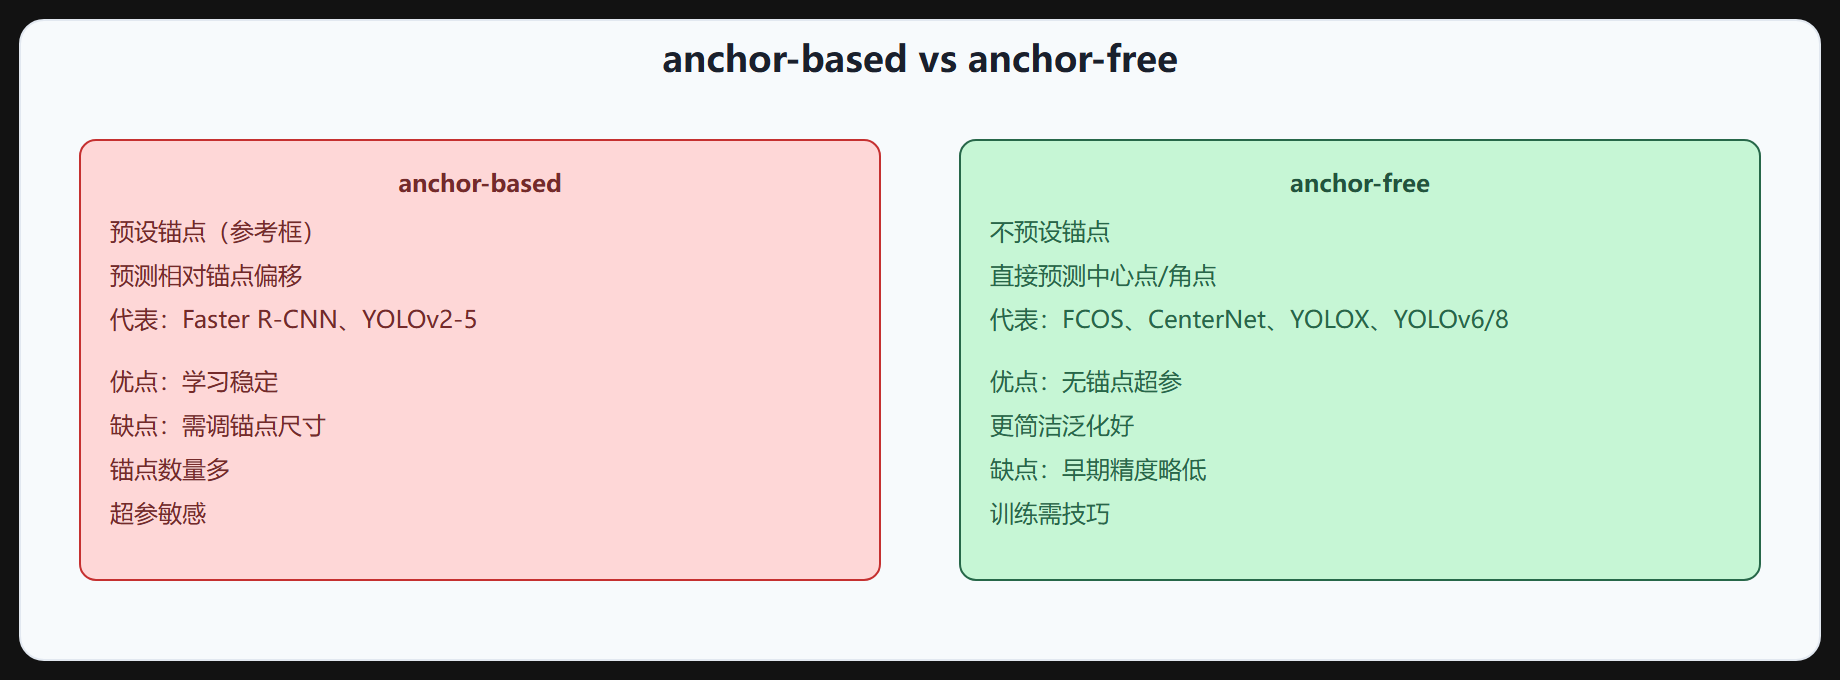
anchor-based 预设一组锚点(不同尺度、长宽比),每个位置预测相对锚点的偏移和类别:
- 锚点是参考框,模型在锚点基础上回归微调
- 锚点尺寸通常用 K-means 聚类在训练集确定
- 代表:Faster R-CNN、SSD、YOLOv2-v5、RetinaNet
优点:学习稳定(有参考),精度高
缺点:需调锚点尺寸超参,锚点数量多计算大,对数据分布敏感
# anchor-based 的预测解码:预测偏移 + 锚点 = 最终框 def decode_anchor_based(pred_deltas, anchors): """pred_deltas: 预测的 [dx, dy, dw, dh]""" cx = anchors[:, 0] + pred_deltas[:, 0] * anchors[:, 2] cy = anchors[:, 1] + pred_deltas[:, 1] * anchors[:, 3] w = anchors[:, 2] * torch.exp(pred_deltas[:, 2]) h = anchors[:, 3] * torch.exp(pred_deltas[:, 3]) return cx, cy, w, h
锚点机制的代价:一张 416x416 图,13x13 特征图每位置 3 个锚点,就有 507 个框要预测,绝大多数是背景。锚点多了计算浪费,锚点少了覆盖不到目标形状。而且锚点尺寸是"先验",来自训练数据的聚类,换数据集(比如从人检测换成工业零件)要重新聚类。
三、anchor-free
anchor-free 不预设锚点,直接预测框:
- FCOS:预测中心点到四边的距离
- CenterNet:预测中心点和宽高
- CornerNet:预测左上右下角点
优点:无锚点超参,更简洁,泛化好
缺点:早期精度略低,训练需技巧(中心采样、低质量框过滤)
四、FCOS 详解
FCOS(Fully Convolutional One-Stage)是 anchor-free 代表:
- 每个特征图位置预测:中心度(是否是目标中心)+ 到四边距离 (l,t,r,b) + 类别
- 中心度加权过滤低质量框
- 用 FPN 多尺度解决重叠
FCOS 证明 anchor-free 可达 anchor-based 精度,推动 anchor-free 趋势。
# FCOS 预测解码:到四边距离 -> 框 def decode_fcos(distances, grid_xy, strides): """distances: [l, t, r, b] 到四边的距离""" l, t, r, b = distances.unbind(dim=1) cx = grid_xy[..., 0] * strides cy = grid_xy[..., 1] * strides x1 = cx - l; y1 = cy - t x2 = cx + r; y2 = cy + b return x1, y1, x2, y2
FCOS 的"中心度"是个巧妙设计:距离目标中心越近的位置,中心度越高;推理时中心度与分类分数相乘,过滤掉那些"框得对但中心偏了"的低质量预测。它用 FPN 把不同尺寸的目标分散到不同层,缓解"一个特征点对应多个重叠目标"的问题。
五、两种范式对比
| 维度 | anchor-based | anchor-free |
|---|---|---|
| 预测 | 相对锚点偏移 | 直接预测框 |
| 超参 | 锚点尺寸 | 无锚点超参 |
| 数量 | 锚点多 | 每位置一个 |
| 稳定性 | 学习稳定 | 需训练技巧 |
| 泛化 | 对数据敏感 | 更泛化 |
| 代表 | Faster R-CNN、YOLOv2-5 | FCOS、YOLOX、YOLOv6/8 |
六、趋势
anchor-free 是趋势:
- YOLOv6/v8 转向 anchor-free
- YOLOX 早期探索 anchor-free
- YOLOv9/v10 延续
- 学术界 FCOS、CenterNet 已证明可行
但 anchor-based 仍广泛使用(YOLOv5、Faster R-CNN),两者并非替代关系,按场景选。
为什么趋势是 anchor-free?三个原因:一是少超参,anchor 的尺寸、数量、分配规则都不需要设了;二是结构简洁,不用维护"锚点表"和对应的匹配逻辑;三是对新数据更友好,不用每次换数据都重新聚类锚点。但要注意,anchor-free 并非"免费"——它把复杂度从锚点转移到了标签分配和中心采样策略上,实现细节反而更多。
七、选择建议
| 场景 | 推荐 |
|---|---|
| 数据分布稳定 | anchor-based(调好锚点) |
| 多样化数据 | anchor-free(泛化好) |
| 简洁部署 | anchor-free(少超参) |
| 追求极致精度 | 两者都可,看工程优化 |
问:anchor-free 一定更好吗? 不一定。两者精度相当,差异来自工程细节(标签分配、训练策略)多于范式本身。选型看团队熟悉度:调过锚点的团队留在 anchor-based 也能做到同样精度,新项目从 anchor-free 起步更省心。若数据形状分布特殊(极端长宽比目标多),anchor-based 精心聚类锚点仍可能略占优。
⚠️ 常见误区:以为 anchor-free 一定更好。两者精度相当,anchor-free 优势在少超参和泛化,anchor-based 优势在稳定。按场景选,不是替代关系。
💡 关键直觉:anchor-based 预设锚点预测偏移(稳定但需调超参),anchor-free 直接预测框(简洁泛化但需训练技巧)。趋势是 anchor-free(YOLOv6/8),但两者并存按场景选。
一节小结
- anchor-based:预设锚点,预测相对偏移,代表 Faster R-CNN/YOLOv2-5,稳定但需调超参。
- anchor-free:直接预测中心点/角点,代表 FCOS/CenterNet/YOLOX/YOLOv6/8,简洁泛化但需训练技巧。
- FCOS:预测中心度+到四边距离+类别,证明 anchor-free 可行。
- 对比:anchor-based 稳定但超参多,anchor-free 简洁但需技巧。
- 趋势:anchor-free 是趋势(YOLOv6/8/9/10),但两者并存。
- 选择:数据稳定用 anchor-based,多样数据/简洁部署用 anchor-free。
下一节讲训练优化技术。