1.2 激活、损失、优化器:天平的三个砝码
1.2 激活、损失、优化器:天平的三个砝码
本节摘要:把三要素摆上同一张天平桌:激活函数管"表达力"、损失函数管"刻度与方向"、优化器管"步伐与速度"。本节用表格逐一称量每方的职责、它面临的张力,并让三者对齐到前向与反向的具体环节,建立起全书共用的观察框架。
上一节我们把优化拆成了三个问号。这一节不再停在抽象层面,而是给它们各自"领个工位",看这三样东西在前向、反向两条路上各站哪儿。学完后你应该能指着任意一段训练日志,说出是哪个环节在制造嘈杂。
三种职责,一台天平
我们给三要素各派一个比喻角色,它们共同构成那一台天平:
- 损失函数=刻度尺。它负责说"错得有多深"。刻度尺挂在目标端,天平的平衡点由它定义。它越合理,优化器看到的"偏了多少"才越真实。
- 激活函数=表达力的砝码。它让节点有能力表示非线性关系,也就是给了这个网络"能学会多复杂的花样"的上限。砝码选得不好——比如全是线性函数——再好的刻度尺和再快的手也白搭。
- 优化器=搬砝码的手。它在每次称量后,决定把参数往哪个方向推、推多远。手稳还是手抖,直接决定天花板前还能走多快。
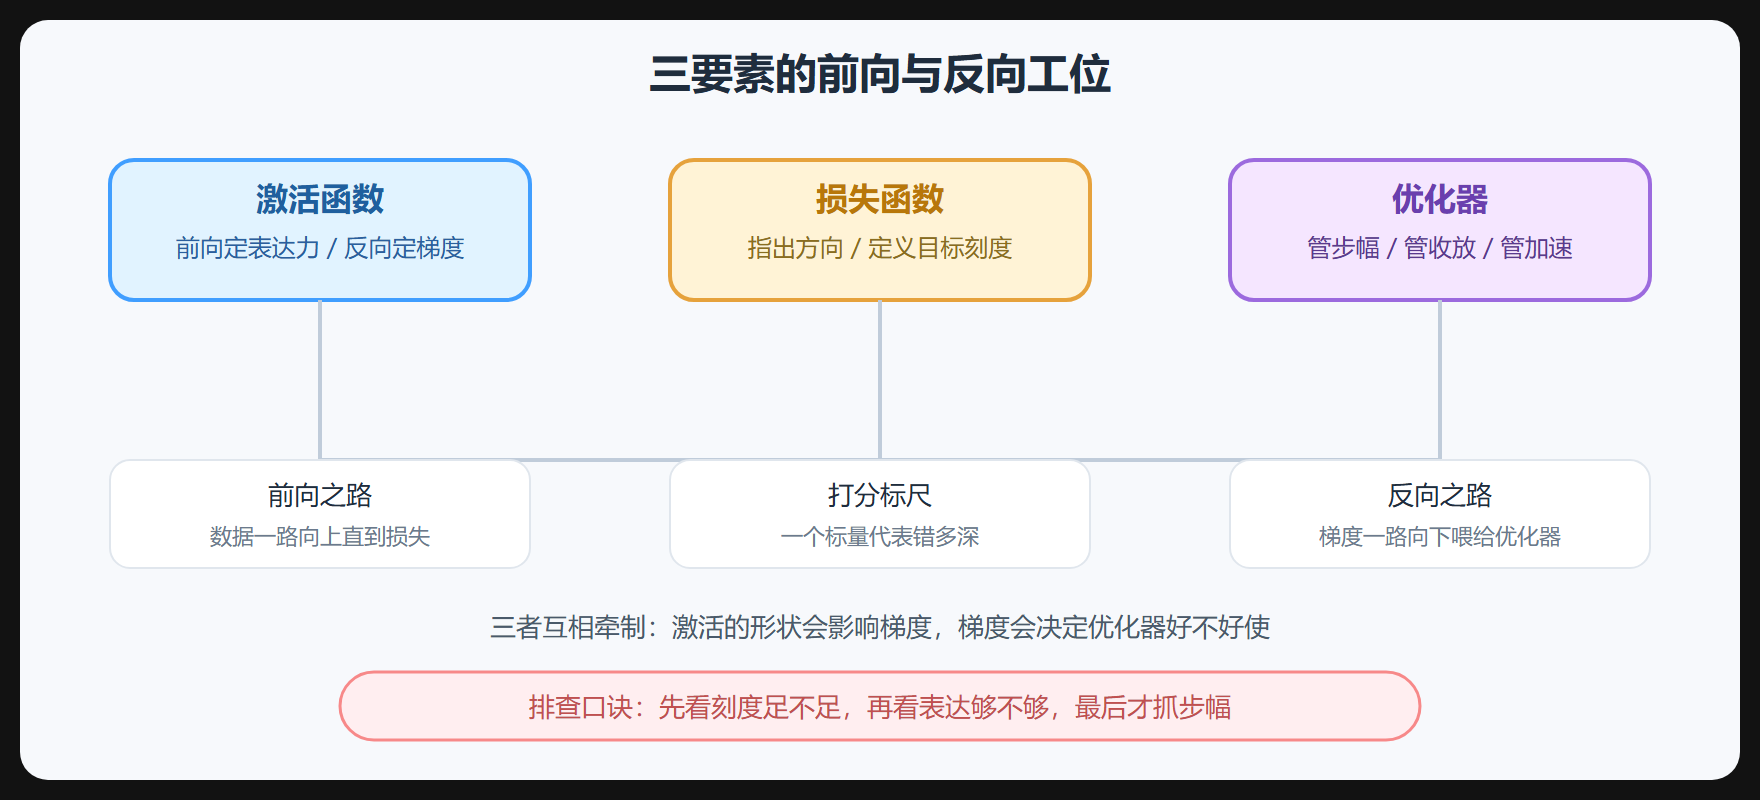
一句话把它们焊起来:激活函数决定网络能表达什么,损失函数决定要往哪调,优化器决定这一步怎么走。
它们各自站在哪一环
把三句话落到一次完整训练里,位置非常清晰:
| 环节 | 谁登场 | 它的输入 | 它的输出 |
|---|---|---|---|
| 前向传播 | 激活函数 | 上一层的加权求和值 | 本层的激活值 |
| 打分 | 损失函数 | 网络预测与真实标签 | 一个损失标量 |
| 反向传播 | (梯度经由每个激活函数求导) | 损失 | 每层参数的梯度 |
| 参数更新 | 优化器 | 梯度与历史状态 | 更新后的参数 |
注意一个容易被忽略的细节:激活函数同时站在"前向"和"反向"两条路上。 前向它决定表达力,反向它还在算梯度——而梯度一穿再多层就变小(后面第 2 章会讲到梯度消失),所以激活函数的形状甚至会反过来拖累优化器的收敛。这就是三个砝码互相牵制的第一处实锤。
一个串起全过程的例子
设想你在训练一个手写数字的分类网络。数据是 28×28 的灰度图,标签是 0 到 9。
- 前向时,每一层输出先过一个线性加权,再过一个激活函数(比如 ReLU)引入非线性,最后一层用 Softmax 把输出压成十个数字的"概率"。
- 到打分环节,损失函数拿这十个概率与真实的 one-hot 标签一对,算出交叉熵损失(第 3 章会展开),告诉你网络这次猜得多离谱。
- 反向传播顺着计算图把损失的梯度传回每层,在这个过程中对每一个 ReLU 求导。
- 最后优化器拿着各层梯度,按"减去学习率乘梯度"的规则,把每一层参数搬一搬。
这四步跑完一遍,就是一个 batch 的训练。你可以据此反推:如果是对分类任务却用了回归的平方误差损失,刻度尺本身就有问题;如果激活函数错误地用了 Sigmoid 堆了五六层,梯度早就消失得测不出来,优化器想搬也搬不动。
下面这张 SVG 把"三分工位"与训练环节对齐,方便你日后排查时一眼定位。
本节的取舍提醒
把三要素当独立旋钮,是新手最常见的误区。遇到不收敛,很多人的第一反应是"把学习率调小",却忽视了自己的损失函数是否匹配任务、激活函数是否已经在深层把梯度抹平。正确的排查顺序是把刻度(损失)、表达(激活)、步伐(优化)按顺序过一遍——这也正是本书第 2、3、4 章的编排顺序。
⚠️ 常见坑:把"损失还在降"误当成"模型在变好"。损失是通往目标的指南针,不是目标本身;它下降但验证集精度不涨,多半是拟合过猛或刻度本身不合适。
五、一个把三者"装反"的反面教材
为了彻底理解三者各管什么,最好的老师是"全装反"会怎样。我们故意把三件事接错,看会发生什么剧变:
- 刻度装反(损失不匹配):多分类任务却用了平方误差,又没有配 Softmax。结果模型只会把"全都押在某个类"当最优解,损失虽降、分类却一塌糊涂——刻度在坚定地误导方向。
- 表达装反(激活不当):隐藏层整层用 Sigmoid 堆了六七层。前向勉强还能出数,反向时梯度一层层被饱和区削掉,传到前面几层几乎为 0,浅层权重永远不动——手再快,参数也没听到指令。
- 步伐装反(优化器不当):学习率设成 1.9 还配了大动量。一步跨过整个谷底,在高坡两边来回弹,损失不降反跳,甚至发散——手太猛,把好不容易放上去的砝码又甩飞。
这三段"装反",正好反着印证了第 1.2 节那张分工图:损失定目标方向、激活定信号强弱、优化器定步幅稳定。任何一个环节崩了,练兵日志都会以完全不同的方式"烂"给你看——而这恰恰是你以后反推问题出在哪的三条线索。
六、把分工画进一张心智表格
离开之前,把三者分工压缩成随时能取用的几行。以后每遇到一个训练问题,先对号入座:
| 你看到的症状 | 更可能卡在谁 | 回头翻哪节复查 |
|---|---|---|
| 损失降了但指标不升 | 刻度(损失/输出层) | 3.3、2.3 |
| 浅层权重长期不动 | 表达(激活/初始化) | 2.4 |
| 损失锯齿、震荡 | 步伐(优化器/学习率) | 4.3、4.5 |
| 损失 NaN、乱跳 | 步伐 + 保护缺失 | 5.3 |
| 验证反弹、训练压低 | 拟合与泛化天平失衡 | 5.2 |
这张表不是真理,但它能成为你进入第 5 章"实战调试"之前的第一块敲门砖——把"现象"先归位到"三个砝码之一",你第 2–5 章读起来就会处处对上号。
七、把这台天平搬进一个真实的不收敛现场
设想你第一次接手一个老项目的迁移:原有模型换到新平台后直接不收敛,同事甩下一句"调学习率吧"。你这时候别先动邻居的旋钮,而是按这一节的排查顺序过三关。先看刻度:这个多标签分类项目,损失用的是多类交叉熵还是二元交叉熵?多数"不收敛"第一步就死在这里——标签是两个独立的正负事件,你却在用给 Softmax 派的多类交叉熵,刻度在说谎。再看表达:换平台后预训练权重的归一化方式变了,几层卷积的输出分布整个偏移,浅层梯度被抹平,表现就是"浅层不动"。最后才轮到步伐:确认前两关没问题,再回去看学习率是不是换环境后没跟着批大小一起调。
你顺着"刻度 → 表达 → 步伐"走完这一圈,往往比同事那句"先调学习率"能早半天定位。这就是第 1.2 节那张分工表在你手里第一次现实兑现——它给你的不是灵感,而是一个稳定的排除顺序。
本节要点回顾
- 三个角色:损失称刻度、激活管表达、优化器控步伐,一台天平三个配重。
- 激活的双重身份:前向决定非线性表达,反向参与求梯度,因而会拖累优化。
- 环节对齐:前向遇激活、打分遇损失、反向传梯度、更新遇优化器。
- 排查顺序:先修刻度、再看表达、最后调步伐,别一上来就拧学习率。
- 一个不收敛案例即主线:平方误差给分类、批量 Sigmoid 堆深、学习率失控,分别对应三章要拆的雷。
第 2 章先从那个"双重身份"的砝码聊起——激活函数凭什么能给网络注入非线性。