第2章 · 激活函数:给网络注入非线性
第2章 · 激活函数:给网络注入非线性
章节摘要:这一章跟着"为什么一层简单的函数能让网络神通广大"这条线走。先解释没有非线性时再怎么堆层都是白纸,再逐个审视常见激活函数的曲直与梯度品质,最后落到选型原则与三大顽疾——梯度消失、梯度爆炸、死亡 ReLU。读完后,你面对"该用哪个激活函数"时不会再靠拍脑袋。
一条主线
上一章说过,激活函数同时站在这台天平的"表达力"和"梯度"两头。这一章就沿着这两个角色依次展开:先证明它凭什么带来表达力(非线性),再看不同函数的曲线如何决定梯度好不好用,最后把这些知识接回选型与排障。 我们用"曲线的陡峭与平坦"作为贯穿视点——函数越陡,梯度越大,反向信号越足;函数越平,梯度越缩水,深层网络就越容易学到一半哑火。
沿途站点
2.1 没有非线性的网络只是一张白纸
从多层线性为何等于单层线性讲起,说明激活函数是打破叠层的唯一钥匙。
2.2 从 Sigmoid 到 Swish:常见激活函数全景
逐个审视 Sigmoid、Tanh、ReLU 与它的变形,把每个函数的曲线、梯度、代价摆在对比表上。
2.3 项目里怎么挑激活函数
把知识落到选型决策:隐藏层默认什么、输出层按任务怎么选、什么情况换用哪个。
2.4 梯度消失爆炸与死亡 ReLU
三个最常把训练拖垮的顽疾,各自的成因、排查信号与对策。
拐点与结论
这一章的认知拐点在于:激活函数的质量,一半看它能不能提供非线性,另一半看它给梯度"供血"是否稳定。 ReLU 之所以成为默认项,正是因为它同时赢在这两点上——计算便宜,正区间梯度恒为 1,不给梯度消失添乱;代价则是负区间可能"清零",引出死亡 ReLU。
读完你应该
- 证明"多层线性函数叠加仍然是线性函数",并说清非线性为什么必要
- 画出 Sigmoid、Tanh、ReLU、Leaky/ELU/Swish 的曲线并指出各自的梯度行为
- 按隐藏层、输出层二分,为具体任务推算出合理的激活函数选型
- 识别梯度消失、梯度爆炸、死亡 ReLU 的训练日志特征,并给出对应解法
下一章的接力
第 2 章解决了"网络能表达什么",下一章换到天平的刻度端——损失函数如何给每一步的偏航打分,而那把刻度尺本身又该怎么挑。
下面这张 SVG 把常见激活函数的谱系摆成一棵树,方便定位它们之间的派生关系。
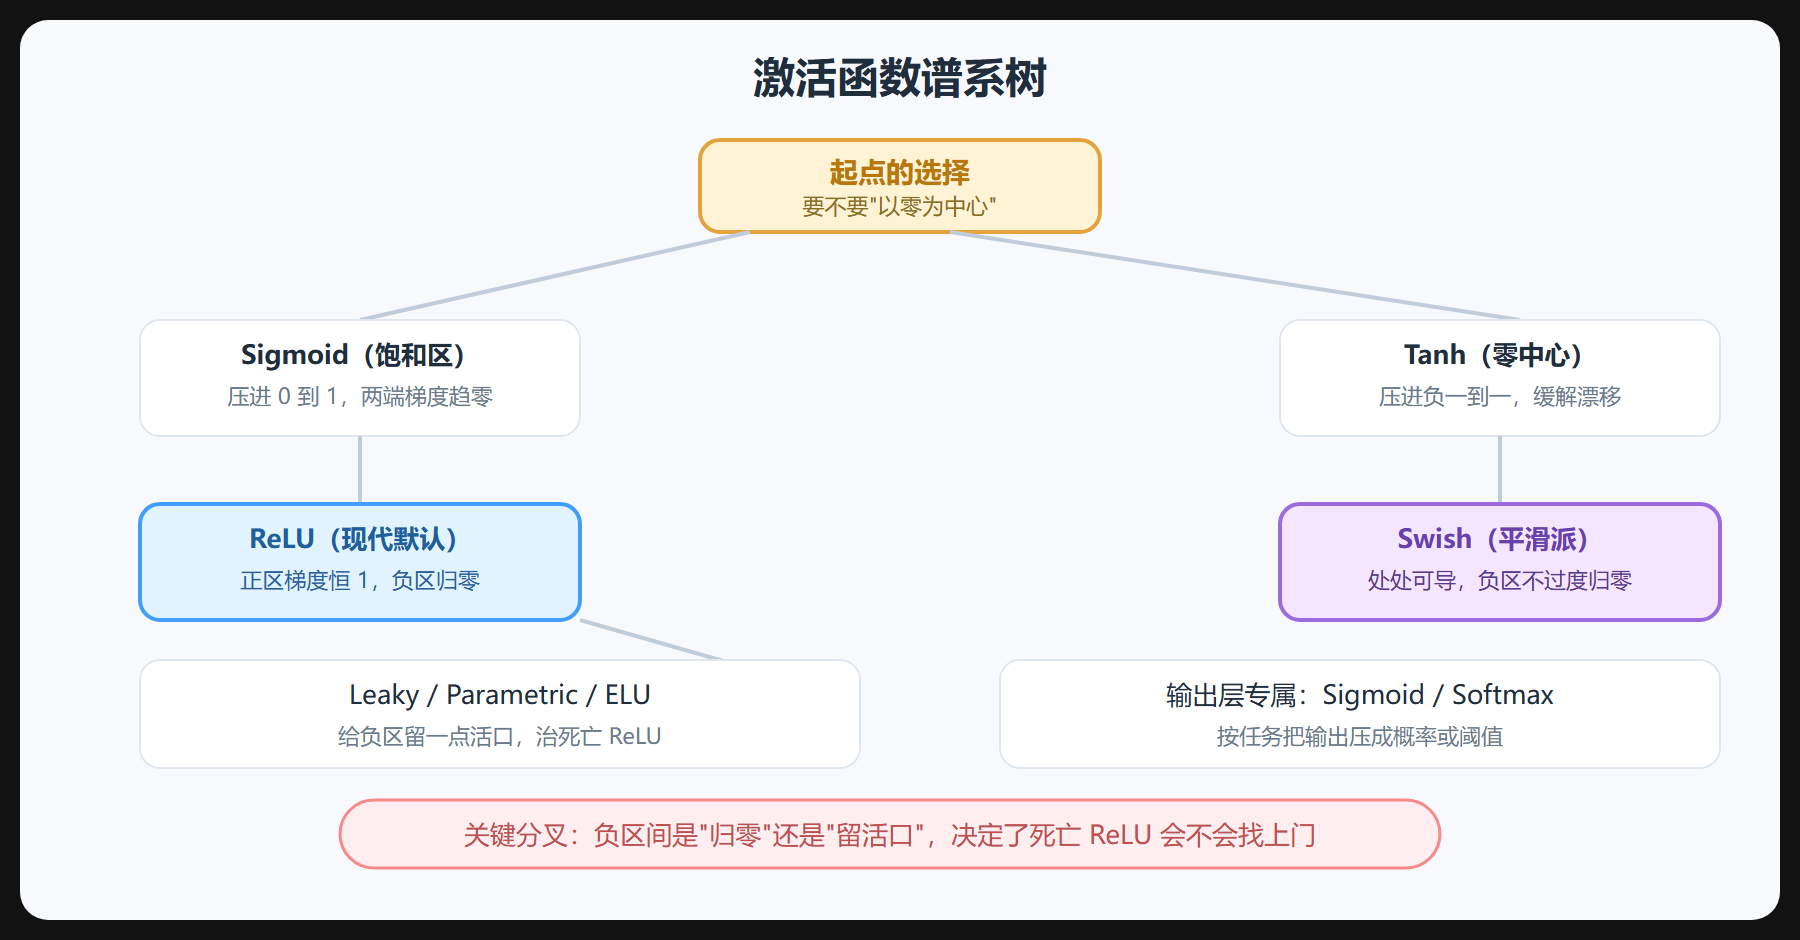
先给出本章的 mermaid 全景图,下面的小节会逐个拆解。
沿途主线:2.1 为什么要非线性(没有它就不会有这一整章)→ 2.2 有哪些候选(素材库)→ 2.3 怎么挑(落地原则)→ 2.4 会踩哪些雷(排障)。
本章的知识点清单
读完本章,请对照确认你能逐条做到:
- 用一句数学证明说出"多层线性仍等于单层线性",并用它解释为什么非线性不可缺(2.1)。
- 画(或口头描述)出 Sigmoid、Tanh、ReLU、Leaky/ELU/Swish 的曲线形状与各自梯度行为(2.2)。
- 面向具体任务,按"输出层查表 + 隐藏层 ReLU 起步"给出合理的激活选型(2.3)。
- 说出梯度消失、梯度爆炸、死亡 ReLU 各自的前端表现与对策方向(2.4)。
- 理解"表达力"与"梯度供给"是衡量激活的两把独立尺子(2.1、2.4)。
如果逐条确认下来有卡壳,优先回读对应的那一节再去第 3 章。
章内小结
激活函数是给天平加"表达力"砝码的那只手,却同时握着"梯度供给"的另一端。读懂它的曲直与饱和,你就明白了为什么 ReLU 成为默认、为什么负区间那么要命。带着这份理解,下一章转向天平的刻度端——损失函数。