2.4 梯度消失、梯度爆炸与死亡 ReLU
2.4 梯度消失、梯度爆炸与死亡 ReLU
本节摘要:三个把训练拖垮的顽疾:梯度消失、梯度爆炸、死亡 ReLU。本节从链式法则讲清它们各自的成因,用信号衰减示意看清"深层为何哑火",再给出日志层面的识别信号与可用对策,收在如何从激活函数这一端防患于未然。
上一节说隐藏层"动不动就死一批",这里就来给三种顽疾上病历。它们都发生在反向传播把梯度从输出一路传回输入的过程中,只是"病情"不同:一个是梯度被越乘越小、一个是越乘越大、一个是干脆被某一个神经元清零。搞清它们,你才理解为什么激活函数的形状值得如此较真。
一、反向传播就是一连串相乘
在反向传播里,某一层的梯度要从输出端一路"乘回去"才能到达。写成这句话:深层某一参数的梯度,约等于从它到输出之间沿途各层导数(含激活函数导数)的连乘积。这一句话就埋下了全部灾难。
连乘积这件事意味着,梯度对"中间任何一环的小数"都极其敏感。
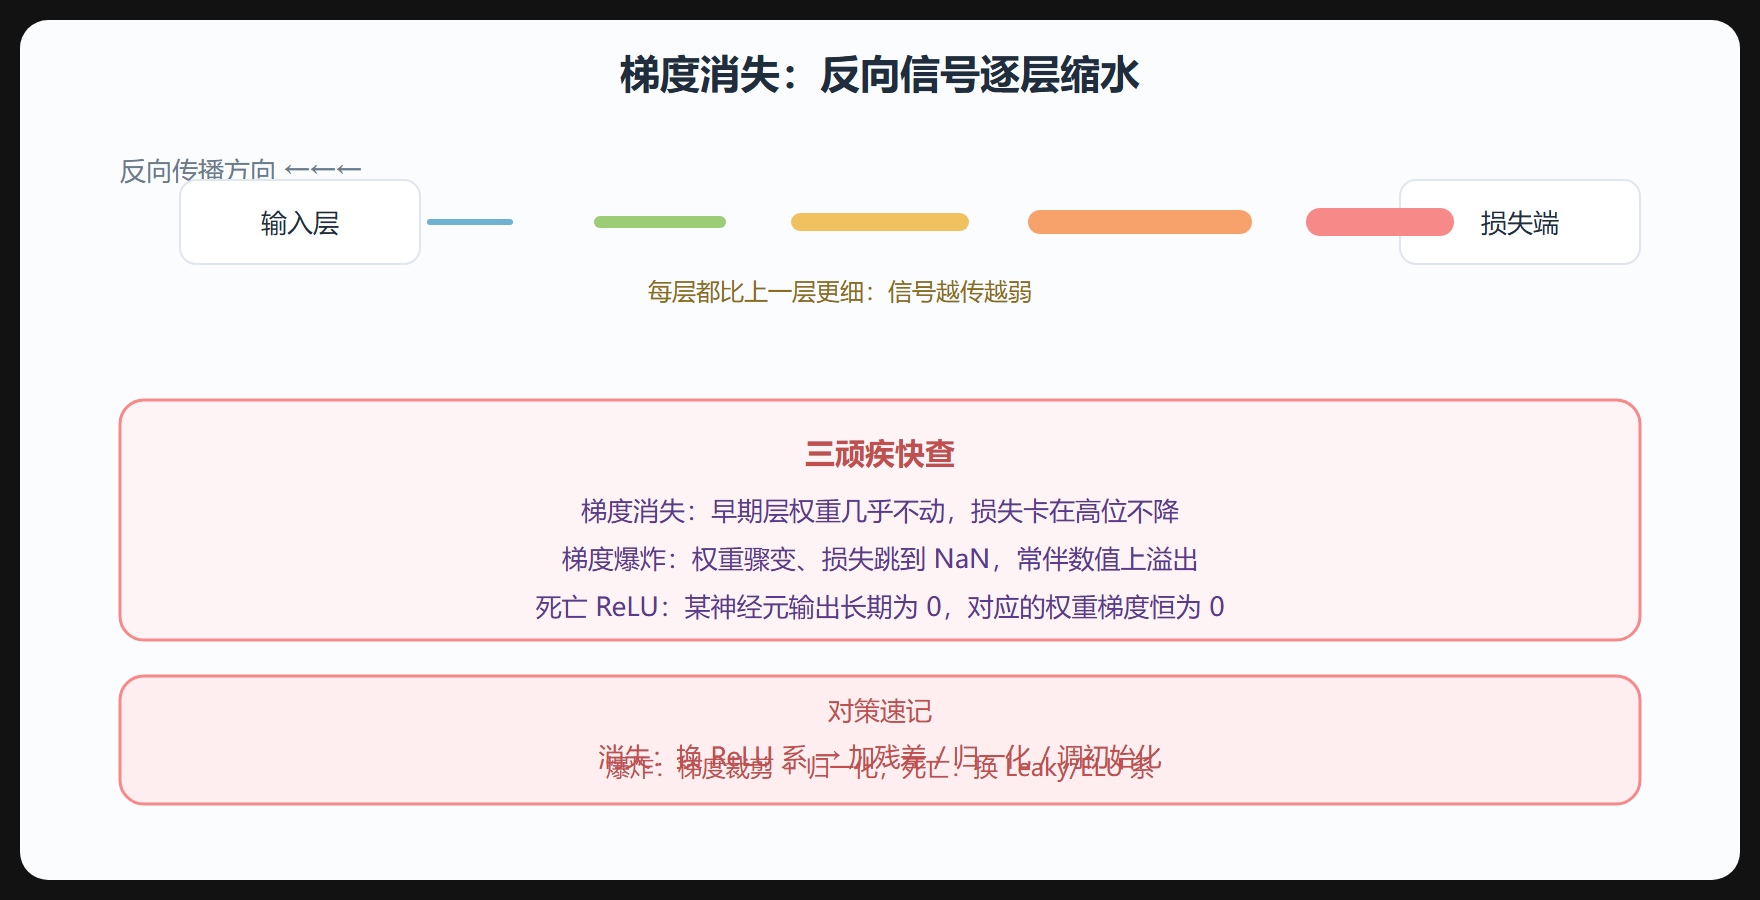
- 若沿途每层的导数多半小于 1(比如 Sigmoid、Tanh 在饱和区的导数趋近 0),连乘下来数值指数级坍缩成接近 0——梯度消失。
- 若沿途导数多半大于 1,连乘指数量级膨胀,参数一下被顶飞——梯度爆炸。
- ReLU 的导数非 0 即 1,看起来干净,但负区那一个"1"变成"0"的节点,能把整条路径的梯度掐死——死亡 ReLU。
二、一张信号衰减示意图
下面这张图把"梯度消失"画成信号从右往左逐层缩水的样子。注意每一层的信号高度在指数式下降,到前几层时已经细到测不出来,参数也无从更新。
三、各自的识别信号与对策
| 顽疾 | 训练日志长什么样 | 主力对策 |
|---|---|---|
| 梯度消失 | 前期层权重几乎不更新,损失降不下去 | 换 ReLU 系激活、加残差连接、调初始化、用归一化 |
| 梯度爆炸 | 损失骤变或直接 NaN,常伴随数值上溢 | 梯度裁剪(5.3)+ 归一化 + 调学习率 |
| 死亡 ReLU | 某些神经元输出恒 0,对应参数梯度恒 0 | 换 Leaky / ELU / Swish(负区留活口) |
四、从源头减少这三兄弟
光会救火不够,我们要的是"少着火"。三个从激活函数这一端就能做的预防:
- 别整层堆饱和函数。深层网络里几乎见不到整层 Sigmoid 的做法,那是把"消失"写进结构里。
- ReLU 系 + 合理的初始化。配合稍好的权重初始化(如让前向/反向的信号方差不扩散),能大幅推迟消失与爆炸。
- 把"死亡"当设计缺陷而非调参运气。看到一片零梯度,不是去狂调学习率,先检查是不是负区间把路堵死了。
⚠️ 常见坑:用"看损失死活不降"笼统归因于"需要更大学习率",结果越调越炸。先分清楚是消失(降不动)还是爆炸(跳到 NaN),两者的对策方向正好相反——一个要"给信号保温",一个要"给梯度踩刹车"。
五、一个能亲手"看见消失"的实验
文字讲过多次梯度消失,可"眼见为实"最有力。我们做一个极简的玩具实验:把几个 Sigmoid 级联,观察信号传到更前面时的变化。
import math def sigmoid(x): return 1.0 / (1.0 + math.exp(-x)) def sigmoid_deriv(x): s = sigmoid(x) return s * (1 - s) # 假设 6 层,输入都是 0,每层初始权重都让预激活值落在 0 附近 deriv = sigmoid_deriv(0.0) # 约 0.25 # 反向从输出一路乘回第 1 层(粗略示意) product = 1.0 for layer in range(6): product *= deriv print(f"传到第 {6 - layer} 层前的连乘 ≈ {product:.6f}")
你会发现每传回一层,连乘就再乘一个 0.25,到第 1 层时已经缩到约 0.000244。这就是"Sigmoid 堆深 → 梯度消失"的直观根源:每层都在给你"打折"。换成 ReLU(正区导数恒 1),连乘里的这一项不会把信号越乘越小——也正是它在深层网络成为默认的原因之一。
六、三个顽疾的易混淆清单
很多人把三者混为一谈,我们给一张"长得最像但性质不同"的对照,帮你牢牢分开:
| 顽疾 | 根源 | 前端表现 | 你要的反方向 |
|---|---|---|---|
| 梯度消失 | 导数连乘 <1 | 浅层学不动、损失降不下 | 换 ReLU 系、加残差、调初始化、上归一化 |
| 梯度爆炸 | 导数连乘 >1 | 权重骤变、损失 NaN | 梯度裁剪 + 归一化 + 降学习率 |
| 死亡 ReLU | 负区导数为 0 掐断 | 某神经元输出恒 0 | 换 Leaky/ELU/Swish |
这张表的"反方向"列,会在第 5 章的梯度裁剪、归一化等装配里再次现身。现在你先记住一件事:三者对策方向两两不同,别用同一招去治三种病。
七、用梯度统计把"三兄弟"分得更细
日志层面把三个顽疾分开之后,还可以再进一步:直接在训练脚本里打印各层梯度的平均绝对值与范数,这是最可靠的"体检单"。
# 概念片段:逐层打印梯度量级的体检单 for name, param in model.named_parameters(): if param.grad is not None: gabs = param.grad.abs().mean().item() print(f"{name:40s} grad|mean={gabs:.2e}")
- 若越靠近输入层的梯度越小、前排 gabs 远小于后排,就是典型的消失,方向指向"换 ReLU 系、加残差、调初始化"。
- 若某一层梯度突然暴涨到邻近层几个数量级之上,就是爆炸前兆,方向指向裁剪与降学习率。
- 若某层梯度几乎恒为 0、而它前后都正常,那多半是这一层内部有某个 ReLU 把门焊死,属于死亡 ReLU 的直接证据。
这里的关键是:别只看损失这一个标量,把梯度摊开看每一层,你就能从"我猜是消失"升级成"确诊是消失"。 这正是第 5 章实战调试要反复用到的习惯——把诊断建立在对中间量的观察上,而不是凭损失一个数拍脑袋。
本节要点回顾
- 根因相同:反向是连乘积,任何一环小数的累计都会放大成失控。
- 消失:沿途导数小于 1 连乘坍缩,早期层学不动。
- 爆炸:沿途导数大于 1 连乘膨胀,参数被顶飞、损失 NaN。
- 死亡 ReLU:负区导数为 0 把某条路掐死,梯度恒 0。
- 识别先分开:消失靠"降不动",爆炸靠"跳 NaN",对策相反。
- 预防为主:少堆饱和函数、ReLU 配好初始化、把死亡当结构缺陷修。
激活函数这一课收在这里。天平的表达力砝码放好了,下一章换关注刻度尺——损失函数怎么把你的错量化,又该如何为任务量体裁衣。