4.2 梯度下降的三种步法
4.2 梯度下降的三种步法
本节摘要:梯度下降(GD)是优化器的母体,它按"一次用多少数据算梯度"分成三兄弟:批量、随机、小批量。本节从"计算梯度要花多少力气"切入,讲三者在速度、稳定性与内存上的取舍,最后得出小批量在现代训练里的绝对主导地位。
上一节讲了优化器的核心命题,现在把目光从"要不要沿梯度走"转向"那句梯度到底怎么算得又快又不失真"。这就要谈到梯度下降的三个变体,它们的分野只有一个字:一次喂多少数据。
一、一个梯度,三种算力
梯度下降每一步都要估计"往哪走最陡"。关键问题是:用多少样本去估算这个方向才算划算?三兄弟由此分开:
- 批量梯度下降(Batch GD):每次用全部数据算梯度。方向最准,可一个 epoch 才动一步,跑到天荒地老,还装不下一丁点显存。
- 随机梯度下降(SGD):每次用单个样本的梯度。方向很粗糙、带噪声,一步一个踉跄,但更新频繁。噪声多时反而能"抖出"局部最低点。
- 小批量梯度下降(Mini-batch):每次用一小批(如 32~256 个样本)。方向比随机稳、比批量便宜,是现代浮力场的默认。
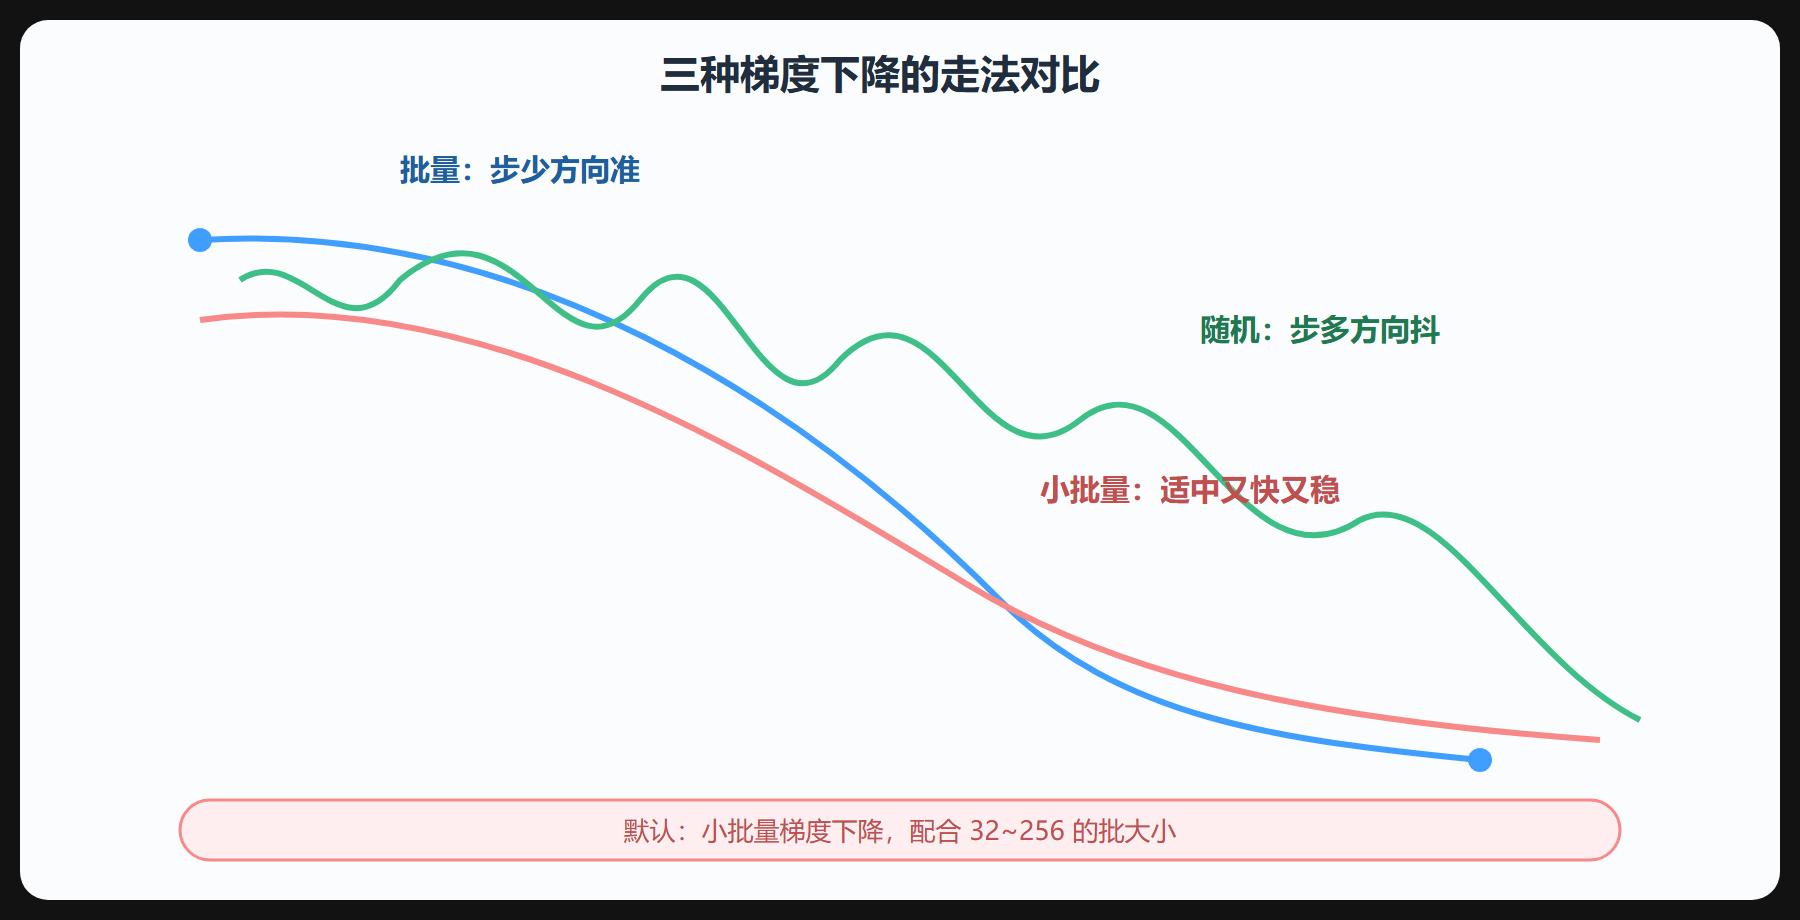
一句话概括:"方向要准但步子可念"用批量;"步数多但方向糙"用随机;"适中地快 + 适中地稳"用一大批。
二、用一个例子感受嗓子粗细
假设你有 12800 个训练样本,每扳一次参数算一次梯度。
n = 12800 # 批量:每一步都看全部样本,只会走很少几步 # 随机:每一步只看 1 个样本,会走很多步但方向抖动 # 小批量:每一步看 128 个样本,步骤和稳定性居中
- 批量:out一是 12800 个样本算一个方向,参数憋着大半天才动一次。
- 随机:out是每 1 个都算,步子秒级更新,但单个样本的梯度带噪声——你没法保证每步都朝"整体更优"。
- 小批量:每次一批去掉噪声、又不至于喂太久,一步一个相对干净的梯度。
这个例子想提醒你:同样叫"梯度下降",三者的计算频率根本不在一个量级,别用同一套学习率去套它们。
三、一张图看懂三种走法的性格
下面这张 SVG 用"从起点走向谷底"的轨迹,把三种步法的差别一次性画清:批量走得少而直、随机走得多而抖、小批量在两者之间。
四、为什么小批量笑到最后
现实中几乎没人再跑批量或单体随机做完整训练,原因:
- 批量 GD 每一步都要看全部数据,计算量爆炸、内存也扛不住,分量占位。
- 纯 SGD 噪声过大,收敛慢,且沿训练迭代常震荡得难看。
- 大部分学术与实践的"梯度下降"默认就是指小批量,框架里你随手设的 batch_size 就是它。
小批量还有隐藏红利:一批样本的梯度显然比单样本更接近整体方向,配合中等批大小,既能上 GPU 并行批量算,又不会太粗,是工程里最舒服的一段。
五、批大小怎么选
批大小是个既影响效率又影响质量的旋钮:
- 太小(如 1~8):噪声大、GPU 利用率低、收敛不稳。
- 太大(如上千):梯度更"准"但更新更少,容易收敛到泛化略差的谷,且超出显存。
- 常规起点:32、64、128;显存与步数之间你用 2 的幂方便对齐内部算子。
⚠️ 常见坑:把"要用大批次还是小批量"当纯性能选择题。其实批大小还微妙地影响泛化——研究里常见"小一点批、加一点正则"的组合比一味追求大批效果更好。改批变了号,也最好同步复查学习率。
六、一个"算力 vs 方向"的心算练习
为了把"一次用多少样本"这个变量果然具象化,我们做个心算:你有 8192 个样本,跑一个 epoch(即把全部样本用一个来回)。
- 若批大小为 8192(整批),这一个 epoch 只更新 1 次参数。
- 若批大小为 64,这一个 epoch 更新 128 次参数。
- 若批大小为 1(随机),这一个 epoch 更新 8192 次参数。
同样一个"看一遍数据",参数更新的次数差了三个量级。这就是为什么纯随机会"噪声满天飞",而大批次"半天不动一下"。小批量正是想在这两个极端之间,找一个"够多步数又不至于太噪"的舒适点。
七、常见的问题:那到底一次喂多少合适
实践里不存在"唯一正确批大小",但有一串稳妥的起点和它会带来的连锁:
- 从 32、64、128 起步,用 2 的幂(对齐内部算子)。
- 观察梯度稳定性:若损失震荡剧烈,考虑把批调大一点点;若慢得发急,可调小。
- 批大小变,学习率常要跟着变:大批次往往配稍大学习率,否则"步伐次数变少、没走够量"。
- 大批次有时泛化略差:部分实验里小一点批 + 强一点正则,反而有更好的测试表现。
记住"改一个旋钮看两条曲线"的纪律(呼应第 5 章调试),搜批大小才不会变成碰运气。
八、批大小和显存、以及落到 GPU 上的手感
除了"方向稳不稳",批大小还直接决定一次能装进多少数据去并行。极小批(比如 1 或 4)经常让 GPU 的算力睡大觉——硬件一卡一次只想算一两个样本,吞吐量上不去,epoch 数虽多但整体反而慢。所以工程里流行"批大小对齐显存":把批调到能尽量占满显存又不溢出,往往能白赚好几倍的每 epoch 吞吐。
这也是为什么"2 的幂"常被推荐的第二个原因——不只是算子对齐,而是 32/64/128 这类值在大多数批次矩阵乘法里天然高效。你可以在一个显存足够的卡上,把批从 32 一路试着加到 256,记录每 epoch 的耗时曲线——通常中段有个"性价比最高"的甜点,放得太大既不划算、泛化还容易变差。这条"吞吐 × 泛化"的双目标,正是你在选批大小时真正在权衡的东西。
九、把三种步法放进"算力预算"里一起想
现实里你很少在"纯随机"和"纯批量"之间二选一,而是在给定的一份硬件预算里选一个让吞吐与质量都过得去的小批大小。真正的思考顺序是:先对着自己的硬件预算,想清楚一次能吞多少、对带宽多敏感,再站在"我一次能吃多少"和"我一步要稳到什么程度"的交点上取值。如果一次训练就几小时,批大小选得不合适,代价是被浪费的每一轮 epoch。
所以别只把三种步法当"概念名词",它们其实是你在设计整个训练管线时的一把尺子——同一批数据,选不同批大小,更新次数、噪声、并行利用率和泛化都会变。想清楚"我到底要的是步数多还是方向稳",你就知道该往 32 还是 128 偏了。
本节要点回顾
- 一个梯度三步法:批量(全量,方向准步少)、随机(单体,方向抖步多)、小批量(一批,又稳又快)。
- 默认小批量:现代训练框架里的批量 GD 就是这一种,配 32~256。
- 噪声的双刃:单体噪声大到可以替你"抖出"局部低点,也可能让你收敛飘。
- 批大小影响泛化:别只当性能旋钮,它跟学习率、正则都有联动。
- 算力与质量的平衡:GPU 并行、显存预算、更新频率要一起权衡。
三兄弟都认识了,可它们还有个共性毛病——震荡、陷入峡谷。下一节请出动量,给这批步法加一点"惯性"和冲劲。