4.3 动量:给下山加一点惯性
4.3 动量:给下山加一点惯性
本节摘要:动量(Momentum)通过积累历史梯度的方向,给参数更新加"惯性",从而抹平震荡、加速穿过峡谷。本节用一个滚动球的直觉讲清更新公式的来龙去脉,配合轨迹对比图,讲清它修了 4.2 里哪个坑、以及动量系数该取多少。
上一节的小批量梯度下降还有个没解决的个性:在窄峡谷地形里会左右来回震荡,一步快一步慢、甚至zig-zag。这一节就亮出标配的补丁——动量,给这一步加法送一股"惯性"。
一、加惯性是怎么抹掉锯齿的
想想你把一个铁球从山顶推下:它会沿坡滚,且不会因为路边遇到一个小凸起就立刻转向,因为它的速度已经把它带起来了。动量就是干这件事——它不让参数像被冻住的蚂蚁那样每步都只看眼前的梯度,而是把"历史上的前进方向"累加进下一步。
于是更新不再是:参数 = 参数 − 学习率 × 当前梯度
而是先维护一个速度项 v:v = β·v + 学习率 × 梯度,再用 v 去更新参数。
前后两个式子差在哪里:
- 纯梯度下降每一步忘掉上一次,只见当前梯度,陡路疾走、平路磨蹭、峡谷震荡。
- 动量把方向做了"低通滤波",梯度过大的方向在惯性里被摊出去,峡谷两壁的来回震荡会互相抵消,沿谷底一路滑下去。
结果就是:震荡变小、穿过平坦谷底更快、还可能顺势翻过局部小坑奔向更优谷。
二、滚动球 vs 冻蚂蚁
盗用一个经典直觉:
- 普通的梯度下降,参数像只每一步都搬到当前最陡方向的蚂蚁,僵直、容易被地形带得团团转。
- 有动量的梯度下降,参数像往坡下滚的球,带着速度走,少被局部环境左右,径直奔向谷底。
这个直觉很有用,但也别太较真——真正的动量用的是历史梯度的"指数加权平均",不是纯力学。你记住"惯性 + 抵消震荡"就够用,不必背公式的物理意义。
三、动量帮上那张对比图
把没动量和有动量放到同一张地形,差异一眼可见。
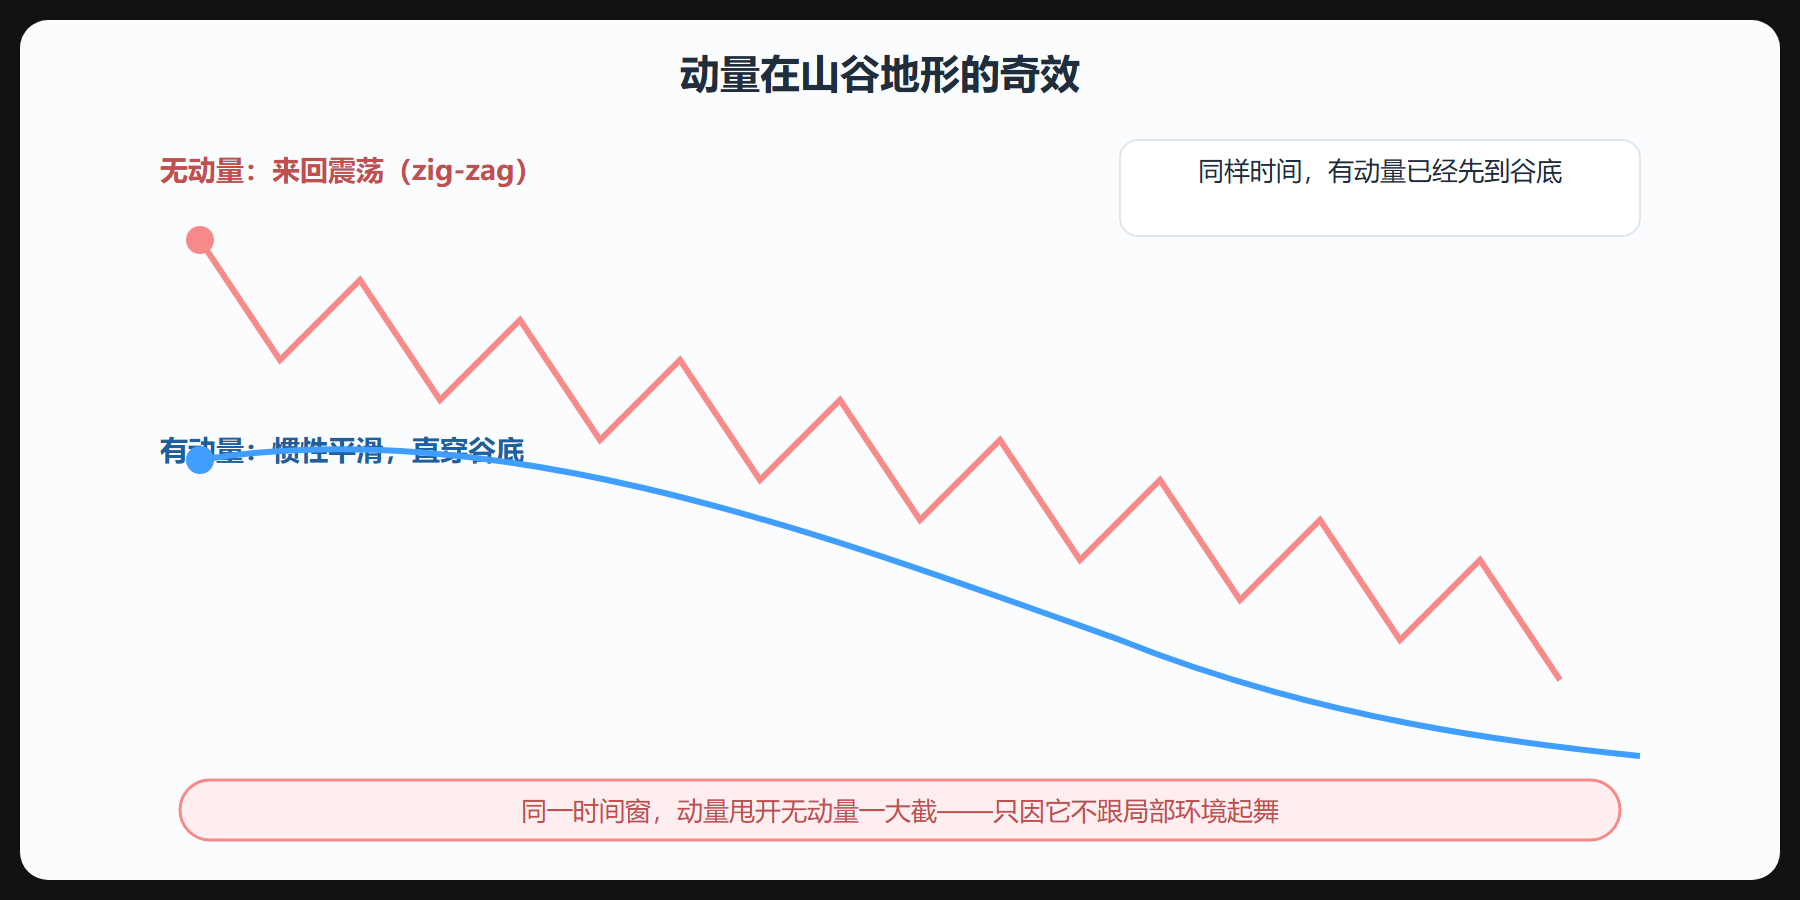
左边那条剧烈震荡的灰线,就是你在日志里常见的"损失锯齿";右边那条光滑下行的蓝线,就是动量做完该有的样子。这不是玄学,是它把峡谷两壁的来回趋势在速度项里抵消了。
四、动量系数和它的小弟弟
动量有一个系数 β,决定历史方向占多大分量:
- β 靠近 0:动量很弱,回到接近纯梯度下降。
- 常见取值:0.9 附近,是绝大数框架的默认,兼顾惯性又不至于冲过头。
- β 过大(接近 1):惯性过大,可能刹不住车,越过谷底在别处绕圈。
它还有一个"弟弟"叫 Nesterov 动量:先按当前速度估算一步再算梯度,等于"往未来探一下再落脚"。它的收敛曲线常比标准动量更快更稳,很多框架把它作为可选参数。想深入时知道有这么个表亲即可。
五、什么时候该用动量
动量不是替代品而是增强件:你通常"使用 SGD 的同时给它加动量",而不是二选一。判断信号也很直接:
- 日志里损失呈锯齿状、忽上忽下 → 加动量,通常立刻收敛。
- 损失在平坦区磨蹭不动 → 动量帮你借惯性溜过去。
- 反而在追求"极稳""可控解释"的极简任务里,你才可能刻意不开动量。
配动量时,学习率也可以相应调大一点,因为它帮你抹掉了一部分由震荡引起的过冲。
⚠️ 常见坑:把动量当成"能救一切的神药",一不收敛就调大 β。β 太大会刹车失灵。它是"平滑补丁",不是"万能发动机",真正的爬坡还是靠学习率与地形。
六、一次动手看动量怎么"抹平"锯齿
光说"惯性抵消震荡"还是抽象,我们用两条并行路径对照一下:设地形是一个朝右下倾斜、两侧陡的窄谷,用纯 SGD 走会在谷壁之间来回横移、前进缓慢;而有动量的 SGD 会因为这股"前向惯性"把横移摊薄、沿谷底滑下去。
# 概念片段:示意动量对"来回横移"的缓冲 v = 0.0 beta = 0.9 for step in range(10): grad = 1.0 if step % 2 == 0 else -1.0 # 模拟谷壁左右互推 v = beta * v + grad print(f"step {step}: 当前梯度={grad:+.1f} 速度v={v:+.2f}")
纯交替 ±1 的梯度,在 β=0.9 下速度项 v 会被来回抵消到接近小值——而如果你只盯着当前梯度,每步都在大幅横跳。这就是"方向被滤波、震荡被收敛"的直观来源。亲手复述一遍这个数,比你背"动量让更新更平滑"十个结论都管用。
七、动量不是越强越好,也别和"加大学习率"混为一谈
动量主管"继续沿历史方向冲",学习率主管"每一步实际踩多大"。同样的 β,配上不同的 lr,走出的曲线完全不同——β 大 + lr 太大,会把"冲过头"也放大;β 小 + lr 大,则像没带惯性地大步乱跳。所以两个旋钮要一起想:想让网络更有闯劲,可以适度加动量,但通常要顺手把学习率也跟着微调,否则容易刹不住。
另一个常见误区是把动量和"梯度裁剪"搞混:动量是软性惯性,裁剪是硬性上限(见 5.3 节);一个是"让你更顺",一个是"防止你失控"。需要同时用时两者作用在更新链路的不同环节,别以为加了动量就不用裁剪、或剪了就不用动量——它们根本不回答同一个问题。
八、一个容易被忽略的观察:动量对"噪声型障碍"的暧昧
如果地形里不时出现小的、方向随机的小凸起(类似噪声),动量反而可能"被惯性带偏"——在平滑的路上碰到一个小干扰时,它会凭惯性无视它往前走,这通常是好事;但若你希望模型对微小的地形变化更敏感(比如密集调优阶段),动量又会抹掉这些细节。所以"要不要开动量",本质上也在回答你"我希不希望这一步太容易被局部细节带偏"。对不同阶段可以有不同的偏好:前期希望它冲得远、别被小坑绊住,后期精修时也许更希望它对微地形敏感。
本节要点回顾
- 加惯性:动量在速度项里积累历史方向,让参数带惯性地走。
- 抵消震荡:峡谷两壁的来回梯度在惯性中被互相抵消,出锯齿。
- 滚动球直觉:别再像被地形磨得团团转的蚂蚁,而像带速度下坡的球。
- β≈0.9:常见默认,兼顾惯性不过冲;Nesterov 是它的进阶表亲。
- 是增强件:SGD + 动量用,不是二选一;调它顺便可以微调学习率。
动量把方向理顺了,可还有一个硬骨头:不同维度"陡峭程度"差太多。下一节交给自适应学习率,让每根参数各走各的步伐。