4.4 自适应学习率:让每根参数各走各的
4.4 自适应学习率:让每根参数各走各的
本节摘要:不同维度的参数坡度差别巨大,单一学习率无法两边讨好。本节从 AdaGrad 的单调收缩讲到 RMSProp 的指数衰减,再到 Adam 把动量与自适应合流,讲清每个方法的"补丁"版本,并点出各自踩过的坑,为 4.5 的选型做铺垫。
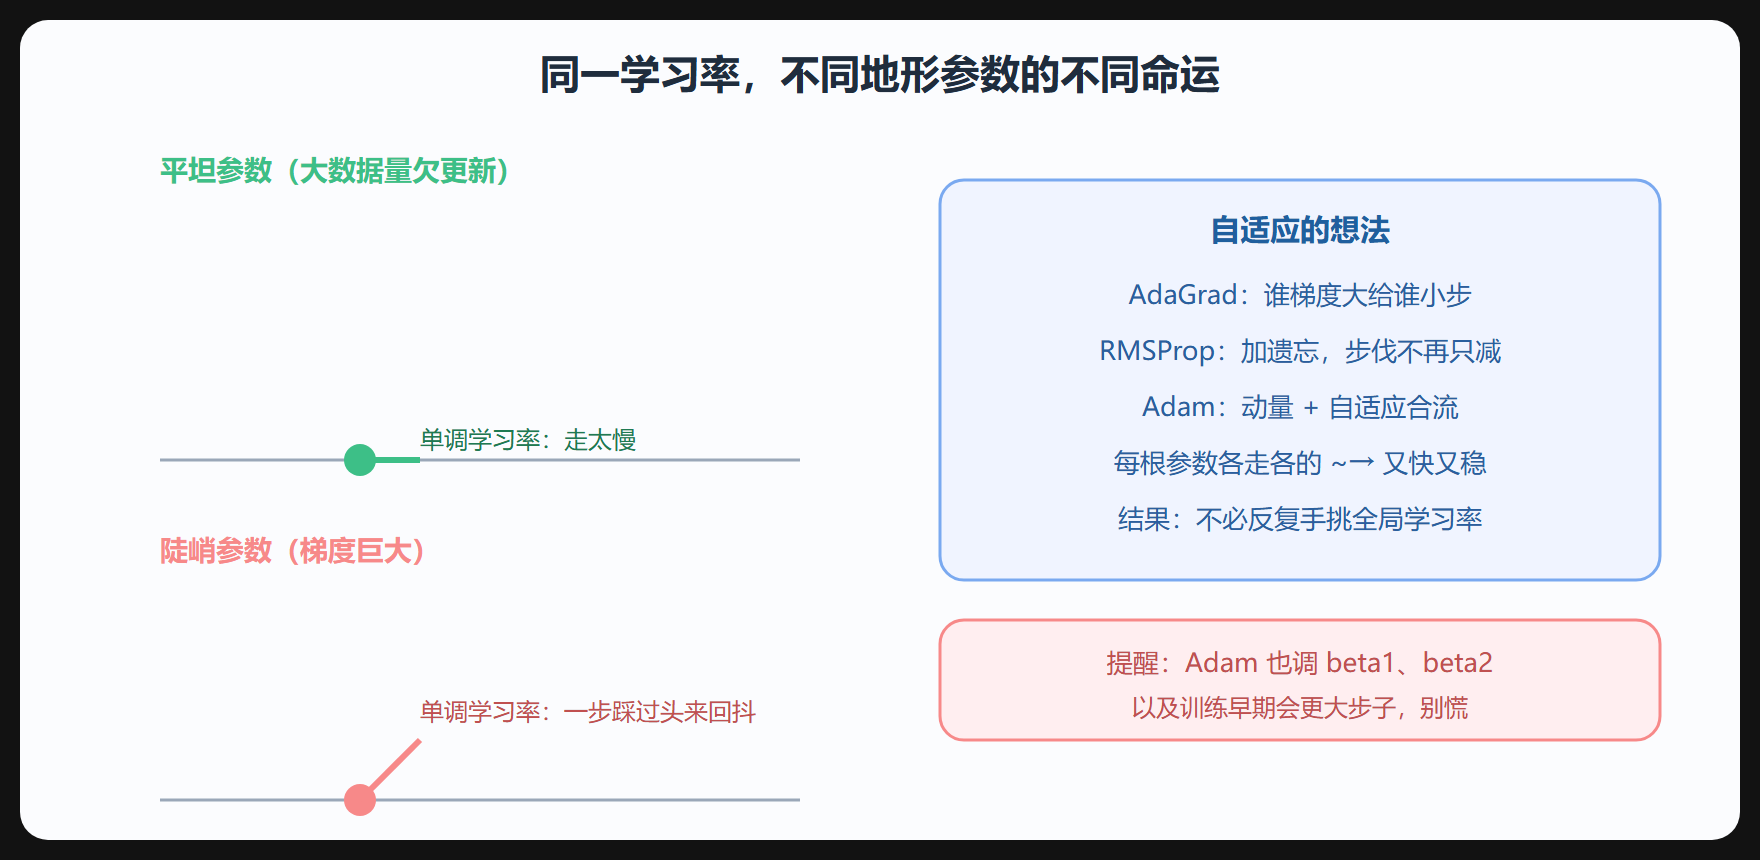
动量让方向顺畅了,可它忘了一件事:不同参数的"地形坡度"可能差上百倍。 有的参数梯度巨大、陡峭;有的参数几乎不产生梯度、平坦。给它们喂同一个学习率,陡的会抖、平的会磨。这一节的解法是"因材施教"——让每根参数按自己的历史梯度调整步伐。
一、AdaGrad:先迈出自适应第一步
最朴素的做法是:谁的历史梯度越大,就越该给谁更小的步伐。AdaGrad 就这么干——它给每个参数累计一个历史梯度的平方和 s,然后用"学习率 / 根号下 s"去缩放每个参数的更新。
- 好处:稀疏参数(数据里很少出现的特征)会得到较大步伐,这对文本、稀疏特征特别友好。
- 致命伤:s 只增不减,步伐永远单调缩小。训练久了所有参数都挪不动,这就是著名的"学习率提前归零"问题。
二、RMSProp:给累计加上遗忘
RMSProp 修 AdaGrad 那个"只增不减"的毛病:它不再让 s 一路累加,而是用一个衰减因子 β 做指数加权平均——新的 s 只保留一部分旧 s,再掺入当前梯度平方。这样:
- 近期的梯度影响更大,远期的旧记忆逐渐淡出。
- 步伐不会一路缩到底,长跑下来仍有一口养分。
于是同一根参数能随着梯度"大时降步伐、小时回步伐",比 AdaGrad 健康得多。RMSProp 由此成了很多 RNN 类任务的常见选择。
三、Adam:把两股补丁缝在一起
Adam(Adaptive Moment Estimation)做的事,就是把 4.3 的动量、4.4 的 RMSProp 自适应一起缝进一个框架:
- 一路维护"一阶矩"(差不多就是动量/历史方向),管方向。
- 另一路维护"二阶矩"(差不多就是 RMSProp 的方差估计),管各向异性的步幅。
- 再各做一个"偏差校正",让训练早期估计不至于被刚起步的零历史带偏。
整体出来的更新更顺、更快,也基本免去你反复手挑学习率的痛苦——Adam 在大多数任务里"开箱即用"就是这么来的。
下面这张 SVG 用"两根参数地貌"示意:同一学习率下,平坦参数的走量与陡峭参数完全不同。
四、Adam 的常用参数与顺带的权益
Adam 默认参数几乎能打天下:学习率 0.001,β1=0.9、β2=0.999,ε 做数值稳定地板。你通常不用动 β,最多把学习率在 1e-3 到 1e-4 之间试。
它顺带缓解了"误差梯度在早期被校偏""稀疏特征时机不均"一堆旧问题,因此在新模型验证阶段,Adam 几乎总是第一选择。代价是它的二、三阶矩各占内存,参数极多时内存开销比 SGD 大。
五、一个致命取舍:泛化
几乎每本讲优化的书都提醒一件事:Adam 收敛快,但最终泛化(在测试集上的表现)有时未必比调好的 SGD + 动量更好。 一些研究观测到 Adam 会把模型带到更"尖锐"的解,测试误差略高。所以实践里出现了"先用 Adam 快速探路、再用调好的 SGD 精修"的常见战术——这也是 4.5 选型里最实用的思路。
⚠️ 常见坑:把 Adam 当"永远不会错"的万能解,上来就默认并一路到底。它好在省心、坏在可能泛化略逊。正确做法是跑基线看曲线,不理想再切换策略。
六、一个数实验:看 AdaGrad 的"步子收缩"长什么样
口说无凭,我们把 AdaGrad 的核心动作算一遍:维护累计平方和 s,每一步更新都是 s += g²,并用 lr / sqrt(s) 缩放。
# 概念片段:AdaGrad 的累积平方让步伐单调收窄 s = 0.0 lr = 0.1 for g in [1.0, 1.0, 1.0, 1.0]: # 恒定梯度 s += g * g step = lr / (s ** 0.5) print(f"s={s:4.1f} step={step:.3f}") # 每一步的步长都在变小
梯度恒定时,前面几步步长还像样,越往后 s 越大、步长越小——这就是"学习率提前归零"的数字影子。RMSProp 加了衰减因子 β 后,s 不再无限累加,步长能在波动中回血,这正是两者命运的分水岭。
七、Adam 的"偏差校正"到底在保护什么
Adam 区别于朴素 RMSProp 的要点之一是偏差校正。原因在于训练开头那几步,一阶矩 m 和二阶矩 v 从零起步,除以"还没有累积多少样本"的系数会让估计严重偏小(早期更像"只见一两个历史")。偏差校正就是把这个"常数偏小"掰回来,让前几步的估计不至于被起点拖偏。
很多人只在文档里见过 bias correction 这个词,却说不清它是干嘛的。可以这样记:它是在给"刚开张的统计学家"发一套校准系数,让他前几步就敢信自己的平均值。 少了它,Adam 前几个迭代的步长会偏大、轨迹更抖,收敛稳定感差不少。
八、自适应体感的另一面:你少调学习率,不等于它不重要
Adam 帮你免去大量手挑学习率的痛苦,这是真福利,但别把"省心"误读成"学习率不重要"。极端的学习率(比如 1e1 或 1e-6)对任何优化器都是灾难;Adam 只是把"合理区间"变得更宽、更宽容了,并没有把学习率变成无效。实际里你仍会用第 5 章的调度去做后期精修——自适应管"各向异性",调度管"整体随时间的收放",两者职责并不重复。把这块分清楚,你就不会在"都自适应了怎么还要调度"上绕圈了。
九、把自适应与动量比作"两个互相打架又互相成就的旋钮"
很多人把 Adam 当成一个"黑盒按钮",其实它内部是动量与自适应在互相成就:动量在"高频、振动"的方向上做低通滤波,自适应在"陡峭/平坦"的方向上做增益补偿。两者都想让网络更稳更快,但不是完全独立的——动量大、自适应的步子也会被透传得更猛。所以在 Adam 上,你真正常动的不是 β,而是看它"收敛得太飘"(调学习率或动量)还是"在某个轴一直磨"(大概率是自适应权重与激活饱和的问题)。
理解到这层,你就不再需要背 Adam 的参数列表,而是知道"这个量在管天平哪一端"。正是这份"找到旋钮在管哪端"的能力,让你在遇到不熟悉的优化器时也能顺着主线条分缕析,而不是只会在 Adam 和 SGD 之间来回二选一。
本节要点回顾
- 因坡度而异:地形参数坡度差上百倍,单一学习率两边不讨好。
- AdaGrad:谁梯度大给谁小步,但步伐单调收缩、早停。
- RMSProp:加指数遗忘,步伐能回血,RNN 常用。
- Adam 主流:动量 + 自适应 + 偏差校正缝成一体,开箱即用。
- 泛化代价:Adam 收敛快但可能停在尖锐解,精修时给人 SGD 留位置。
四个主流优化器都登场了,下一节真的把它们放到一个项目里去拍板——到底该用 SGD 还是 Adam,怎么进退。