4.1 卷积神经网络 (CNNs) 及其变体
4.1 卷积神经网络 (CNNs) 及其变体
本节摘要:CNN 是自动驾驶感知的基石。本节讲 CNN 及其在自动驾驶的变体——骨干网络、检测分割的根基。
读前必看(上)
阅读完本节,你应当能够:
- 理解 CNN 在自动驾驶的作用
- 知道常用骨干网络
- 了解 CNN 变体
概念脉络
CNN 在自动驾驶的作用
CNN 是自动驾驶感知的基石:检测、分割、车道线、标志识别都基于 CNN。CNN 提取图像特征,是感知模型的"发动机"。
常用骨干网络
| 骨干 | 特点 | 自动驾驶用 |
|---|---|---|
| ResNet | 残差,深,精度高 | 高精度感知 |
| MobileNet | 轻量,移动端 | 边缘部署 |
| EfficientNet | 复合缩放 | 高精度 |
| CSPDarknet | 跨阶段,省算力 | YOLOv4 |
| HRNet | 高分辨率 | 分割、姿态 |
CNN 变体
图 4-1 CNN 在自动驾驶的应用
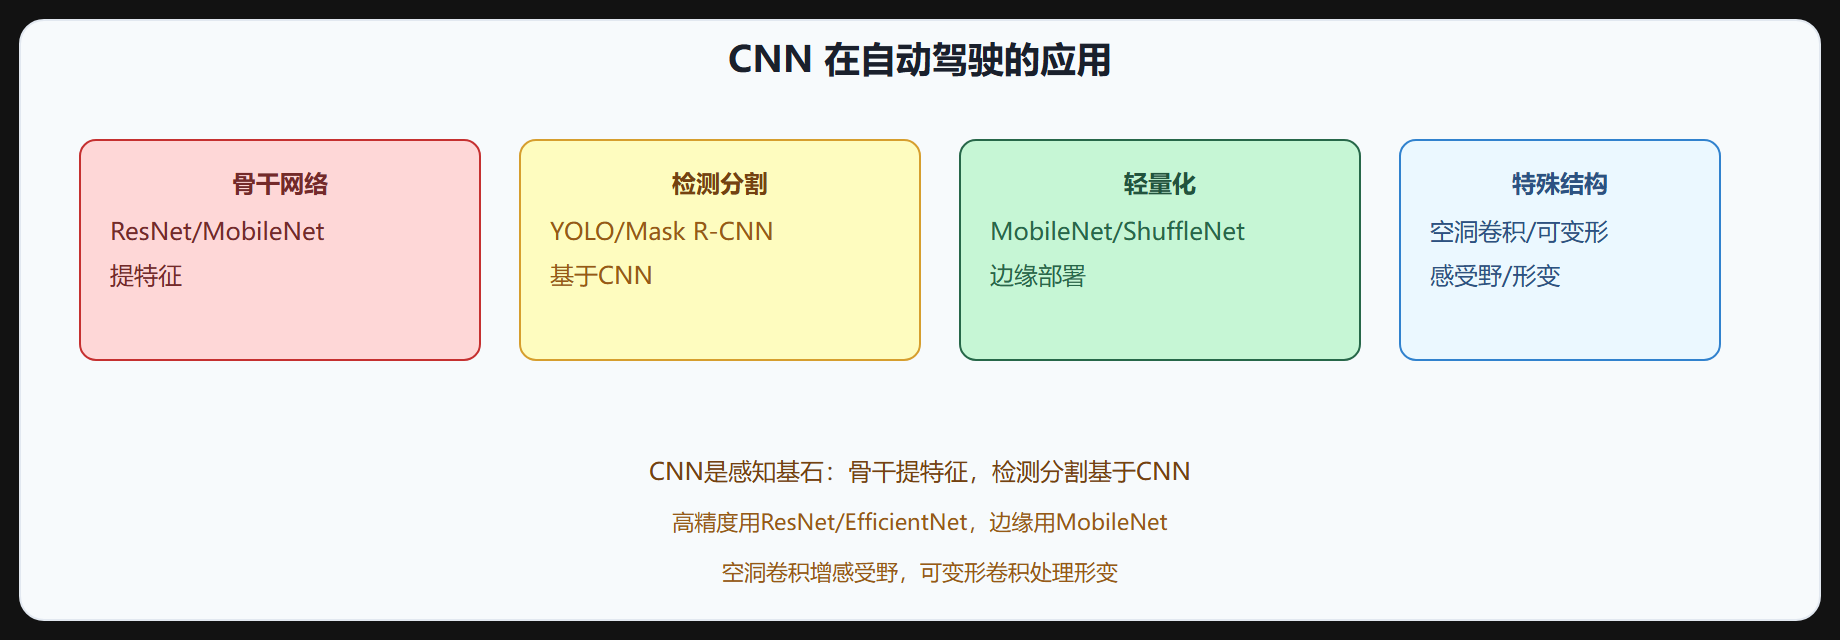
- ResNet:残差连接,深网络,高精度感知骨干
- MobileNet:深度可分离卷积,轻量,边缘部署
- EfficientNet:复合缩放,精度效率最优
- HRNet:保持高分辨率,分割和姿态
CNN 特殊结构
- 空洞卷积(Dilated):不增加参数增感受野,DeepLab 分割用
- 可变形卷积(Deformable):卷积核自适应形变,处理目标形变
- 分组卷积:ResNeXt,省算力
- 深度可分离:MobileNet,轻量
CNN 在自动驾驶的应用
- 检测:YOLO(CSPDarknet)、Faster R-CNN(ResNet)
- 分割:DeepLab(空洞卷积)、U-Net
- 车道线:CNN 端到端
- 标志识别:ResNet 分类
- 3D 检测:CNN 提特征 + 3D 预测
CNN 的局限
- 全局建模弱:卷积局部,长距离依赖弱(Transformer 补)
- 计算量大:高分辨率重
- 时序弱:单帧,时序需 RNN/Transformer
这些局限催生 Transformer 在感知的应用(4.2 节)。
选型建议
| 需求 | 骨干 |
|---|---|
| 高精度 | ResNet-101、EfficientNet |
| 实时/边缘 | MobileNetV3、ShuffleNet |
| 分割 | HRNet、DeepLab |
| 平衡 | ResNet-50 |
⚠️ CNN 局限:CNN 局部建模,长距离依赖弱,时序弱。这些催生 Transformer 在感知的应用(BEVFormer 等)。
💡 关键直觉:CNN 是感知基石,骨干(ResNet/MobileNet)提特征,检测分割基于 CNN。高精度用 ResNet/EfficientNet,边缘用 MobileNet。空洞卷积增感受野,可变形处理形变。局限是全局建模弱,催生 Transformer。
本章回顾
- 作用:感知基石,检测/分割/车道线/标志都基于 CNN。
- 骨干:ResNet(高精度)、MobileNet(轻量)、EfficientNet(平衡)、HRNet(分割)。
- 特殊结构:空洞卷积(增感受野)、可变形卷积(处理形变)、分组/深度可分离(省算力)。
- 应用:YOLO/Faster R-CNN(检测)、DeepLab/U-Net(分割)、车道线、标志。
- 局限:全局建模弱、计算量大、时序弱,催生 Transformer。
- 选型:高精度 ResNet/EfficientNet,边缘 MobileNet,分割 HRNet/DeepLab。
下一节讲 Transformer。
卷积的算力账本
感知模型的部署瓶颈首先是算力。一个 3×3 卷积在输入 112×112×64 特征图上的乘法次数约为 112×112×64×3×3×64(输出通道)乘上系数,随分辨率、通道数、卷积核尺寸迅速放大。MobileNet 的深度可分离卷积把"通道间混合"和"空间混合"拆开:先逐通道卷积(depthwise),再逐点卷积(pointwise 1×1),计算量降到标准卷积的约九分之一,这就是它在车载端跑得动的原因。
# 计算量对比(示意,忽略边界) std_conv = H*W*C_in*C_out*K*K dw_conv = H*W*C_in*K*K + H*W*C_in*C_out ratio = dw_conv / std_conv # 约 1/9 (当 C_out=C_in 时)
从 ResNet 到空洞与可变形
ResNet 用残差连接解决深层网络退化问题,让几百层的网络可以训练,成为感知骨干的默认选择。空洞卷积在不增加参数的情况下扩大感受野——分割任务里,它让输出保持高分辨率的同时还能"看"到大范围上下文。可变形卷积则让卷积核的采样位置随目标形状自适应变化,对长条形车辆、弯曲的车道等形变目标更友好。选骨干时有个经验:检测分割看 mAP 与延迟的平衡,YOLO 系列用 CSPDarknet 兼顾速度与精度,高精度感知用 ResNet 与 HRNet,边缘部署用 MobileNetV3,实际选型总是围绕"算力预算乘以精度需求"展开。值得一提的还有骨干与任务头的解耦:同一套骨干特征可以被多个任务头共享(检测、分割、车道线各接一个头),这就是多任务感知的基本形态。多任务共享骨干能显著减少重复计算,但也存在任务间特征冲突的问题,需要精心设计损失权重和特征共享层。最后,训练技巧对 CNN 精度影响同样巨大:mixup 与 cutmix 数据增强、余弦学习率、EMA 权重平均、多尺度训练,都是感知模型从"能跑"到"跑得好"的关键差距,模型结构相似的情况下,训练配方往往决定了最终成绩。
补充一点对骨干网络差异的直观理解:同样跑在一颗车规芯片上,ResNet-50 的延迟可能比 MobileNetV3 高数倍,但精度(以 mAP 计)的差距通常只有几个点。这个"延迟差大、精度差小"的特性决定了选型方向——算力有富余时优先用精度更高的骨干,算力紧张时牺牲少量精度换取延迟达标。生产上还会用同一骨干跑多个任务(共享特征),进一步摊薄骨干的算力成本,这也是多任务感知架构在量产中普及的经济学原因。