2.3 MFCC 与 Fbank 特征详解
2.3 MFCC 与 Fbank 特征详解
上一节的功率谱是"半成品"。这一节把它炼成两件成品:Fbank 保留了各频带的能量形状,MFCC 则在 Fbank 上再做取对数和离散余弦变换,去相关、压包络。换句话说,MFCC 更去冗余、适合传统模型,Fbank 更贴原始频谱、常被深度学习模型直接吞下。本节从音量谱一路演算到 39 维常见特征向量,并给出两者在不同时代的选型逻辑。
学习目标
- 能解释梅尔标度为什么对低频敏、对高频钝,并给出与线性频率的换算印象。
- 能按顺序说出 Fbank 到 MFCC 的步骤:梅尔滤波器组、取对数、离散余弦变换。
- 能说出 MFCC 通常保留多少个系数、拼接差分后常见维度是多少。
- 能说明倒谱均值归一化 CMN 消除线性信道影响的原因。
- 能对比 Fbank 与 MFCC 适用场景,给出自己的选型主张。
一、梅尔标度:让机器像人耳一样听
人耳对频率的感觉不是线性的:500 赫兹到 1000 赫兹的差别很刺耳,8000 赫兹到 8500 赫兹的差别却几乎听不出来。梅尔标度就是为了模拟这份非线性:把线性频率映射到一个更"符合人耳"的尺子上,低频被拉伸、高频被压缩。工程上常用对数近似换算。想让特征对人耳有效,就别在均匀的频率轴上死磕,得挪到梅尔轴上。
这一下子解释了后续滤波器组的排列方式:在梅尔轴上均匀布点,映射回线性轴后就变成"低频密、高频疏"的三角滤波器排列。正因为这样,梅尔滤波器组能像耳朵一样把能量分配到最有辨识度的地方。
二、从功率谱到 Fbank
拿到一帧的功率谱后,铺上一组梅尔滤波器(通常 20 到 40 个,多吃 40 常见于现代前端),每个滤波器把它覆盖频带内的能量累加成一个数,就得到 Fbank。它是一串反映"各个梅尔频带上有多少能量"的值,天然携带着声道的形状信息,这正是区分不同音素最需要的。取对数这步,一是贴合人对响度的对数感知,二是压缩幅度波动、提升抗噪性。经过这两步,我们手里就是 Fbank:一份干净、贴合听觉的能量画像。
三、从 Fbank 到 MFCC:去相关与压包络
Fbank 的相邻频带彼此重叠,能量高度相关,共享的信息太多,喂给传统统计模型会拖累估计。离散余弦变换 DCT 此刻登场:它把 Fbank 的供电变换到新的主轴,能量被压到前几个系数上,相关性被大幅打掉。取前 13 个左右系数,就得到一个紧凑的 MFCC 向量。有意思的是,MFCC 的低阶系数反映频谱包络、关键在声道形状;高阶系数携带更多声源细节与噪声,故多被丢弃。
下面这张图把功率谱一路炼成 13 维 MFCC 的事拆成四步:梅尔滤波器组累加、取对数、DCT 去相关、取低阶。
特征炼制四步走
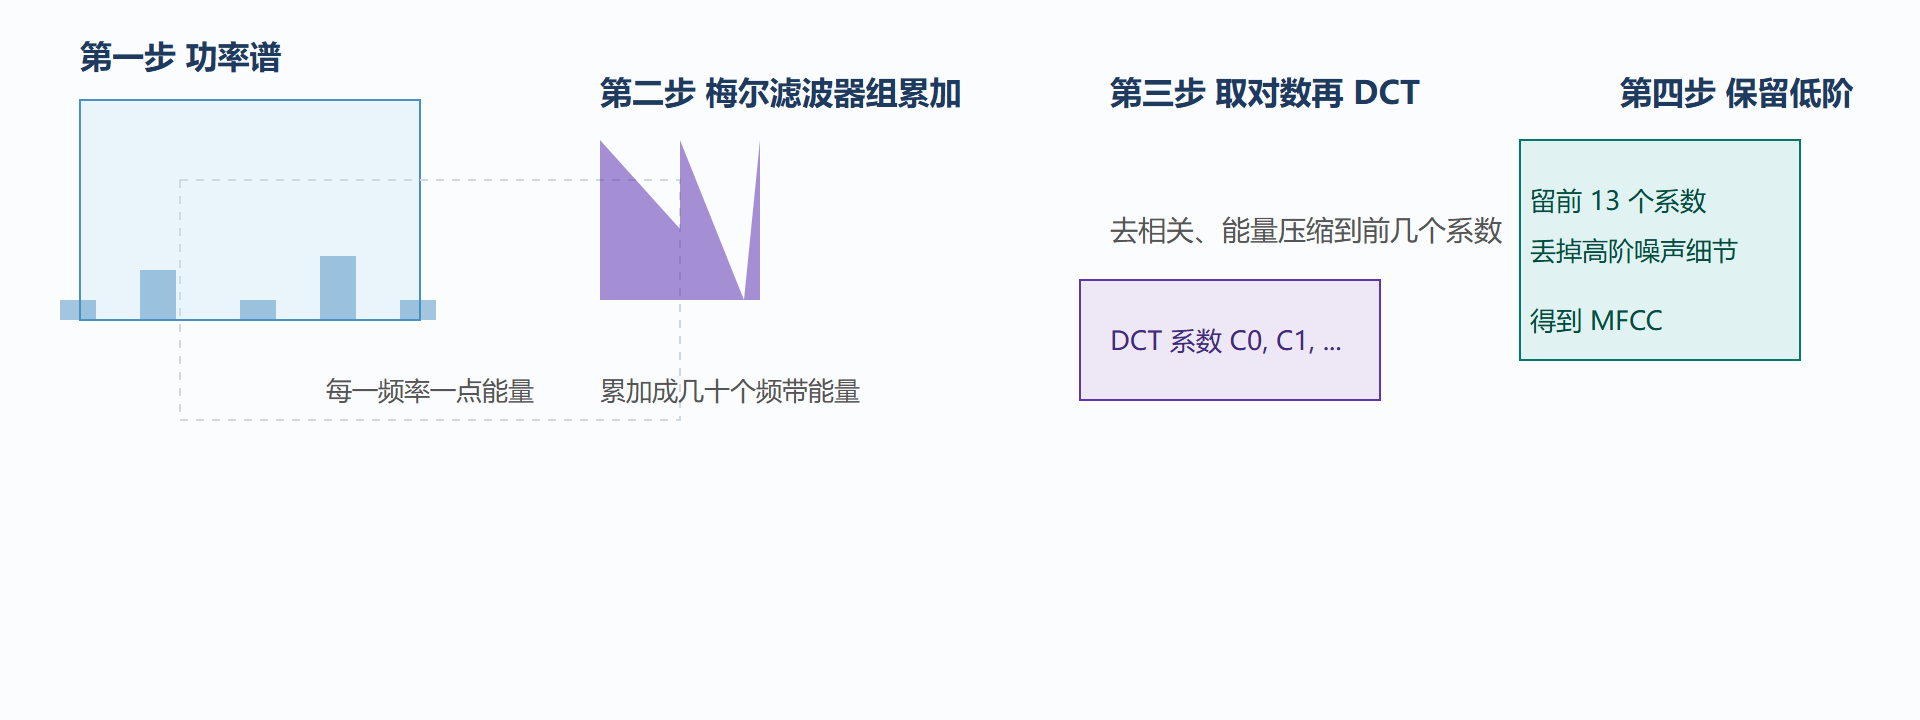
上图从左到右是四台串起来的装置,功率谱最终凝成一列紧凑的 MFCC 系数。
四、差分:把"动起来"的信息补进来
静态 MFCC 只描述一帧的样子,而语音里的辅音过渡、音素边界恰恰藏在"帧与帧怎么变"里。于是给每个系数补上一阶差分(邻近几帧的变化率)和二阶差分(变化加速度)。把它们与静态系数拼起来,13 维静态加 13 维一阶再加 13 维二阶,就得到常见的 39 维特征向量。这一维度的公式至今兜底,很多传统系统直接盯着它对比。
五、CMN:抹掉信道这只手
同一句话用不同麦克风录,频谱会整体偏移,CMN 把一整个语音片段的倒谱平均值减掉,可有效消除这类线性信道差异。若还想压压方差,可以升级成 CMVN。对实时流式系统,通常用滑动窗口做在线近似。这一道工序虽小,却常让 WER 下降一截,属于"低投入高回报"的经典操作。
六、Fbank 对 MFCC:我们更偏向谁
一张直白的对比:Fbank 信息更全、更贴原始频谱,现代深度声学模型靠网络自己学习去相关,故常直接吃 Fbank;MFCC 做了去相关与压缩,数据更省、更适合数据量有限的传统模型。同代工程里我自己的取舍是——数据够多走深度学习,就上 Fbank(必要时加 log 后的静音因子);资源紧张或要接传统 HMM-GMM,就回 MFCC。没有绝对的对错,只有适合的问题。
两种特征在一帧上的概貌,也可以摆成一张表看:
| 特征 | 加工步骤 | 典型维度 | 特性 | 常见去处 |
|---|---|---|---|---|
| Fbank | 功率谱 → 梅尔滤波 → 取对数 | 40 维 | 保留频带能量形状、相关性高 | 深度声学模型直接吃 |
| MFCC 静态 | Fbank → DCT → 取前 13 | 13 维 | 去相关、压包络、紧凑 | 传统模型 |
| MFCC 差分 | 静态 + 一阶 + 二阶 | 39 维 | 补上时序变化信息 | 传统 HMM-GMM 全家 |
七、一帧数字的流转小账
空讲步骤,不如让一帧数字真的走一遍。假设这一帧 FFT 出 257 个频点,是个"原始频谱";铺上 40 个梅尔滤波器,每个滤波器在该帧对应的频带上一累加,就得到 40 个 Fbank 值——此时数量从 257 降到 40,多了听觉的取舍。取完对数,再做一次 DCT,得到 40 个倒谱系数;只取前 13 个,就是 MFCC 静态向量。若接上传统系统,再补一阶、二阶差分,13 + 13 + 13 拼成 39 维。从 257 到 39,数字少了一多半,剩下的都是跟"说得是哪个音"最相关的那部分。
四舍五入地算:257 个原始频谱点里,或许一半以上是冗余到可以直接舍掉的。这一数字的压缩过程,正是 Fbank / MFCC 存在的全部意义——不是信息越少越好,而是"判别用得到的信息留下、判别用不上的信息/噪声赶走"。
再补一句选型之外的口径提醒:新旧两端常常为"Fbank 好还是 MFCC 好"争得不可开交,其实在数据充足的深度模型里,两者最终差距往往很小,真正拉开差距的是特征有没有做对归一化、差分补没补、以及模型结构本身。与其把精力耗在无解的思辨里,不如把力气花在"让特征、建模单元、训练目标三者对齐"这件事上,回报率高得多。选型表只是起点,组合出来的整套流水才是答案。
本节要点回顾
- 梅尔标度:低频敏高频钝,用对数映射还原人耳的听觉。
- Fbank:功率谱过梅尔滤波器组加取对数,保留频带能量形状。
- MFCC:Fbank 再做 DCT,去相关压包络,留前 13 个系数。
- 差分:一阶加二阶差分拼静态,得到常见 39 维向量。
- CMN:减倒谱均值消除信道差异,低投入高回报。
- 选型:深度学习吃 Fbank,传统模型吃 MFCC,视数据与模型而定。
特征层面到了头,下一步得问:这些特征到底在替哪个"单位"打分?下一节把音素、三音素、HMM 状态这三层单位讲清楚。