2.4 语音建模单元
2.4 语音建模单元
声学模型对"谁"打分,取决于我们定义的建模单元。一层比词粗音素,但音素在不同邻居面前会变声;于是有了考虑上下文的三音素,实际落地时还会加上前后各少许边界状态。这一节围绕"单元选多大"讲透三个层次:音素、三音素、HMM 状态,以及状态绑定如何在数据不充裕的角落救场。
学习目标
- 能说明为什么"用音素做单元"比"用词做单元"更划算。
- 能解释三音素如何建模上下文依赖,并给出正反两面的代价。
- 能说清一个音素拆成几个状态的理由,以及各状态在发音中的角色。
- 能理解状态绑定的动机:在数据稀疏时让相近状态共享一个高斯模型。
一、选单元:词太大,音素太小
建模单元直接决定声学模型的工作量。用整词做单元,几万个词各要一份模板,任何没听过的词都束手无策;用音素做单元,汉语几十个声母韵母总量很小,词库外的新词也能拼出来。这是几十年的老智慧:宁可把"词的音"拆成"基元的音",也不肯为每个词单独建模。端到端模型出现后单元又变细到字符甚至子词,道理相同——把发明词的粒度下放给模型去拼。
二、音素也会"变色龙":三音素的由来
单独用一个音素做单元有个致命短板:同一个音素,跟在不同的邻居后面,发音会悄悄变化。比如塞音在不同元音前送气程度、发音部位都不同。若只建模"孤立音素",等于要求一个单元同时应付它所有的变体,必然顾此失彼。解法是把单元从"音素"加码成"三音素"——中间是目标音素、两侧各带一个邻居,例如"a 在 b 和 j 之间"。三音素让每个音素变身成众多上下文专属的小号,分辨率立竿见影地升高。
代价也是直接的:建模单元数量爆炸式增长。若音素有 60 个,理论三音素组合就有 60 的三次方量级,即便做成词典滤掉不存在的组合,数量依然远超单音素。单元多了,每个单元分到的训练样本就少了,数据稀疏就像一只无形的手掐住统计模型的脖子。
三、一个音素拆几段:HMM 状态的由来
光有三音素还不够,一个音素内部也有时间结构——从起始、到中段、到收尾,前三帧和后三帧的声音明显不同。为刻画这种"词内在的时间演化",常把一个三音素再拆成 3 个甚至更多 HMM 状态,各状态描述它在发音阶段的不同代表性帧。声学模型实际打分的,正是这些状态;词→音素→状态,三层都定义好,才能交给隐马尔可夫模型做时序建模。
发音词典把词写成音素串 音素考虑上下文扩成三音素 三音素每个再拆成 3 个内部状态 状态作为声学模型真正打分的单元
上面这五行的层级,就是传统声学模型世界观的骨架。后面所有训练与解码都建立在"对状态打分"之上。
建模单元金字塔
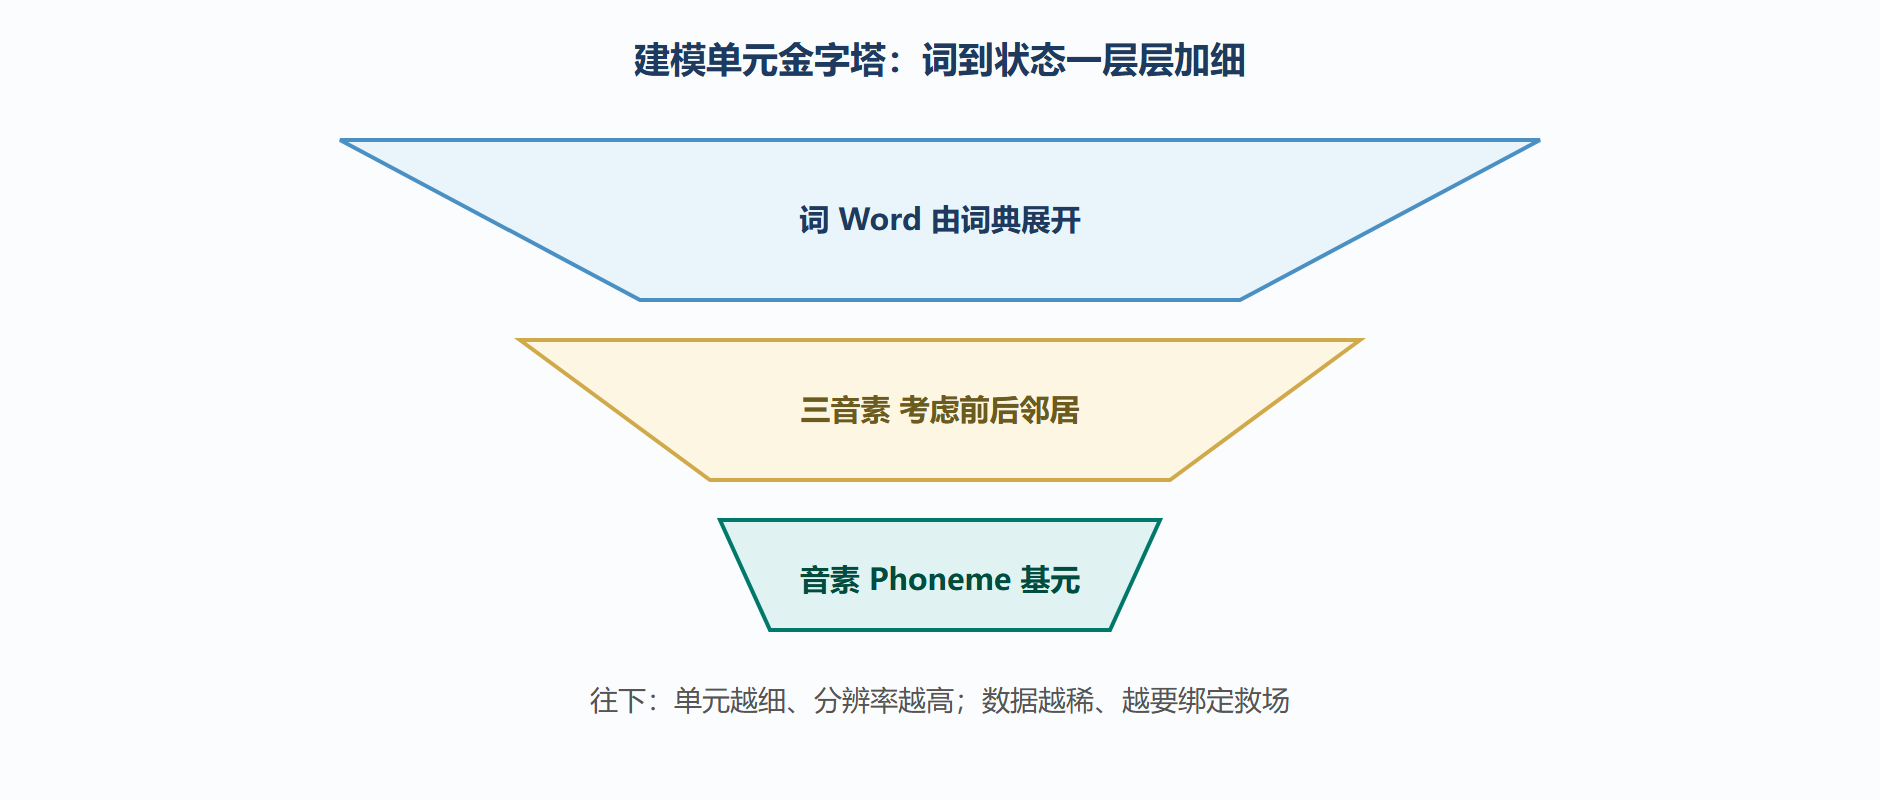
上图把四层从上到下摊开:词最粗,底座是音素,中间是上下文加权的三音素,而真正被打分的是更要细的 HMM 状态(未在图中展开)。
四、状态绑定:数据不够时的救火
单元太细、样本不足是死结。救法叫状态绑定:把声学上高度相似、上下文也接近的状态,合并共享同一个统计分布。这等于不追求每个状态独享一份参数,而是让相近状态抱团取暖,用集体的数据把分布估准。工程上常用决策树给状态分派,按是否同一个邻居、发音部位是否相近等条件,把状态聚类到一起。这一招让模型在数据不充裕时也站得住。
五、单元选择的一笔账
总结一下取舍:单元越细,能表达的发音差异越多,可参数量与数据需求也水涨船高;单元越粗,越好养,却牺牲分辨率。传统系统在这个金字塔上反复权衡,端到端模型则把这个权衡的一大半扔给了网络自己去学。理解了这张金字塔的来龙去脉,你就能看懂为什么老系统里满眼都是"三音素状态",也能明白新系统为什么会反其道而简化它。
六、拿一个汉语音节走一遍
用"好"这个音节收货一下手感。先由发音词典把"好"写成音素串 hhao(声母 h + 韵母 ao,这里写成便于阅读的拼写);给 h 与 ao 各配上上下文,扩成带左右邻居的三音素;再把每个三音素拆成 3 个内部 HMM 状态。于是原本一个轻飘飘的"好",到声学模型嘴里会变成一串"以特定上下文为首尾的若干状态"。真正的打分就是这样,对着一串细小的状态疏通发音的时序。
用一张小表把三种前导条件对状态数量的影响摊开,能直观感受"单元越多数据越稀":
| 建模单元 | 语言里的约为数量 | 上下文敏感度 | 数据压力 |
|---|---|---|---|
| 音素 | 汉语约几十个 | 低(会变色) | 小 |
| 三音素 | 理论可达三次方级 | 高 | 很大 |
| 绑定后三音素状态 | 落到几万量级内 | 高且可承受 | 适中 |
最后那一步"状态绑定",正是把第二行那个吓人的数字收敛到第三行能养得起的水位。
七、单元选择其实在替后面的清算做铺垫
选多大一块单元,看似是声学侧的私事,其实直接决定了第 4 章解码时要搜的路径有多大、第 5 章要数多少个错误。设想不用三音素而用裸音素做单元:解码器的状态网络会小得多、跑得快,可代价是发音变体混在一起,该犯错的地方照样犯错。反过来若三音素拆得过碎、又没做状态绑定,训练数据一喂就崩,评估时对连读语境和少见词的错误会堆成山。换句话说,单元粒度是一道已经替你决定好"后面解码与评估里要付出多少力气"的暗账。读这章若只记得"用三音素、要做状态绑定",那是记住了结论;若还能说出"为什么数据少就要先做状态绑定、不然三音素会饿死",才算真的把这本账接了过去。顺着这个思路往后翻,你会反复看到这笔账在第 4 章搜索规模和第 5 章错误统计里被兑现。
也正因如此,业内换端到端模型时并非把状态概念全盘扔掉,而是把"该用多细的单元"这个决定从人工写死变成了网络自己自适应——字符、子词更碎,但粒度由数据决定。看懂这层演变,你就明白建模单元不是一道固定的选择题,而是一条随数据与算力不断下移粒度的底线。这章讲的三音素、状态绑定,正是这条底线在过去那个数据匮乏年代的解题姿势;今天条件变了,解法可以换,但"粒度需与数据匹配"这条底层的账,永远翻不过去。
本节要点回顾
- 词单元:太大、覆盖不了新词,故往基元化小。
- 音素单元:量小通用,但对上下文敏感。
- 三音素单元:带邻居建模上下文,分辨率高、数据压力大。
- HMM 状态:一个音素拆 3 个状态,刻画时间演化,是真正打分的单元。
- 状态绑定:相似状态共享分布,缓解数据稀疏。
- 核心权衡:单元粒度与数据充足度注定互相拉扯。
单元定了,就得选一套让这些状态说得出概率的模型课。下一节看传统的老牌选手:GMM-HMM。