2.5 传统声学模型 GMM-HMM
2.5 传统声学模型 GMM-HMM
深度学习登场前,主流一直是 GMM-HMM 这套组合拳:HMM 负责状态时序建模,GMM 负责给每个状态算发射概率。它在连续语音识别时代独霸江湖几十年,留下了一整套工程思想,至今值得吃透。本节把 HMM 解决什么问题、GMM 解决什么问题讲清楚,并和你一起过一遍整个流水线。
学习目标
- 能说出 HMM 在 ASR 里负责哪块问题(时序),GMM 又负责哪块(发射)。
- 能解释隐马尔可夫假设的两条:当前状态只依赖前一个、观测只依赖当前状态。
- 能说清 GMM 如何为状态定义分布,它又有什么天生的局限。
- 能讲出前向后向算法、维特比算法分别做了什么。
- 能理解为什么数据稀疏会让 GMM 出问题。
一、分解问题:谁管时间,谁管特征
把 HMM 和 GMM 的分工一句话拆开:
- HMM 隐马尔可夫模型:管整个词的时序结构——状态从开始到结束怎么走,一步一步怎么转移。
- GMM 高斯混合模型:管当前状态下,"这一帧特征像不像它"的概率,即发射概率。
如果把一句话的识别比作走迷宫,HMM 告诉你"这一步能走到哪几个格子里,每个格子概率多大",GMM 告诉你"当前帧落在我这个格子里概率多大"。两者的配合就是这么直白。
二、HMM:把音素串起来的骨架
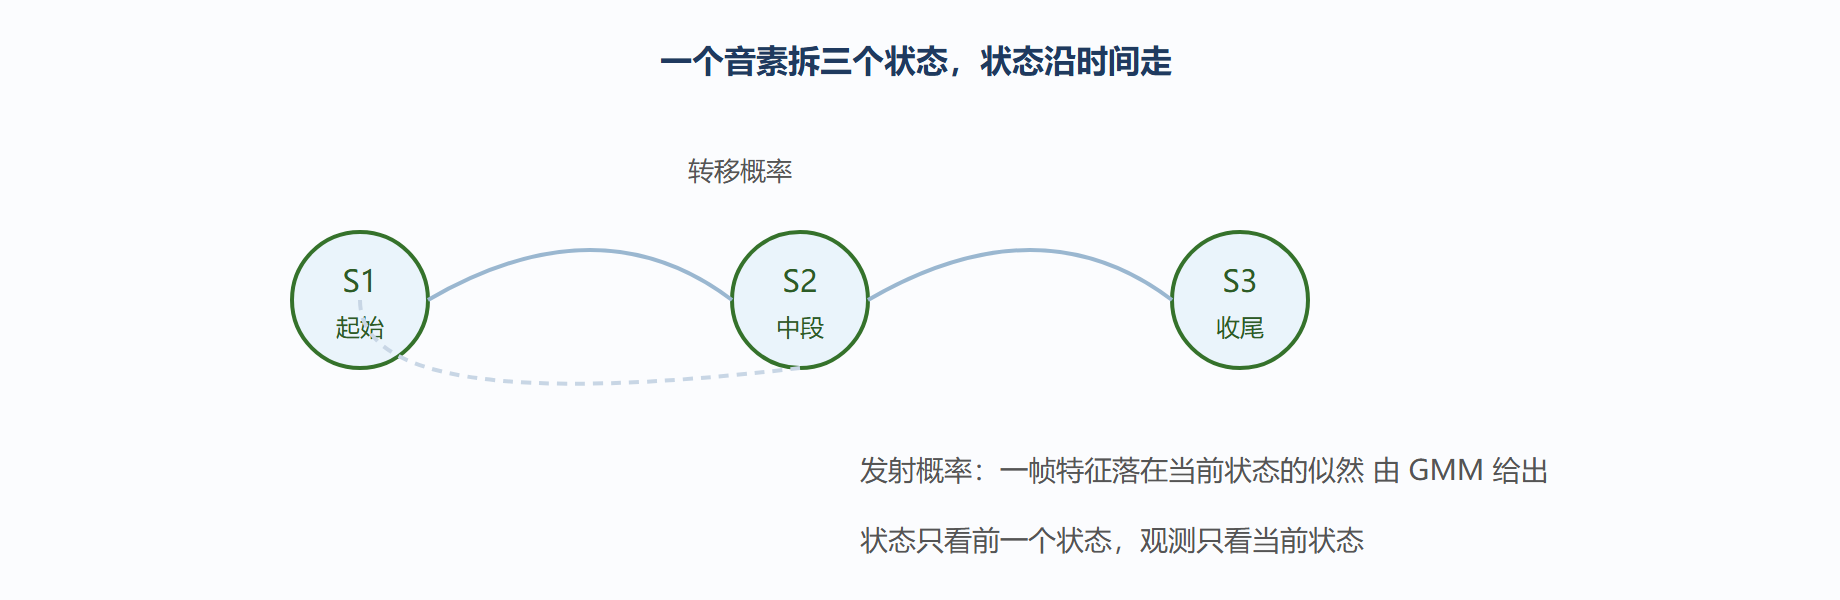
一条音素链出来之后,每个音素拆成三个状态,整个单词就变成一串状态。HMM 的一阶马尔可夫假设直接说破:下一状态只由当前状态决定;现在这帧的声学观测只由当前状态决定。这个假设非常理想化,但它简化了计算,让几十年前的计算机就能跑得动整个词。这两件假设画出来就是:
状态只看前一个状态,观测只看当前状态。干净、简单,给整个问题开了绿灯。
转移概率 A 描述"从一个状态跳到另一个状态有多大可能性",发射概率 B 描述"每个状态发出当前这帧特征有多大概率",初始概率 π 描述"哪些状态更容易开头"。这三个矩阵 π、A、B ,就是 HMM 要训练的全部参数。
三、GMM:给每个状态打出概率分
拿到一帧特征,HMM 问 GMM:这一帧在你这个状态下概率大不大?GMM 用几个高斯分布加权混合去逼近状态下特征的真实分布,得分高意味着匹配度好。理论上,一个 GMM 只要分量够多,就能拟合任何连续分布,但实际到了 ASR,状态太多分量也多,参数爆炸,数据不够就估不准。而且高斯分布假设特征维度独立,这不太符合 MFCC 分量之间的实际相关性。这两个弱点,给后续 DNN 替代 GMM 埋下了伏笔。
四、三件算法:训练与识别
GMM-HMM 的三件算法,各负责一件事:
- 前向后向算法:给定 HMM 参数和观测序列,算出整条路径的总概率,用来给 Baum-Welch 提供似然计算。
- Baum-Welch 算法:EM 算法在 HMM 上的落地,迭代更新转移概率和发射概率,最大化训练数据的似然。
- Viterbi 算法:给定参数与观测,找出最优状态路径,用来对齐语音帧与状态,也用来在解码阶段找最优句。
维特比算法在后续解码环节还要大量见面,第 4 章会再展开它。这里你只要知道:它是一个动态规划,找到概率乘积最大的那条状态路径即可。
五、GMM-HMM 的天花板
这套组合拳走过了几十年,解决了连续语音识别从实验室到产品的核心问题,但也摸到了天花板:
- 维度独立假设跟实际不符合,高维特征下拟合能力受限。
- 模型越大,数据越稀疏,很多 GMM 参数估不准,状态绑定只救得了一部分。
- 模型本身对上下文关联的捕捉很弱,远不如神经网络直接吃上下文特征。
这些天花板,最终让深度学习把 GMM 的位置拿走,但 HMM 建模时序的思想还活在很多端到端模型里,并没有彻底退场。
GMM-HMM 时序模型示意
六、把一次训练循环说成一口气
空记算法名,不如把它在训练时的动作走一遍。手里有一大堆"已知说了什么"的音频与转写。第一步,用发音词典把每句话扩成音素→三音素→状态的串,这就得到一组带隐状态的骨架。第二步,前向-后向算法对每帧算出"它落入各状态的后验概率",把它当成软标签。第三步,Baum-Welch 拿着这些软计数,重新估计发射概率(GMM 的均值与方差)和转移概率,让整条语料的总似然变大。第四步,拿刚更新的模型重新对齐帧与状态,再回到第二步——如此迭代若干轮,直到似然不再上升。
这个"对齐→重估→再对齐"的循环,是传统 ASR 训练的灵魂。许多初学以为声学模型是一步训练出来的,其实它是这轮循环一层层"挤"出来的。正因为每次对齐都依赖上一次的模型,起点(初始的发音词典)若有偏差,整个循环都会偏——这也解释了为何传统系统里发音词典往往被反复手工打磨。
七、三件算法各管哪一段
把它们按"训练/识别"划个账,比背书快得多:
| 算法 | 阶段 | 给它什么 | 拿回什么 |
|---|---|---|---|
| 前向-后向 | 训练 | HMM 参数 + 一帧帧观测 | 各帧在各状态的后验 |
| Baum-Welch | 训练 | 这些后验 | 更新后的参数 |
| Viterbi | 训练/识别 | 参数 + 观测 | 最优状态路径 |
三件里前两件只在上规模的训练管道里现身,第三件则一路跟到第 4 章解码。
顺带把这套老手艺在今天的坐标定位一下:它与其说是被淘汰了,不如说是被收敛进了一个更大的框架。新的端到端系统里,HMM 的"状态串起来能建模时序"这个思想并没有消失,只是时序推断被网络和注意力机制吸收;真正被替换掉的,是"用谁来算发射概率"这一个环节。所以当你读到第 2.6 节,别急着宣布 GMM-HMM 已死——能读懂它,你反而能看懂新系统里哪些是换代、哪些只是换了张脸。
本节要点回顾
- 分工:HMM 管状态时序转移,GMM 管状态对特征的发射概率。
- 隐马尔可夫假设:下一状态只依赖当前状态;观测只依赖当前状态,简单好算。
- 三件核心算法:前向后向算总概率,Baum-Welch EM 迭代训练,Viterbi 找最优路径。
- GMM 局限:假设维度独立、参数多易稀疏、拟合能力比不过深度网络。
- 遗留思想:HMM 对隐状态时序建模的思路,至今仍有价值。
接下来看:当深度网络接过发射概率这杆枪,GMM-HMM 变成 DNN-HMM,性能又会涨成什么样呢?下一节讲深度声学模型。