3.4 神经语言模型
3.4 神经语言模型
神经网络让语言模型的"上下文半径"一下子拓到不限长。从最早的前馈网,到能把历史装进隐藏状态的循环网,再到看任意位置的 Transformer;语言模型完成了从"计数"到"表示学习"的换代。这一节沿着这条路走一遍,讲清每一种结构在治什么病,以及它们在 ASR 语言侧各自的用武之地。
读完该会什么
- 能说出前馈神经网络语言模型受限于固定窗口的原因。
- 能解释 RNN/LSTM 的隐藏状态如何携带任意长的历史,但又有梯度与速度的软肋。
- 能说明 Transformer 自注意力如何并行处理整条序列、捕捉长程依赖。
- 能结合 ASR 场景说出深度语言模型作为语言先验的优势与代价。
一、从固定窗口到隐藏记忆
N-gram 的病根在固定窗口。最早的前馈神经网络语言模型也有这毛病:输入前 N-1 个词的词向量拼接,输出下一个词的概率,拉长的只是"窗口内是向量",窗口照样定死。但换个角度看,把词表示成向量这件事本身就值钱——模型的相似性开始存在于隐藏的表示里,不再是死板的计数。第二步其实是把"窗口"换成"历史记忆"的 RNN:用隐藏状态把整句话的历史都揣着走,词接得越久,知识沉淀得越厚。这一步才真正拜托了固定窗的限制。
二、RNN 的温情与软肋
RNN 对着变长序列温柔,可也有两个挡不住的软肋,一是梯度会随长序列的传播而消失或爆炸,长程依赖学到一半就断掉;二是一帧接一帧串行跑,学得慢。工程界用 LSTM 和 GRU 上了两个对策:引入门控机制把"该记住的信息"和老旧的梯度都护住,能往后传更长的距离。软肋之二依旧要忍受串行慢速,这是它和更彻底的并行结构之间无法调和的矛盾。
三、Transformer:把"注意力"织进序列
Transformer 用自注意力一步到位,把序列里任意两个位置的依赖都捞出来,深度层叠,彻底并行。对语言模型而言,它捕捉长距离粘连的能力比 RNN 更游刃有余,训练也能在多卡上并行,故大语言模型几乎全站 Transformer。偏后续预训练的海量文本,凝成一个个能派上大用场的语言表示。
四、深度语言模型在 ASR 的重打分与主力
神经语言模型因为又大又慢,过去主打的场景是重打分(rescoring):先让轻快的 N-gram 出第一轮的候选句子列表,再用一个强大的神经模型给这些候选重新打分,精修路径。近年则把语言先验直接揉进端到端解码的比分里,或以融合语言模型的形式参与识别。它的代价是训练要吃海量文本、显存与算力高企;而它带来的语言约束之强,是 N-gram 怎么也够不着的。
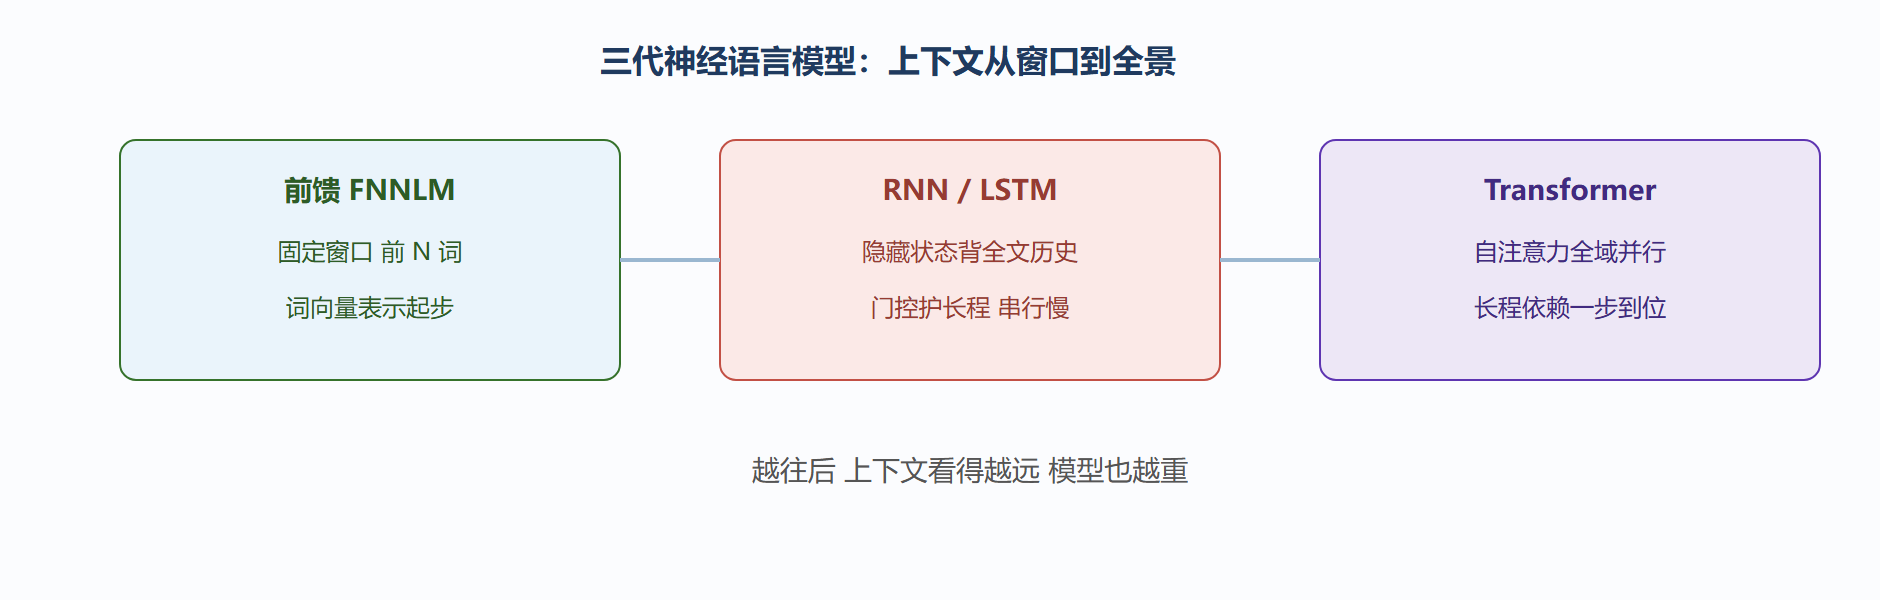
三代神经语言模型对比
五、用一次重打分看清价值
深度模型常常不是上场跑第一轮,而是做第二轮的精修,术语叫重打分。设想第一轮 N-gram 给出一句候选清单,排在最前面的两句是"他去体过检"和"他去过体检"。N-gram 只记住了局部"过检"和"体检"的频率,可能把顺序放反或打平。此时神经语言模型读了整句上文——"他中午说要抽空"——会给出截然不同的判断:在这个语境里"去过体检"远比"去体过检"顺口,于是重打分把次序一举调转。
三代神经模型放在一张表里,换代逻辑一目了然:
| 结构 | 看多长上文 | 并行效率 | ASR 常见位置 | 主要软肋 |
|---|---|---|---|---|
| FNNLM | 固定窗口 | 快 | 早期重打分 | 窗口死板 |
| RNN/LSTM | 理论不限 | 慢、串行 | 重打分 | 梯度、慢 |
| Transformer | 任意位置 | 高、可并行 | 重打分、端到端融合 | 数据与算力重 |
深挖一层:语言模型的强弱,很多时候就差在"它到底看了多远的上文"。设两句候选:"他说今天加班"和"他说今天嘉兴",只看最后两三个词,二者都说得通;可若语言模型能把上文一路看到"项目周五就要上线","加班"的先验就会被抬得老高,N-gram 只看局部、分不出高下的死板就暴露了。这就是隐藏状态与自注意力的价值:它们回答的不是"这个 n 元组概率多少",而是"站在整段话的立场上,哪个词更顺"。也正因如此,用轻量 N-gram 做第一轮、用重网络做第二轮重打分,才能在成本可控下把"看多远"的优势榨出来。
再把"看多远的代价"摆成账:上下文看得越长,模型越强,可每次都要把整句历史喂进显存,推理延迟直线上升,第一轮在线解码根本扛不住。所以工程上不是"越强越好",而是把"谁在第一轮跑(轻、快)、谁在第二轮精修(重、准)"的分工定清楚。这套分工,恰是下一节重打分实战要手把手教的——先记住这个分工,再去看操作,就不会被"为什么要两套模型"困扰。
顺带把"表示学习"四个字落到实处:神经语言模型给每个词学的不是死计数,而是一串能表达"它跟谁常一起出现、跟谁语义相反"的向量,这层向量又被后续的 ASR 语言融合当作接口来用。正因为有了硬概率加软表示这两层,神经语言模型才能在重打分、语言融合、乃至语音语义判断里到处开花——这是 N-gram 那种"只产出一个数字"的做法永远替代不了的。所以读语言模型时,别只盯着它输出的那个概率,还要留意它顺手养出来的那一层表示。它承上启下,既决定了第 3.5 节怎么把第二轮的重分接进第一轮,也让第 4 章端到端模型里的语言约束有了可搬的零件。
顺带点一句:语言模型的"软表示"和"硬概率"是同一块硬币,读库代码时若只盯着输出概率,容易错过那层更有复用价值的向量。把它当作资产存下来反复用,是工程里常被低估的一份收获。
本节要点回顾
- 换代本质:从"计数"转向"表示学习",上下文从固定窗到不限长。
- FNNLM:仍受固定窗口限制,但引入词向量表示。
- RNN/LSTM:隐藏状态背全文,门控护长程,但串行与梯度有软肋。
- Transformer:自注意力并行抓长程,是大模型主力。
- ASR 里的位置:重打分与语言融合是主战场,效果好但更重。
了解了模型家族,下一节趁热打铁,讲一块能用理论造出好成绩的实战配方:神经网络语言模型的训练与重打分。