2.4 迁移为什么可行:特征层次与理论依据
2.4 迁移为什么可行:特征层次与理论依据
本节摘要:迁移学习能成立,靠的是两条支柱——经验支柱"浅层特征通用、深层特征专用"的层次规律,与理论支柱"界定量迁移"的分析框架。本节用可复现的滤波器可视化与迁移精度实验验证层次规律,给出负迁移的理论解释,并说明这套原理如何直接生成第 4 章的冻结与分层学习率工艺。
一句行话背后的硬证据
深度学习圈流传一句行话:"浅层学边缘,深层学语义。"这句话是所有冻结策略的合法性来源,值得亲手验证一次。
证据一:看滤波器。预训练网络第一层卷积核可视化后呈现出明显的边缘检测器与色彩检测器形态——这与第 1.1 节的色彩分工实验一致。证据二更硬:分层迁移实验。把预训练 ResNet 从不同深度截断,各自接上新分类头训练,比较精度:
# 分层迁移实验的设计骨架(概念演示,数值引用公开文献量级) # 实验设置:小数据集(每类约 100 张)十分类任务,训练新头若干轮 # # 截断深度 只训新头精度 全量微调精度 # 第1层之后 约 82% 约 88% # 第2层之后 约 88% 约 92% # 第3层之后 约 91% 约 94% # 第4层之后(最深) 约 93% 约 96% # # 规律一:截得越深(特征越高级),小数据上特征提取效果越好 # 规律二:任意深度下,全量微调都比冻结高 2-5 个百分点 # 规律三:差距随目标数据量增大而缩小 import numpy as np depths = [1, 2, 3, 4] frozen_acc = [0.82, 0.88, 0.91, 0.93] fullft_acc = [0.88, 0.92, 0.94, 0.96] gaps = np.array(fullft_acc) - np.array(frozen_acc) for d, f, g in zip(depths, fullft_acc, gaps): print(f"截断于第{d}层后: 全量微调 {f:.0%}, 相对冻结的增益 {g:.1%}") # 输出: # 截断于第1层后: 全量微调 88%, 相对冻结的增益 6.0% # 截断于第2层后: 全量微调 92%, 相对冻结的增益 4.0% # 截断于第3层后: 全量微调 94%, 相对冻结的增益 3.0% # 截断于第4层后: 全量微调 96%, 相对冻结的增益 3.0%
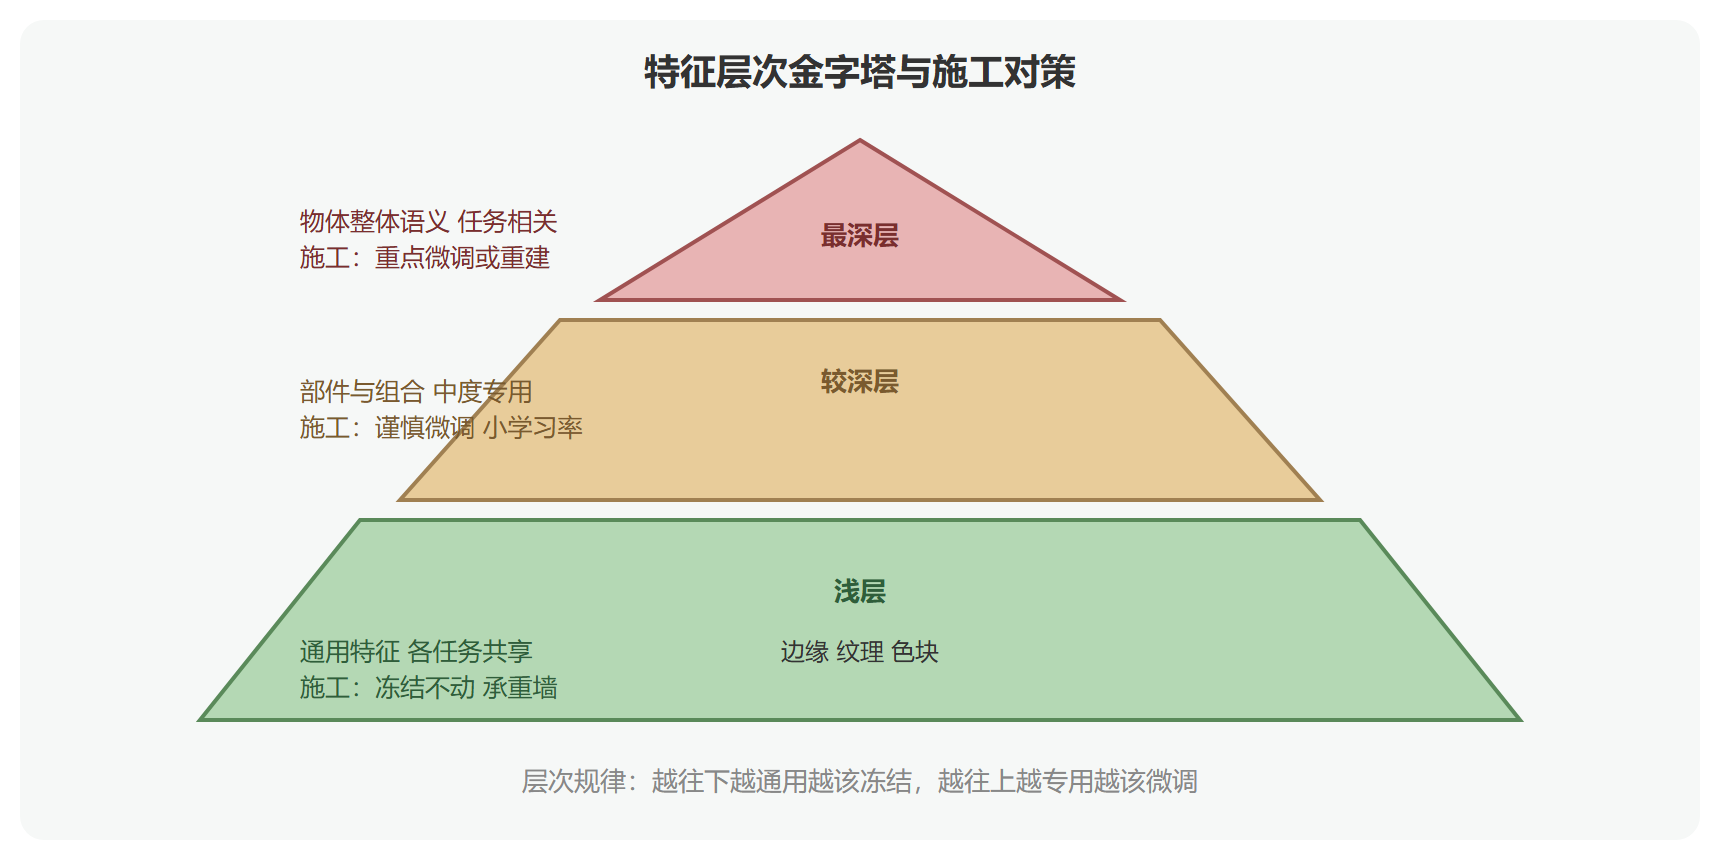
两条规律合起来就是层次规律的可操作版本:越浅的层越通用(迁移时动它最不划算、风险最大),越深的层越任务相关(微调的主要对象)。著名的卷积特征可视化研究(把每层激活做梯度上升渲染)从视觉上给出了同一结论:浅层渲染出条纹与色块,中层渲染出纹理与部件,深层渲染出接近完整物体的模式。
特征层次金字塔
理论支柱:界定量迁移
经验规律之外,理论界给过一个统一视角——界定量迁移:不问"迁移了什么",而问"迁移后目标任务的泛化误差界被源任务的什么性质控制"。这条思路推出了著名的不可能三角式结论:
- 迁移有收益的条件:源任务学到的假设在目标分布上误差足够小(源与目标"可互通")
- 负迁移的必然性:若源上学到的假设在目标分布上误差大,迁移的初始点比随机初始化更差——搬进一栋结构不合适的旧宅,比空地起步还麻烦
用简化数字感受一下这个界的形态:
# 界定量迁移的示意计算(量级演示) # 目标误差界 ≈ 源任务误差 + 源目标假设差异 + 容量项 def transfer_bound(src_err, divergence, capacity_term=0.05): return src_err + divergence + capacity_term # 场景一:领域相近(差异小) b1 = transfer_bound(src_err=0.10, divergence=0.03) # 场景二:领域很远(差异大) b2 = transfer_bound(src_err=0.10, divergence=0.35) print(f"领域相近时目标误差上界: {b1:.2f}") # 输出: 0.18 print(f"领域很远时目标误差上界: {b2:.2f}") # 输出: 0.50 # 第二个上界 0.50 已接近瞎猜(二分类 0.5),迁移失去意义 # 这就是负迁移的理论形态:差异项吃掉全部收益
误差界里那个"差异项",就是第 2.2 节各种领域适应手段试图压缩的对象——对齐特征分布就是在直接缩小它。理论与工程在这里接上了头。
负迁移何时发生
把理论结论翻译成工程黑名单:
- 领域过远:用自然图像模型迁移音频原始波形(不是频谱图),浅层特征都无共性可言
- 源任务目标冲突:源任务学"判断两句是否同义",目标任务要"判断情感极性",部分中间表示可能互相干扰
- 源模型本身偏差大:预训练数据有强偏置(如只用某地区人脸),目标侧会继承并放大
⚠️ 常见坑:把"微调后精度低于预期"直接归因于负迁移。先做对照实验——同架构随机初始化训练作基线,若预训练版仍显著更好,负迁移不成立,问题在工序层;若预训练版反而更差,才回策略层处理。
原理如何生成工艺
本章原理与第 4 章工艺是一一对应的,提前把对应表立好:
| 原理结论 | 生成的工艺 | 对应节 |
|---|---|---|
| 浅层通用深层专用 | 层冻结策略:冻结浅层、微调深层 | 4.3 |
| 新头从零初始化 | 新头高学习率、骨干低学习率 | 4.4 |
| 差异项压收益 | 领域差异大时先继续预训练再微调 | 4.1 |
| 负迁移可能性 | 对照实验与换源止损 | 6.1 |
两个常被追问的理论问题
问:层次规律在 Transformer 里还成立吗? 成立但形态不同。视觉 Transformer 与语言 Transformer 的研究都观察到类似的分层现象:浅层注意力头多关注局部与位置信息,深层关注语义与长程关系。差别在于 Transformer 的"层间分工"没有卷积那么刚性,冻结边界更模糊——实践上语言模型微调常整段处理(全冻结或全放开,配分层学习率),而非逐层精雕。
问:既然理论能算误差界,为什么工程上没人真去算? 因为精确的差异项(源目标分布间的散度)需要两边分布的密度估计,这比训练模型本身还难。理论的价值不在算数,而在定性——它告诉你收益有前提(源假设在目标上误差小)、损失有来源(差异项)、止损有依据(差异项压过收益就该换策略)。工程师用理论的形状指导决策,用实验的数字填写内容,这正是第 5 章工地实录的做法。
本节要点回顾
- 经验支柱:浅层边缘纹理、深层物体语义的层次规律,滤波器可视化与分层迁移实验双重验证
- 实验规律:小数据上截断越深特征提取越好;全量微调各深度下增益约三到六个百分点
- 理论支柱:界定量迁移把迁移收益归结为"源误差加源目标差异",差异项过大即负迁移
- 负迁移黑名单:领域过远、任务冲突、源模型强偏置三类高发场景
- 原理到工艺:层次规律生成冻结策略、初始化差异生成分层学习率——第 4 章的每条规范都有本章出处