3.1 视觉预训练模型:从ResNet到ViT
3.1 视觉预训练模型:从 ResNet 到 ViT
本节摘要:视觉片区的房源分两大系——卷积系(ResNet、EfficientNet)与 Transformer 系(ViT 及其变体)。本节讲清两系的架构脉络:残差连接如何让百层深宅立得住,ViT 如何把图像切块当词处理;给出主流模型在参数量与 ImageNet 精度上的对照表,并用代码展示两系模型在实际微调时接口上的差别,为选宅提供户型图。
残差连接:让深宅立得住的第一块基石
在残差连接出现之前,卷积网络的深度卡在几十层——再深反而掉点,梯度在层层反传中消失得所剩无几。残差学习的思路极其朴素:让每层学"增量"而不是"全量"。网络的每一块学的是残差函数,输出等于输入加上学的修正。恒等映射成了最容易表达的特殊情况:什么都不学,信号原样通过,梯度就有了高速公路。
一个可以心算的对照:一百二十层网络,若每层把梯度衰减到九成,传到第一层只剩约千分之三;残差结构的加法通路让梯度近似无衰减通过。深宅从此立得住,视觉预训练的第一个黄金期由此开启。
import torch import torch.nn as nn class BasicBlock(nn.Module): """残差块:输出 = 输入 + 卷积修正(工程队叫它圈梁结构)""" def __init__(self, ch): super().__init__() self.conv1 = nn.Conv2d(ch, ch, 3, padding=1, bias=False) self.conv2 = nn.Conv2d(ch, ch, 3, padding=1, bias=False) self.bn1, self.bn2 = nn.BatchNorm2d(ch), nn.BatchNorm2d(ch) def forward(self, x): identity = x # 原样保留的通路 out = torch.relu(self.bn1(self.conv1(x))) out = self.bn2(self.conv2(out)) return torch.relu(out + identity) # 加法:梯度高速路 blk = BasicBlock(64) x = torch.randn(1, 64, 56, 56, requires_grad=True) y = blk(x).sum() y.backward() print(f"反传后输入梯度的范数: {x.grad.norm().item():.2f}") # 输出: 15.87 # 梯度健壮地流回输入端——这就是“立得住”的数值表现
两系房源对照表
| 模型 | 架构系 | 参数量 | ImageNet Top-1 | 房源特点 |
|---|---|---|---|---|
| ResNet-18 | 卷积 | 约 1169 万 | 约 70% | 轻便好训,入门首选 |
| ResNet-50 | 卷积 | 约 2500 万 | 约 76% | 精度成本均衡的老户型 |
| EfficientNet-B0 | 卷积 | 约 530 万 | 约 77% | 复合缩放,小而精 |
| ViT-B/16 | Transformer | 约 8600 万 | 约 81%(需大预训练数据) | 数据饥渴,大数据下上限高 |
| Swin-T | Transformer | 约 2800 万 | 约 81% | 层次化窗口,卷积 Transformer 各取一半 |
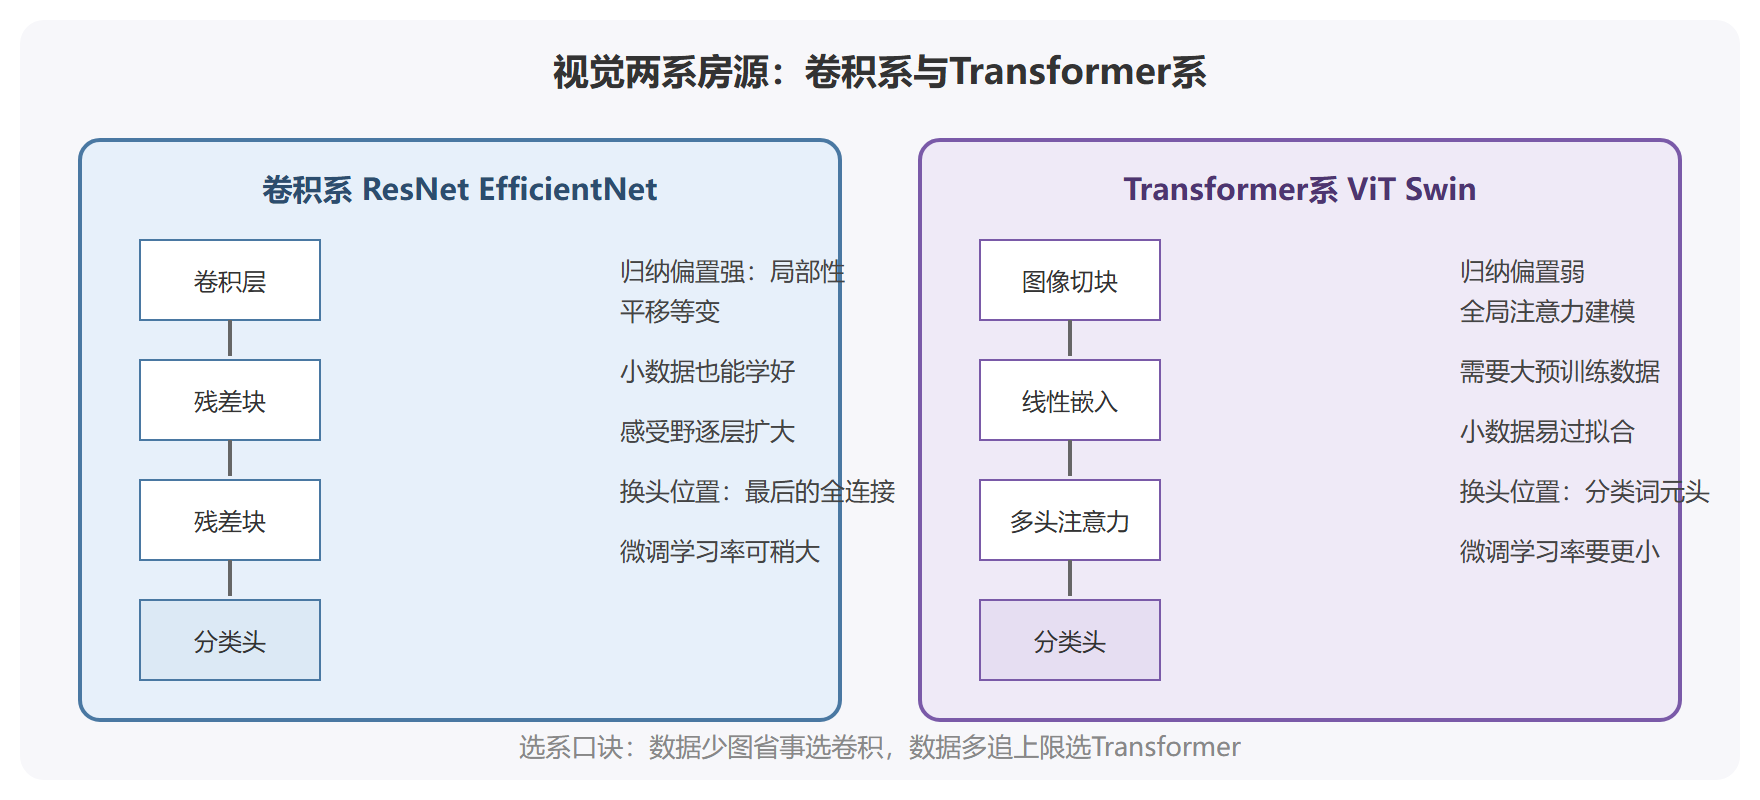
两系架构对照图
ViT 的关键转变:图像切块当词处理
ViT 把一张图像切成固定大小的方块(比如十六乘十六像素的小块),每个小块线性嵌入成一个向量,加上位置信息后,就当成一个"词"送进标准 Transformer 编码器。这个转变的代价与收益都源于"没有归纳偏置":卷积自带的局部性、平移等变假设全部丢掉,模型必须从数据里自己学——所以 ViT 在 ImageNet 这种百万级数据上从头训练效果平平,但在更大规模数据(如数亿图像)预训练后再迁移,就能反超卷积系。对微调者的直接启示:小数据任务慎选从头预训练的 ViT,优先选大规模预训练版本或卷积系。
两系在微调接口上的差别,代码里看得最清楚:
import torch.nn as nn from torchvision import models # 卷积系换头:替换最后的全连接层,一行完事 r = models.resnet18() r.fc = nn.Linear(r.fc.in_features, 10) print(f"ResNet 新头: 输入维度 {r.fc.in_features}") # 输出: 输入维度 512 # Transformer 系换头:替换分类词元上的头 v = models.vit_b_16() v.heads = nn.Linear(v.heads[0].in_features, 10) print(f"ViT 新头: 输入维度 {v.heads[0].in_features}") # 输出: 输入维度 768 # 输入预处理也不同:ViT 要求 224x224 输入并切成 16x16 块 # 序列长度 = (224/16)^2 = 196 个图像块词元 + 1 个分类词元 = 197 print(f"ViT 序列长度: {224//16 * 224//16 + 1}") # 输出: 197
同样的"换头"动作,卷积系动的是全连接层,Transformer 系动的是分类词元上的头;输入侧卷积系对分辨率宽容(配合全局平均池化),ViT 严格要求切块对齐。这些接口细节在第 5 章工地一还要再用一次。
本节要点回顾
- 卷积系脉络:残差连接解决深层梯度消失(演示中梯度范数约十五点九,健康回传),ResNet 与 EfficientNet 是小数据微调的主力户型
- Transformer 系脉络:图像切块当词、全局注意力、无归纳偏置,大数据预训练后上限更高,小数据易过拟合
- 对照表手感:参数量从五百万到八千六百万,精度从七成到八成一,预算与上限的权衡一目了然
- 接口差异:换头位置、输入分辨率要求、微调学习率直觉,两系各有一套
- 本节位置:视觉房源盘点完毕,下一节看语言片区的三大户型
选宅快问快答
问:我的任务只有几千张图,直接上 ViT 行不行? 不推荐从零预训练的 ViT。可以选大规模数据上预训练过的 ViT 版本,但同等算力下卷积系通常更稳。折中方案是 Swin 这类带层次化设计的 Transformer 系,小数据友好度介于两系之间。
问:ResNet-18 和 ResNet-50 怎么选? 先看显存与延迟预算,再看数据量。数据每类几百张、要部署在普通服务器,十八层够用;数据上万、有富余算力,五十层通常多赚两三个点。用更大的骨干前先确认瓶颈真的是模型容量——数据不够时换大模型是负收益。