1.4 人工智能的基石:数据、算力与算法
1.4 人工智能的基石:数据、算力与算法
本节摘要:业内有两句行话流传很广:垃圾进、垃圾出——模型的上限由数据决定;算力不自由、模型不说话——实验速度由算力决定。数据是石油:要勘探(获取)、取芯(标注)、炼化(预处理)才能入炉;算力是发动机:CPU、GPU、TPU、NPU 各司其职,云计算把算力变成可租用的公共设施;算法是图纸:监督、无监督、强化三条学习路线决定燃料如何转化为能力。三者构成短板效应与复利循环——本节逐一拆开三块基石,再看它们如何互相放大,这是理解 1.2 节第三次浪潮续航力的钥匙。
阅读收获
- 区分结构化、非结构化、半结构化数据,并各举一例
- 说出数据四特征(数量、多样性、真实性、速度)如何影响模型表现
- 比较 CPU、GPU、TPU、NPU 的分工,解释 GPU 为何适合训练
- 列出监督、无监督、强化三类学习范式与代表算法
- 用短板效应诊断一个AI项目最该补哪块基石
一、数据:先勘探,再炼化
行话"垃圾进、垃圾出"说得直白:喂给模型什么质量的数据,它就学出什么质量的本事。数据不是拿来就能用的原料,更像埋在地下的石油,得经过一整套勘探与炼化流程。
先看矿藏的种类。结构化数据是规矩的表格:银行交易流水、数据库里的订单记录,行列分明,机器直接可读。非结构化数据没有预定义格式:文章、照片、语音、视频,占互联网数据的大头,也是当前AI的主战场。半结构化数据介于两者之间:以 XML、JSON 这类带标签的格式组织,虽不像表格那样规整,却自带结构线索。
再看衡量矿藏品位的四个特征。数量:深度模型的参数动辄以亿计,样本不够就学不全模式,量越大泛化越稳。多样性:训练自动驾驶不能只喂晴天的路况,雨雪、夜间、逆光一个都不能少,否则模型只在训练分布内是高手。真实性:错误、缺失与偏见会原样学进模型——训练集里某类人群样本偏少,模型对这类人的表现就会明显打折。速度:交易风控、实时推荐要在数据产生的瞬间消化它,晚一秒就贬值。
采集与加工的流程,几乎就是一张地质勘探作业表。圈定远景区,对应数据获取:用公开数据集(图像领域的 ImageNet、目标检测领域的 COCO 都是明星库)、传感器采集、企业内部业务沉淀、众包平台人工收集。钻井取芯,对应数据标注:监督学习需要人给每条样本贴上正确答案,图片里框出物体、语音对上文字,劳动密集、成本高昂,但标注质量直接封顶模型上限——这是全流程最贵也最不能省的一步。炼化,对应预处理:清洗掉缺失值、异常值与重复记录;把类别变量转换成数值,比如独热编码;把不同量纲的特征归一化到统一范围;再做特征工程,把原始字段加工成模型好消化的形态。炼化完的油品,才有资格入炉训练。
⚠️ 常见坑:把"数据多"当成"数据好"。数量补不了偏见——带偏见的样本越多,模型学到的偏见越牢固。数据质量是天花板,算法只是逼近天花板的速度。
💡 关键直觉:数据工作的成本大头在人力不在机器。不少图像项目的预算里,标注费超过GPU租用费;省算力有各种技巧,省标注没有捷径。
二、算力:发动机与电网
算力指计算系统每秒能完成的运算量,常以浮点运算次数衡量。它分两种负载:训练是造发动机——把模型从随机参数喂到可用,吃算力最狠;推理是开着发动机上路——每次响应都在做计算,考验的是延迟与能效比。两种负载对硬件的要求不同,这也是硬件分化的根源。
| 硬件 | 擅长 | 在AI中的角色 |
|---|---|---|
| CPU | 串行逻辑、任务调度 | 数据预处理、流程控制 |
| GPU | 大规模并行、矩阵运算 | 深度学习训练主力 |
| TPU | 张量运算专用加速 | 大规模训练与推理 |
| NPU | 神经网络算子 | 手机等边缘设备的端侧推理 |
GPU 的胜出值得单独讲清楚,因为它最能说明"历史压力塑造技术选型"。神经网络训练的内核是海量矩阵乘法——上亿参数反复相乘再累加,彼此高度独立。CPU 是几个复杂大核,擅长把单线程逻辑跑快;GPU 则是数千个精简小核,天然吞下"简单运算乘以海量重复"的负载。这套架构本是为游戏图形渲染设计的,碰上神经网络的计算形状,严丝合缝——2012 年 AlexNet 的引爆(见 1.2 节)正是踩中了这个巧合。再往后是专用化:谷歌为自家机器学习负载定制的 TPU 在张量运算上效率更高;手机里的 NPU 负责人脸解锁、照片增强这类端侧任务;可编程的 FPGA 则适合算法频繁变化的定制场景。
单机算力终究有限,于是出现了两层放大。云计算让团队按小时租用GPU集群,不必自建机房——像工厂从自备发电机改成买电网的电,短期实验尤其划算。分布式计算把一个大训练拆到成百上千块GPU上并行:训练今天的大语言模型,动辄需要数千块GPU连续跑数周,这不是任何单机能够企及的规模。
算力即成本,于是有了真实的工程取舍。什么时候租、什么时候自建?实验密集、负载波动大就租云上算力,长期稳定的大负载自建集群摊薄成本。训练与推理怎么摆?训练堆在大集群,推理则尽量下沉到边缘设备——既省带宽又降延迟,还顺手保住了数据隐私。电费也是账本上的一栏:大型模型一次训练的耗电相当可观,能效比已经从环保话题变成了经济话题。
三、算法:把燃料变成动力的热力学
有了燃料和发动机,还需要一套决定"能量如何被组织利用"的原理,这就是算法。它规定模型如何从数据中调整自身参数、如何推理、如何决策——是三块基石里最像"图纸"的一块。
按学习方式,主流算法分三条路线。监督学习拿着带标准答案的样本学映射:分类任务把邮件分成垃圾与正常,回归任务预测房价的连续数值,代表算法有决策树、支持向量机。无监督学习在没有答案的数据里找结构:聚类算法 K-Means 把相似客户自动分组,降维方法 PCA 在压缩特征的同时保住关键信息。强化学习不给标准答案,只给延迟的奖励信号:智能体在试错中学策略,AlphaGo 是这条路线的招牌。深度学习则是横跨三条路线的方法族——用多层神经网络自动学特征,卷积网络 CNN 管图像,循环网络 RNN 与 LSTM 管序列,Transformer 靠自注意力并行处理序列,是 GPT 系列等大模型的地基。
模型从图纸到上路,要走一条迭代流水线:定义问题、准备数据、选择模型、训练、评估、调优、部署。线性走完是理想情况,现实里每一步都可能折返——评估不达标就回去换特征、调超参数、换模型,绕两三圈是家常便饭。常用调优手段包括:把多个模型的预测做集成、用正则化压过拟合、选择合适的优化器(从经典的 SGD 到自适应的 Adam)、调整学习率与批次大小这些超参数。
注意这张图是带回路的:线上服务产生的数据会回流成新的训练原料。这个细节看似不起眼,却是下一节"复利循环"的机关所在。
四、协同与放大:短板效应与复利循环
三块基石不是并列的三根柱子,而是一台互相咬合的机器。数据喂养算法——没有样本,再好的规则也无从归纳;算力支撑算法——没有并行计算,训练大型网络的时间要以年计;算法反过来滋养前两者——迁移学习让新任务少用大量数据,剪枝与量化让模型推理时少吃算力。三者互相放大,任何一块的升级都会抬高另外两块的价值。
图:三大基石协同示意图
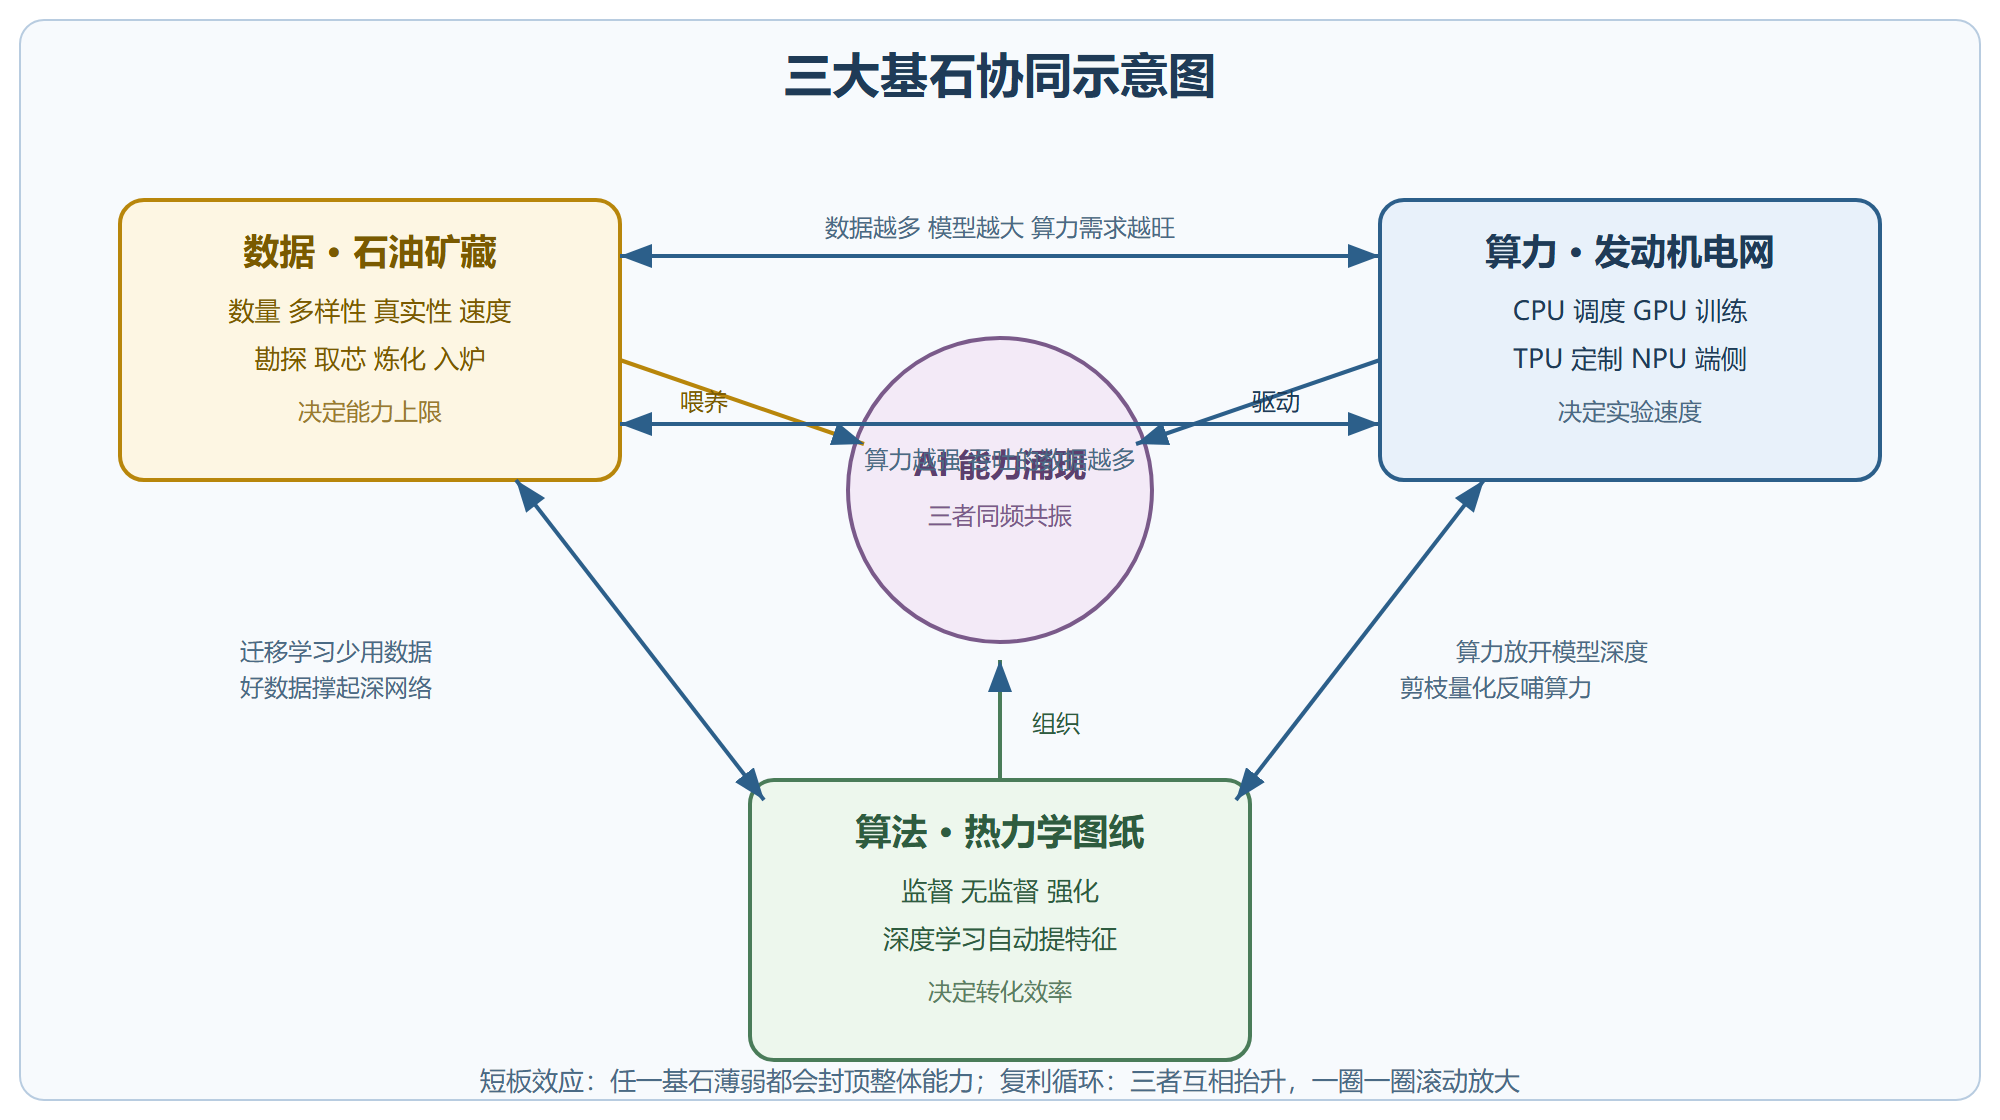
协同的另一面是短板效应。三块基石像三块围成木桶的板,水位由最短的那块决定:数据脏,算法再新也是精确地学错;算力紧,模型只能缩水到实验品;算法旧,海量数据与机房只产出平庸的拟合。一个常见的实战误判是把资源全押在追新算法上——开源生态里好算法人人可得,真正独家的是数据与场景。我的优先级排序因此很朴素:先补数据质量,再谈算力预算,最后才轮到算法选型。
三者的咬合还会产生复利循环:更好的模型带来更好的产品体验,体验带来更多用户与行为数据,数据又训练出更好的模型。回看 1.2 节的第三次浪潮能续航十余年,靠的正是这个飞轮——它不依赖任何单点突破,而是三块基石互相抬升的滚动效应。反过来说,判断一家公司的AI壁垒,与其看它发布了什么模型,不如看它的数据回路转没转起来:回路在转,雪球只会越滚越大;回路没转,再亮的模型也只是租来的发动机。
本节速览
- 数据是石油:三类数据各有矿脉;数量、多样性、真实性、速度四特征决定品位;标注如钻井取芯,最贵但不能省。
- 质量是天花板:算法只决定逼近天花板的速度,偏见进则偏见出;数据预算的大头常常是人力而非机器。
- 算力是发动机:CPU 调度、GPU 训练、TPU 定制、NPU 端侧各司其职;训练与推理是两种负载,取舍不同。
- 云是电网:租用模式把算力变成公共设施,分布式支撑数千GPU周级的训练;实验波动大就租,长期稳定就自建。
- 算法是热力学:监督学映射、无监督找结构、强化学策略;深度学习把特征提取也交给机器;流水线带回环,调优是常态。
- 短板效应:失败的项目多数缺的不是算法,而是数据与算力;优先补数据,其次算力,最后才是追新模型。
- 复利循环:模型、产品、数据互相抬升的飞轮,是第三次浪潮续航十余年的真正燃料。
过渡引语:第 1 章到此收官。带着定义、历史、分级与基石这四张底图,下一章我们走进机器学习的车间,看第一台"从数据里学规则"的机器究竟是怎么造出来的。