2.1 机器学习概述:定义、范式与流程
2.1 机器学习概述:定义、范式与流程
本节摘要:机器学习是让人工智能系统从经验(数据)中学习规律、并在特定任务上持续提升性能的方法论,它接替了"把知识一条条写成规则"的旧路线。本节先交代这场范式转移的历史动因——专家系统撞上的知识获取瓶颈;再按"谁来当老师"把学习方式划分为监督学习、无监督学习、半监督学习与强化学习四种范式;最后走完从问题定义到部署监控的完整工作流程,并逐环节标注易错点。关键词:知识获取瓶颈、范式转移、标签、泛化、特征工程、闭环。
核心问题
- 能说出机器学习与传统编程在"知识来源"上的根本差异,并复述知识获取瓶颈的含义;
- 能按监督信号的不同,把一个具体应用归入四种范式之一,并讲出归类理由;
- 能按顺序描述机器学习工作流程的主要环节,指出每个环节的常见翻车点;
- 能解释训练集、验证集、测试集的分工,说明"测试集只用一次"的原因。
一、被规则逼出来的转向:从写知识到喂数据
"知识获取瓶颈",这个带着诊断书气息的行话,是知识工程界自己发明的。上世纪七八十年代,专家系统是人工智能的旗舰:工程师访谈领域专家,把他们的经验翻译成一条条"如果……那么……"的规则,医学诊断、设备选型都靠这台规则引擎推理。起初它确实灵光,可规则库一过几百条,麻烦就来了——规则之间开始互相打架,新规则要跟旧规则逐一核对,专家脑子里的直觉又远比他们能说出来的多。写规则的速度,追不上世界变化的速度。八十年代末行业寒冬降临,压垮骆驼的稻草里,就有这根写不完的规则。
有趣的是,出路早已埋伏在门外。1959 年,阿瑟·塞缪尔在开发跳棋程序时提出了"机器学习"这个说法:不给机器显式编写规则,而是让它在大量对局中自己积累经验,胜率一路提高。这条路线沉寂了几十年,直到计算能力和数据量同时到位,才成为主航道。今天教科书里那句标准定义——机器学习是研究如何利用经验改善系统在特定任务上的性能的方法——本质上就是把塞缪尔的做法理论化了:经验是数据,任务是预测或决策,性能要用指标度量。
拿一个对比例子看得更清楚。要用传统编程识别照片里的猫,程序员得写下关于耳朵形状、眼睛颜色、胡须数量的判断语句,一条条枚举。猫换了个姿势、照片换了个光线,规则就开始漏判,维护成本雪崩。机器学习换了个问法:给我们几千张标注过"是猫"或"不是猫"的照片,让算法自己从像素统计中提炼判据。规则不再由人手写,而是从数据中"长"出来。
两条路线的差别不在聪明程度,而在知识放哪里:前者放进代码,后者放进参数。用地质勘探的话说,规则路线是手绘地图,画到哪算哪;数据路线是物探普查,矿藏有多大、品位如何,让测量结果说话。数据就是矿藏,这个比喻我们后面会反复使用。
问题:机器学习和统计学是不是一回事?
不是,但血缘很近。统计学提供了回归、假设检验、偏差分解这些理论工具,机器学习则把这些工具工程化:面对海量数据、高维特征和在线更新的需求,它更关心"在新数据上还准不准",也就是泛化能力,而不只是"对这批样本拟合得好不好"。可以说机器学习是统计思想在工业管线上的放大器,两者一个偏解释、一个偏预测,各有各的用武之地。
💡 关键直觉:机器学习不是让机器变聪明,而是把"找规律"这件事外包给数据。人提供问题和数据,规律由数据交代。
二、四种学习范式:按"谁来当老师"分家
范式这个听着吓人的词,落到机器学习里只需要问一句:训练时谁来当老师?答案不同,门派立现。
监督学习的老师是标签。训练数据里每个样本都配好了标准答案:这封邮件是不是垃圾邮件、这张手写图片是数字几、这套房子成交价多少。模型反复拿自己的预测与标准答案对照,按误差修正参数。它像跟着有答案的练习册刷题,是目前工业化程度最高的范式。预测离散类别叫分类,预测连续数值叫回归,下一节细讲。
无监督学习的老师缺席。数据只有特征、没有答案,模型的任务是发现数据自身的结构:哪些客户行为相似(聚类)、哪些特征其实是同一件事的多种说法(降维)、哪些商品总被一起买走(关联规则)。经典的购物篮分析发现"买牛奶的人也经常买面包",靠的正是 Apriori 这类关联规则算法,而不是任何人事先写好的规则。这类知识不是没人知道,而是没人说得清——它藏在数据里,等人来挖。
半监督学习介于两者之间:少量带标签数据加海量无标签数据一起训练。它的存在本身就是一条经济学注释——标签贵,无标签数据几乎免费。互联网上的图片漫山遍野,可让医学专家逐张标注病灶,每一条都要消耗宝贵的专业时间。
强化学习的老师既不给答案也不讲结构,只给奖励。智能体在环境里行动,环境回一个分数,好则鼓励、坏则惩罚,智能体靠反复试错学会让长期得分最大的策略。AlphaGo 下围棋是它的招牌应用:没有哪一步是"标准答案",只有最终胜负这个延迟的评分。
四种范式的对照见下表:
| 范式 | 谁来当老师 | 数据形态 | 典型任务 | 代表算法 |
|---|---|---|---|---|
| 监督学习 | 标签 | 输入与答案成对 | 分类、回归 | 线性回归、逻辑回归、SVM、决策树、随机森林、KNN |
| 无监督学习 | 没有老师 | 只有特征 | 聚类、降维、关联规则 | K 均值、层次聚类、DBSCAN、PCA、Apriori |
| 半监督学习 | 稀缺的标签 | 少量标签加海量无标签 | 伪标签训练 | 自训练、协同训练、图半监督 |
| 强化学习 | 奖励信号 | 状态、动作、奖励序列 | 序贯决策 | Q 学习、SARSA、DQN、策略梯度 |
⚠️ 常见坑:按算法名气选范式,而不是按手里的监督信号选。标签只有一千条却硬上监督学习,或者明明拿得到标签却用聚类凑合,都是把方向盘交给了习惯而不是现实。范式由数据决定,算法才有取舍余地。
💡 关键直觉:标签是稀缺资源。四种范式的分家史,本质上是一部"如何应对标签短缺"的历史——全有走监督,全无走无监督,有一点走半监督,干脆换成奖励就走强化。
三、一条流水线走完:基本流程与易错点
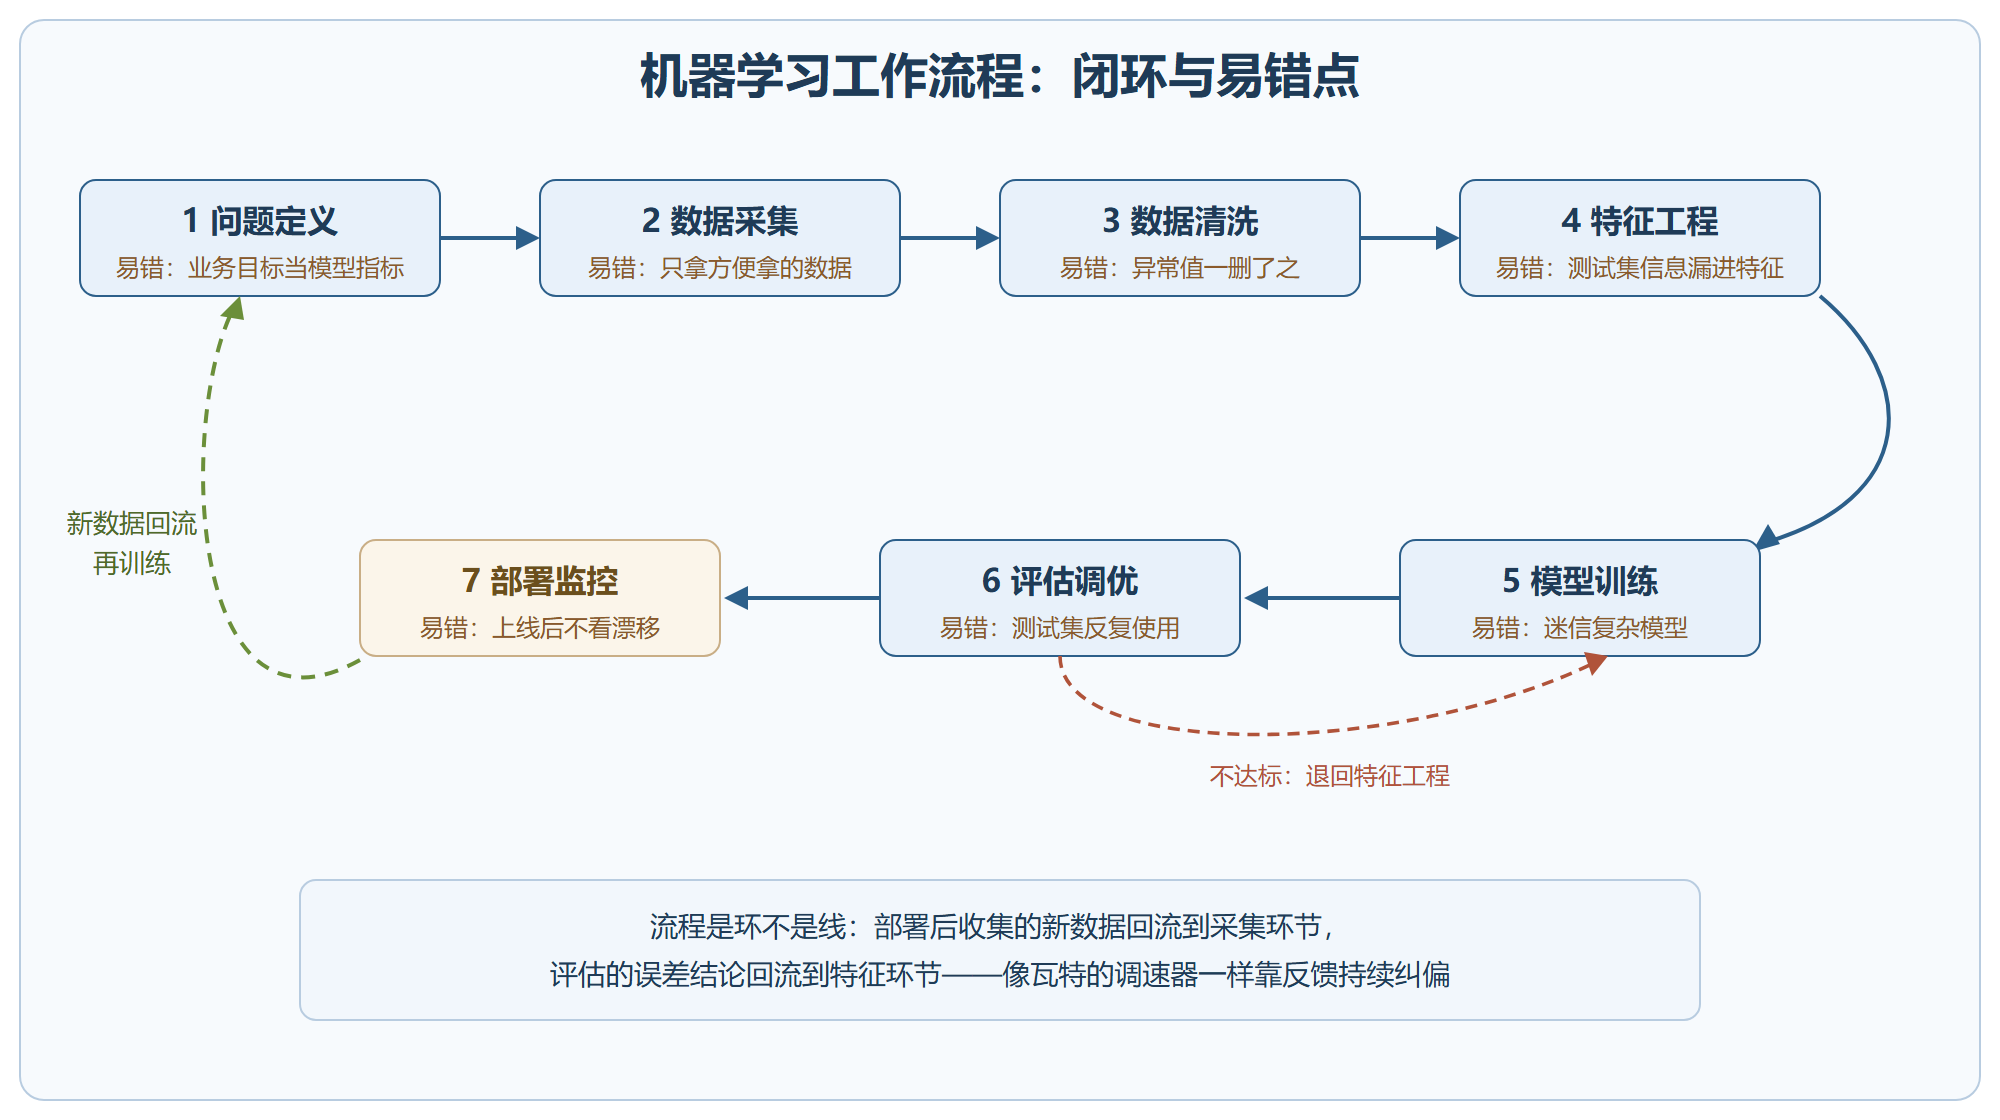
范式选定之后,真正的工作才开始。一个机器学习项目走完一轮,大致要经过下面这条流水线。请注意,它是环而不是线——部署之后的数据会回流,喂养下一轮训练。
问题定义是整条流水线最便宜也最贵的一步。便宜在它只花时间讨论,贵在定义错了后面全错。"降低客户流失率"是业务目标,落到模型上要翻译成"预测哪些客户未来三个月会流失"这样的可量化任务,并约定成功标准——比如准确率达到某个水平、召回覆盖到某种程度。跳过这步直接调参的人,往往最后做出一个指标漂亮却没人用的模型。
数据收集与准备是流水线上最耗时的工序。来源可以是数据库、传感器、网页抓取,但要守合法与隐私的边界。拿回来的原始数据几乎必然是脏的:缺失值要填充或删除,均值、中位数、众数都是常用的填充口径;异常值要识别后决定删是留;重复记录要去重;类型要统一。之后还常做标准化(把各特征拉到均值为零、标准差为一)或归一化(压进零到一区间),免得量纲大的特征在距离计算里一言堂。
特征工程是把矿石变成精矿的选矿环节。从原始数据中提取、挑选、构造对预测有用的特征:从日期里拆出年份、月份、星期几;把身高体重组合成身体质量指数这一类复合指标;类别变量用独热编码转成数值;文本则可借助词嵌入变成向量。特征选择本身也有三路打法——过滤法按相关系数或卡方检验等统计量筛,包裹法用递归特征消除这类"试了再说"的策略筛,嵌入法让 Lasso 回归在训练中顺手把没用的特征权重压到零。三路各有代价:过滤法快但粗糙,包裹法准但昂贵,嵌入法居中。
数据到这里还要切分成三份:训练集供模型学习参数,验证集供超参数调优与模型比选,测试集只在收官时使用一次。测试集之所以只能用一次,是因为每用它评估一次,我们就多知道一点关于它的信息,下一次决策就不可避免地受它影响——它悄悄变成了又一个训练集,泛化能力的测量也就失真了。
模型选择与训练反而常常是流水线里最省心的一步。简单模型如逻辑回归、决策树可解释性好,复杂模型如集成学习、神经网络通常精度更高但难解释;先拿简单模型立基线,再逐步升级,是工程上的常规打法。训练就是用优化算法(最常见的是梯度下降)反复调整模型参数,把预测误差往低处推。
评估与调优的完整指标体系放在 2.5 节展开,这里只强调一句:评估结论要能反哺前面环节。误差分析发现哪类样本错得多,常常暴露的是特征没做够,而不是模型不够复杂。
部署与监控是把模型接入真实世界:可以封装成接口供其他系统调用,也可以塞进手机、传感器这类边缘设备。上线不是终点。输入数据的统计特性会漂移,业务含义本身也会漂移(比如疫情前后"正常消费"的定义变了),两者都会让模型悄悄变钝。所以要有日志、有报警、有 A/B 测试来比对新旧模型的真实效果,还要对模型、数据、代码做版本控制,保证任何一次上线都能追溯、能回滚。新数据回流之后,定期再训练,环就闭合了。
图:机器学习工作流程闭环与各环节易错点
⚠️ 常见坑:让测试集提前"见光"。做特征工程时用了全量数据的统计量、调参时反复在测试集上比选、上线前又拿测试集验收——每一次都在泄露未来的信息。守规矩的做法是先把测试集锁进抽屉,一切决策只依赖训练集与验证集。
💡 关键直觉:部署不是终点,而是数据回流的起点。工业化从来不是一次成型,蒸汽机从纽科门到瓦特用了几十年迭代;模型也一样,靠监控、回流、再训练的循环慢慢变好。
本章回顾
- 知识获取瓶颈是范式转移的导火索:规则越写越多、越改越乱,逼着人工智能把知识来源从人写的规则换成数据中的规律。
- 机器学习的定义落在三个词上:用经验(数据)改善系统在特定任务上的性能,核心考核指标是泛化能力而非记忆能力。
- 传统编程与机器学习的分界在知识存放处:一个放进代码,一个放进参数;识别猫的例子说明,手写规则的维护成本会雪崩。
- 四种范式按老师划分:标签、无老师、稀缺标签、奖励,分别对应监督、无监督、半监督、强化学习。
- 特征工程是选矿:日期拆解、指标合成、独热编码、词嵌入都是把原始数据炼成可用特征的手段;特征选择有过滤、包裹、嵌入三路。
- 三集分工要守纪律:训练集学参数,验证集调超参,测试集只用于最终检验,且只许用一次。
- 流程是闭环:问题定义、数据、特征、训练、评估、部署、监控、回流,环上的每一站都有自己的易错点,图中的红字就是事故高发区。
范式的地图已经铺开,接下来先走最宽的那条大道——有老师带的监督学习。答案都标好了,模型能学到什么程度?