第3章 · 数据探索与可视化加速
第 3 章 · 数据探索与可视化加速
章节摘要:数据分析 Notebook 的价值在「加载 → 摸底 → 清洗 → 出图」闭环速度。本章按 SOURCE 第 3 章压缩为三节:Pandas/Dask 加载与 head/info/describe、缺失值与类型转换、matplotlib/seaborn 及 plotly 交互图——并强调 %matplotlib inline 与图表性能取舍。
本节目标
阅读完本章,你应当能够:
- 用 read_csv/read_excel 加载并用 head/info/describe/dtypes 摸底
- 大数据用 Dask read_csv + compute() 延迟计算
- 处理缺失值、类型转换与简单特征工程
- 用 matplotlib/seaborn 做静态图,了解 plotly 交互场景
- 用 %timeit 对比循环与向量化清洗写法
核心概念速览
金句:探索性分析的目标是「快速形成假设」,不是「一次写完美 pipeline」——Notebook 适合前几轮 EDA。
子章节导航
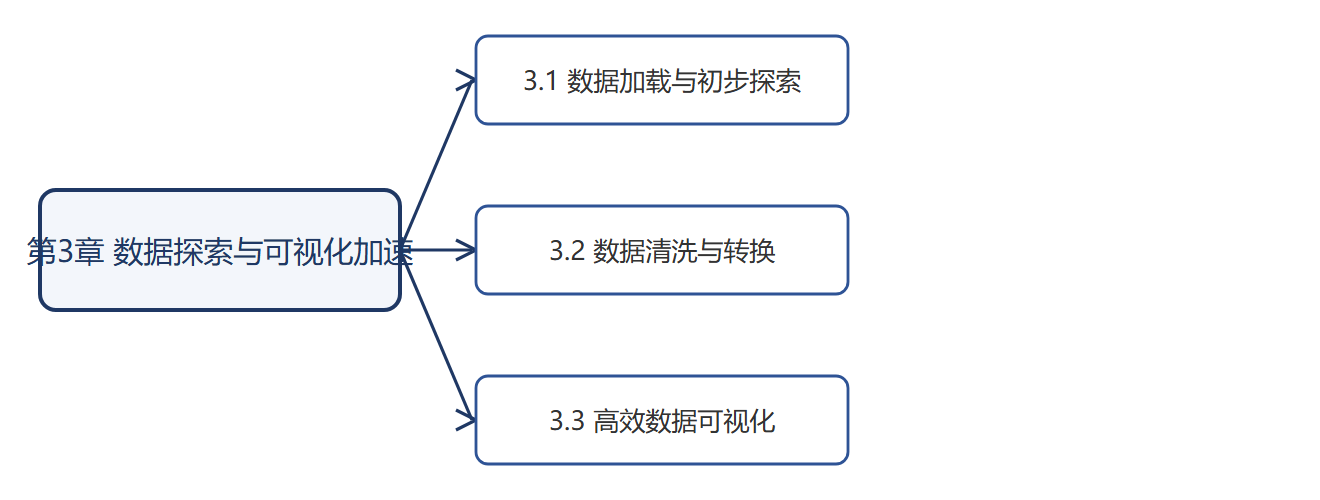
3.1 数据加载与初步探索
Pandas 多格式读取、Dask 大表、isnull/unique/hist 初探。
3.2 数据清洗与转换
dropna/fillna、to_numeric/to_datetime、map/replace 与简单衍生列。
3.3 高效数据可视化
%matplotlib inline、seaborn 统计图、plotly 交互、Mermaid 报告结构。
子章节之间的逻辑关系
加载摸底 → 清洗可分析 → 可视化验证假设 → 第4章导出分享
没摸清 dtypes 就画图,容易把字符串当数值;没处理缺失就拟合,模型 silently wrong。
前置知识与后续延伸
- 前置:第 1–2 章内核与 Magic(%timeit、%matplotlib inline)
- 为后续铺垫:第 4 章 nbconvert 导出 HTML/PDF;第 5 章 Dask 与内存 downcast 深化
本章学习建议
本章从"数据能不能信"开始:3.1 用 read_csv 把数据拉进来,head/info/describe 三件套做摸底,列级扫描看缺失与类型;3.2 针对发现的问题做清洗,先判断删除还是填充,再统一类型、统一标签;3.3 把清洗结果画出来验证假设,静态图用 matplotlib/seaborn,交互场景用 plotly。建议拿一份自己熟悉的真实数据(比如销售流水、日志表)从头到尾走一遍:先记录三个"发现",再做清洗,最后画三张图形成一个小报告。真实数据上你会遇到 encoding、日期解析、缺失值这些教材里容易跳过的坑,踩一遍比背十遍函数名有用。
本章结构图
本章常见弯路提醒
本章最容易走的三条弯路:一是拿到数据立刻建模,跳过 head/info/describe 摸底,后期被类型和缺失问题反复返工;二是全程只用一个 read_csv 参数,遇到中文乱码、日期错乱才回头补 encoding 和 parse_dates;三是画图贪多,一张图没看懂就急着画下一张。走完本章后,请建立最小习惯:读文件必先看 dtypes 与缺失,动手清洗前先写 schema 表,画图前先想清楚这张图回答什么问题。