3.1 数据加载与初步探索
3.1 数据加载与初步探索
本节摘要:SOURCE 3.1 以 Pandas read_csv/read_excel 为主线,配合 head/info/describe 三角摸底;超大 CSV 用 Dask read_csv + compute()。本节保留原文代码路径,并补充 dtypes、isnull、unique 与 hist 初探清单。
本节导航
阅读完本节,你应当能够:
- 用 pd.read_csv/read_excel 加载并检查 shape
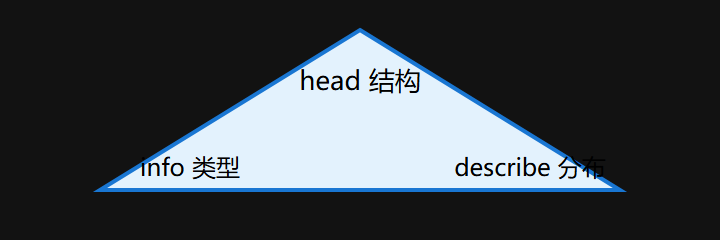
- 解释 head/info/describe 各自回答什么问题
- 用 Dask 延迟加载超出内存的 CSV
- 用 dtypes、isnull().sum()、unique() 做列级扫描
一、Pandas 标准加载
SOURCE 示例:
import pandas as pd df = pd.read_csv("data.csv") # df = pd.read_excel("data.xlsx") print(df.head()) print(df.info()) print(df.describe())
| 方法 | 回答的问题 |
|---|---|
| head() | 长什么样、分隔是否正确 |
| info() | 行数、非空数、dtype、内存 |
| describe() | 数值列分布(计数/均值/分位) |
读 JSON/SQL 时 SOURCE 亦提及 read_json、read_sql_query——Notebook 里先 %pwd 确认工作目录,再 read,避免 FileNotFoundError。
二、Dask 处理大文件
SOURCE:Pandas 全量进内存会爆;Dask 分块并行:
import dask.dataframe as dd ddf = dd.read_csv("large_data.csv") print(ddf.head()) print(ddf.describe().compute())
.compute() 触发实际计算——探索阶段只对 head/describe 等聚合调用 compute,别对整个大表无脑 materialize。
三、初步探索技巧(SOURCE 3.1.3)
- df.dtypes:是否把日期读成 object
- df.isnull().sum():每列缺失计数
- df["col"].unique():类别取值范围
- df["col"].hist():数值分布
- df.plot.scatter(x="col1", y="col2"):两变量关系
首屏 Markdown 格记录「发现」:如「age 有 3% 缺失」「category 有未知级别 UNKNOWN」——给清洗节交接。
EDA 三角:head / info / describe
四、read_csv 常用参数
SOURCE 虽未逐条列参,工程上常一起设:
| 参数 | 用途 |
|---|---|
| encoding | 中文 CSV 试 utf-8-sig/gbk |
| parse_dates | 直接解析日期列 |
| dtype | 预指定类型省内存 |
| nrows | 仅读前 N 行试 schema |
⚠️ 常见坑:Excel 日期序列被读成 float——用 parse_dates 或 read_excel 的 date_parser。
💡 关键直觉:EDA 前 5 分钟只回答「数据能不能信」——行数、缺失、类型、明显离群,别急着建模。
一节小结
- head/info/describe:结构、完整性、分布
- Dask + compute:大文件分块
- dtypes / isnull / unique / hist:列级扫描
- parse_dates / dtype:读入时少踩坑
- Markdown 记录发现:衔接清洗节
下一节 3.2 数据清洗与转换 处理 missing 与类型。
实战:一份带小数的销售表怎么读
import pandas as pd df = pd.read_csv( "sales_2024.csv", encoding="utf-8-sig", # 中文表头常见 parse_dates=["order_date"], dtype={"store_id": "str"}, # 门店编号保留前导零 ) print(df.shape) print(df.head(3))
读入后建议按固定顺序检查四件事:
- shape:行数是否符合预期,防止读到空白表。
- dtypes:order_date 是否变成 datetime64,store_id 是否被误读成数字。
- isnull().sum():哪些列有缺失,缺失比例是否可接受。
- head(5):表头与分隔是否正确,字符串列是否夹带空格。
列级扫描清单
# 类别列的取值全景 for col in df.select_dtypes(include="object").columns: print(col, df[col].unique()[:10]) # 数值列的分布速览 df.describe().T
这段代码输出两类信息:类别列的取值边界(发现拼写不一致的标签),数值列的分位数(发现极端离群)。把结果贴进 Markdown 格,作为后续清洗的交接文档。
什么时候用 Dask 而不是 Pandas
只有"单表超出内存"才值得引入 Dask。经验阈值:列数不多、行数千万级、几十 GB 时,Dask 收益明显;几百万行以内,Pandas 加 usecols 裁剪 + chunksize 通常就够。过早引入 Dask 会让简单分析变复杂,也会失去 pandas 生态里大部分第三方兼容。
与工作目录相关的两个坑
- Notebook 的
%pwd显示的是启动时的工作目录,不是文件所在目录。 pd.read_csv("data.csv")的路径相对%pwd解析,路径不对先%pwd确认,不要盲目怀疑文件不存在。
记录 schema 是探索的第一步
把列名、dtype、缺失、唯一值整理成一张表,贴到 Notebook 首部 Markdown 格,是整份分析的地图。后续每一节转换都对照这张表检查"哪列被动了、变什么类型了",能防止清洗过程悄悄丢掉字段。
schema = pd.DataFrame({ "dtype": df.dtypes, "missing": df.isnull().sum(), "n_unique": df.nunique(), }) schema
离群值的两个处理阶段
探索阶段不要急着删离群值,先标出来:df["is_outlier"] = ... 打标记。是否剔除、用什么阈值,留给建模前的决策环节。探索期的任务是把"数据里发生了什么"讲清楚,而不是提前下结论。
加载阶段的最小检查单
每次读取数据后,用下面五步快速体检,全程不超过两分钟:看 shape 是否符合预期;看 dtypes 是否把日期、编号读成 object;看缺失列与缺失比例;看类别列的取值集合是否干净;看 describe 的数值范围是否在合理区间。
把五步结果写进一个 Markdown 格,这份"体检报告"就是后续清洗与建模的基线。数据每次重读或换源时,对照基线一查就知道有没有引入新问题。
多数据源对齐的坑
同一份数据从 CSV、数据库、API 三个渠道读进来,列名大小写、时间格式、缺失标记(空字符串还是 NaN)可能都不一样。探索阶段就把三者的 schema 差异记录下来,统一列名与类型后再合并,能避免后期莫名其妙的 join 结果。
加载性能的小优化
大文件反复测试时,先 nrows=5000 读一小块验证列名与类型,确认没问题再全量读。另一个常用技巧是按需取列:usecols=["id", "price", "date"] 只读必要列,内存和读盘时间都能显著下降。这两招都不影响最终结果,只是让探索阶段更轻快。
探索结论的存档
每次数据摸底后,把"发现了什么"浓缩成三到五条写在 Markdown 格:表有多大规模、哪些列有缺失、哪些类别标签不统一、有没有明显离群。这份存档在换人接手或数月后回看时,能快速恢复上下文,远比重新跑一遍代码高效。