第一章 线性结构的进化链
第一章 · 线性结构的进化链
章节摘要:本章跟着"同一个问题、同一个数组,如何一步步变快"这条主线走——从复杂度这把标尺出发,途经哈希表、快慢指针、分治排序这些经典进化节点,让你亲眼看到线性结构上的瓶颈是如何被逐个拆掉的。
一条主线
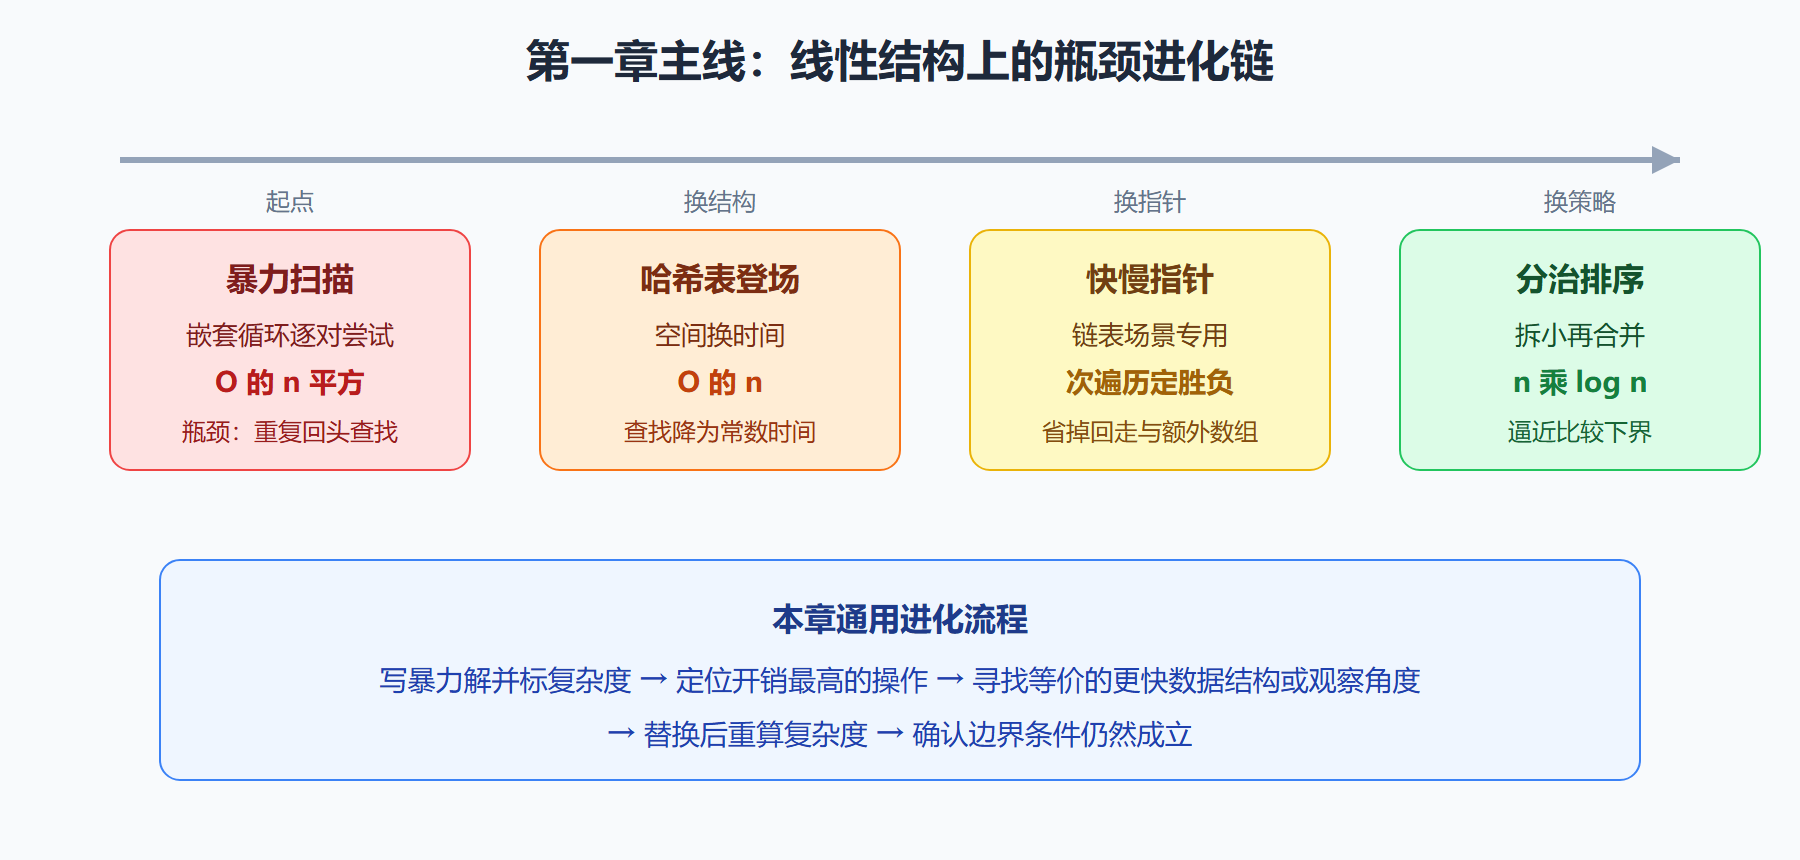
我们把整章押在一个很朴素的问题上:给你一批放在连续内存里的数据,想知道点什么,最直接的写法几乎总是"从头扫到尾"。这个写法永远正确,也永远最慢。本章要做的就是反复追问:扫描慢在哪一步?那一步能不能不扫?沿着这个追问,我们先后请出几件武器——先学会用大 O 记号把"慢"量化(复杂度分析),再用哈希表把"查找"从线性扫描降为常数时间(两数之和),然后处理链表这种"不能随机访问"的退化场景(快慢指针、原地反转),最后面对排序这个古老问题,看看人类如何从平方级的交换思路一路进化到线性对数级的分治思路,并撞上"基于比较的排序不可能更快"的理论下界。
这条主线的妙处在于:武器不同,剧情却相同。每一次进化都由同样的三段式构成——先有暴力解并算清它的开销,再定位开销中重复最多的那个操作,最后用一种数据结构或观察角度把重复消灭。你会看到,哈希表消灭的是"重复查找",快慢指针消灭的是"重复回走",分治消灭的是"重复比较无序全量"。掌握剧情模板,比记住任何一个具体解法都值钱。
沿途站点
本章设四站。第一站是复杂度分析:学会用大 O 记号描述时间与空间开销,理解最好、最坏、均摊三种情形,掌握常见复杂度从常数、对数、线性、线性对数到平方、指数的直观排序——这是全章乃至全册的度量衡,没有它后面所有"快了多少"都无从谈起。第二站走进两数之和:从嵌套循环的平方级暴力解出发,定位"每次都要回头找配对"这个瓶颈,引入哈希表把查找降到常数时间,顺便体会"空间换时间"这笔交易的计价方式。第三站处理链表:它没有随机访问能力,数组上的技巧全部失效,于是进化出快慢指针找中点、判环,以及一次遍历完成原地反转的手法。最后一站是排序:沿着冒泡、选择、插入的平方级起点,进化到归并、快排的线性对数级,再认识计数、桶这类打破比较下界的非比较排序,理解每种排序的适用边界。
四站之间有严格的依赖:不会算复杂度,就看不出哈希表省了什么;不熟悉数组的扫描方式,就理解不了链表为何要靠快慢指针;而排序一节是第二章分治思想的预热——归并排序本身就是"递归加合并"的教科书案例。
拐点与结论
本章最大的认知拐点藏在两数之和里:优化未必来自更聪明的算法,有时只来自换一种数据结构。暴力解的算法逻辑无可挑剔,慢仅仅因为"查找"这个底层操作不够快;把顺序查找换成哈希查找,算法骨架未动,复杂度却完成了从平方到线性的跃迁。第个拐点在排序下界:进化不是无限的,基于比较的排序存在线性对数级的天花板,想突破它必须放弃"比较"这个前提改走计数、桶的路线。认清"哪些瓶颈可消除、哪些是理论下界",你在面试中就不会说出"我还能再优化"这种空话,而是给出有依据的判断。
本章的最终落点可以浓缩成句操作指南:拿到题先写暴力解并标出复杂度;找出开销最高的那个操作;问自己"这个操作有没有更快的等价数据结构";有则替换并重新算账,没有则考虑改变算法前提。本章所有案例都严格走了这套流程。
读完你应该
- 给任意段代码标注时间复杂度与空间复杂度,并区分最好、最坏、均摊情形;
- 独立写出两数之和的哈希表解法,说清它比暴力解快在哪步操作上、代价是什么;
- 用快慢指针在次遍历内完成链表中点查找、环检测,并能写出原地反转链表的迭代代码;
- 手写归并排序并解释其稳定、线性对数级的原因;说出快排在已序输入上退化的原因与随机化对策;
- 面对陌生题目时,习惯性地先给出暴力解,再按本章的流程模板寻找优化点。
下一章的接力
本章的优化大多发生在"数据的组织方式"上:换个结构,同一个算法立刻提速。下一章把视角翻转——数据结构不动,让算法策略本身进化:递归教我们优雅地拆解问题,动态规划把指数级递归驯服成线性递推,回溯在庞大的解空间里学会剪枝,双指针则把"次遍历能解决的事绝不扫两遍"推向极致。如果说本章优化的是"放在哪",下一章优化的是"怎么想";排序一节埋下的分治伏笔,也将在归并排序与递归的关系中正式揭晓。
本章主线结构示意