复杂度分析:从能跑到跑得快
1.1 复杂度分析:从能跑到跑得快
本节摘要:复杂度分析是整本算法教程的度量衡。本节讲清大 O 记号到底在数什么、为什么常数和低阶项可以被忽略、最好最坏均摊三种情形怎么区分,并给出常见复杂度的直观速度排序与"每秒亿级运算"的换算口诀——它是后续每条进化链上判断"快了多少"的唯一依据。
学习目标
读完本节,你应当能够:给一段任意结构的代码标注时间复杂度与空间复杂度;解释大 O 记号忽略常数与低阶项的理由;区分最好、最坏、均摊三种分析口径并说出各自适用场景;用"一秒一亿次"的粗略换算判断某个解法能不能在限时内跑完。
一、为什么要先学度量再学优化
在全册的进化链里,本节的位置非常靠前,原因很简单:没有度量,优化就无从谈起。你写出一个新解法,说"感觉快了",面试官追问"快了多少,为什么",这时候唯一能救你的是复杂度分析。它回答的问题其实很朴素——当输入规模 n 变大时,算法的基本操作次数按什么速度增长。注意关键词是"增长速度"而不是"具体次数":我们不关心在某台机器上跑了多少毫秒,因为那取决于主频、缓存、编译器;我们关心的是 n 翻倍后耗时怎么变,这是算法本身的属性,换台机器也不会变。
大 O 记号就是这个"增长速度"的数学化。O(f(n)) 的意思是:当 n 足够大时,操作次数与 f(n) 同阶。这里有个初学者最容易别扭的地方——为什么可以忽略常数?比如两段代码分别执行 n 次和 3n 次加法,都记作 O(n)。理由是:大 O 描述的是趋势,当 n 增长到足够大,任何常数倍差距都不会改变"n 翻倍、耗时翻倍"这个定性结论;而算法选型的决策恰恰发生在 n 很大的场景。同理,n 平方加 n 加 500 一律记作 O(n 的平方),因为当 n 上万后,低阶项在总量里的占比趋近于零。
二、常见复杂度直观排个序
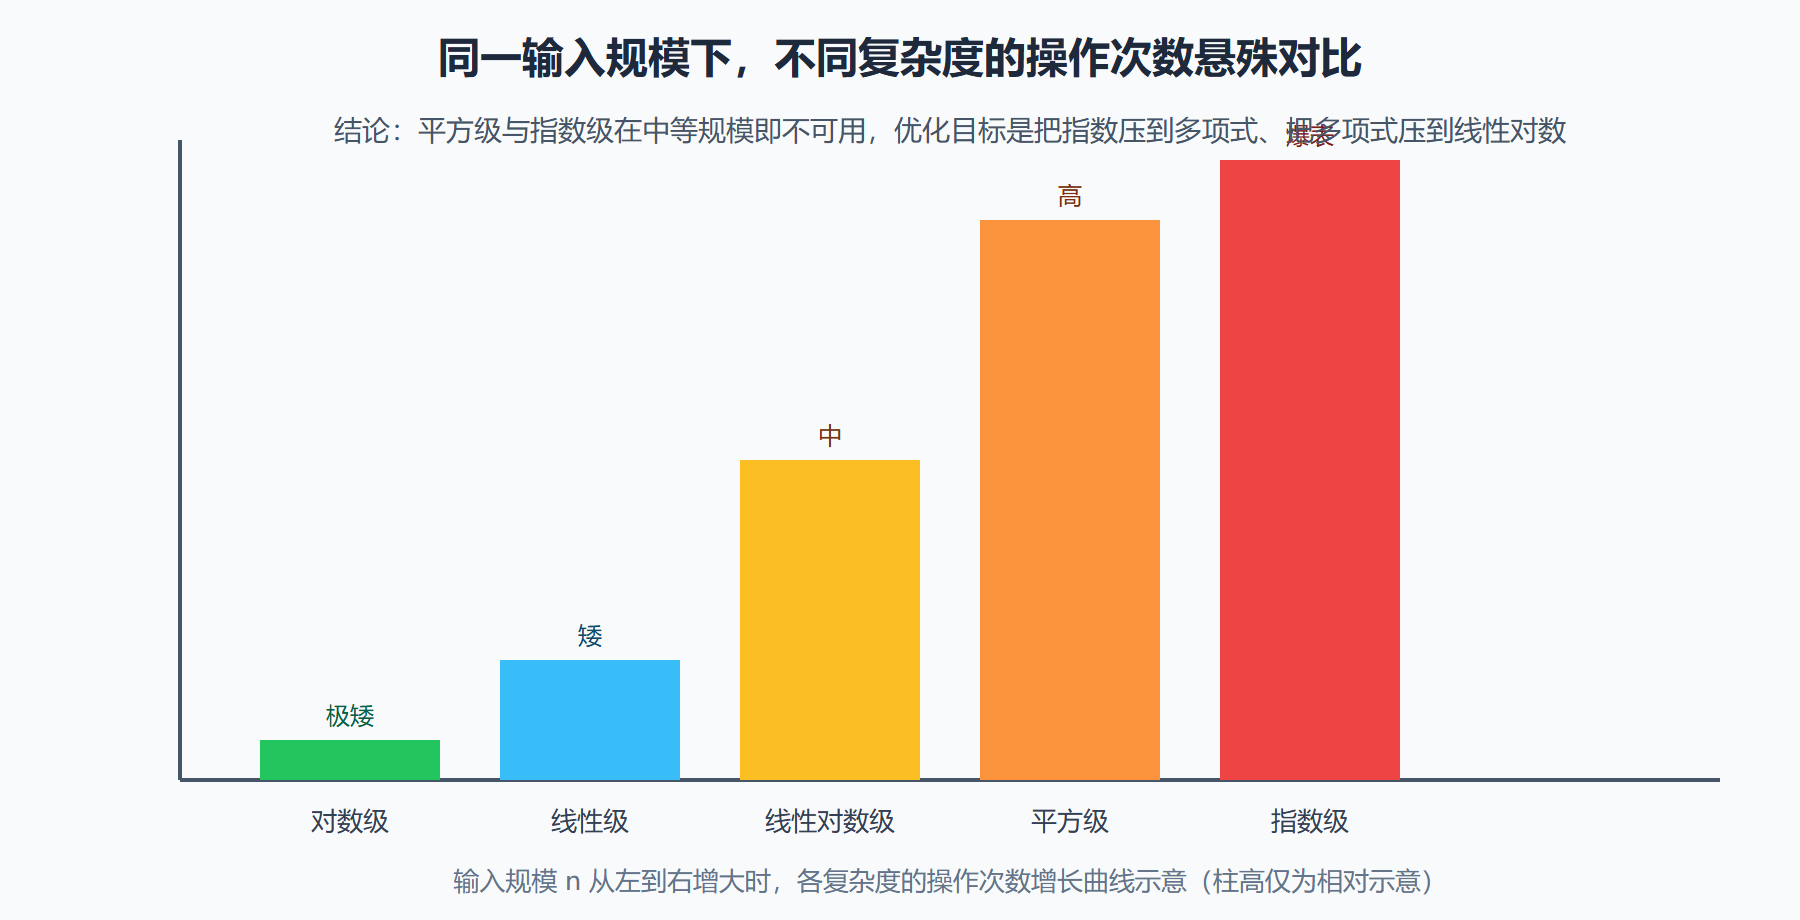
从快到慢,常见的复杂度依次是:O(1) 常数、O(log n) 对数、O(n) 线性、O(n log n) 线性对数、O(n 的平方) 平方、O(n 的立方) 立方、O(2 的 n 次方) 指数、O(n 的阶乘) 阶乘。面试中有个非常实用的换算口诀:把计算机粗略当成"一秒一亿次"基本操作。那么 n 等于一百万时——O(n) 大约零点零一秒,稳过;O(n log n) 大约零点二秒,稳过;O(n 的平方) 大约三个多小时,必挂。这道换算题几乎能直接回答"这个解法会不会超时"。
| 复杂度 | n 等于一千时 | n 等于一百万时 | 典型代表 |
|---|---|---|---|
| O(log n) | 约十次 | 约二十次 | 二分查找 |
| O(n) | 一千次 | 一百万次 | 线性扫描 |
| O(n log n) | 约一万次 | 约两千万次 | 归并排序 |
| O(n 的平方) | 一百万次 | 十的十二次方 | 嵌套循环暴力 |
| O(2 的 n 次方) | 天文数字 | 不可行 | 朴素递归斐波那契 |
还有一类容易被忽视的:O(sqrt n),根号 n,出现在"判断质数只需试除到根号 n""部分数学题的枚举范围"里,速度介于对数与线性之间。记住这张表,你就能在动手写代码之前预判生死,而不是提交超时之后才追悔莫及。
三、三个口径:最好、最坏、均摊
同一段代码在不同输入下的表现可能天差地别,所以有三种分析口径。最好情况:输入恰好让算法提前收工,比如在第一个元素就找到了目标,线性查找的最好情况是 O(1)。最坏情况:输入最刁钻时的上界,线性查找的最坏情况是 O(n)。面试中说"某算法是 O(n)"时,默认指最坏情况,这是行业惯例。均摊情况最有趣:单次操作可能很贵,但把一长串操作摊开来看,平均每次很便宜。经典案例是动态数组的追加——多数时候往末尾放元素是 O(1),偶尔容量满了要扩容搬家的那一次是 O(n),但把扩容成本摊到之前的所有追加操作上,均摊每次仍是 O(1)。另一个案例是稍后第三章会讲的并查集,它的单次查询路径可能很长,均摊下来却近乎常数。
# 三段代码,三种典型复杂度,猜猜各是多少 def find_target(nums, target): # O(n):最坏要把整个数组扫完 for x in nums: if x == target: return x return -1 def binary_search(nums, target): # O(log n):每轮砍掉一半候选 lo, hi = 0, len(nums) - 1 while lo <= hi: mid = (lo + hi) // 2 if nums[mid] == target: return mid elif nums[mid] < target: lo = mid + 1 else: hi = mid - 1 return -1 def has_duplicate(nums): # O(n 的平方):所有数对都要看一眼 n = len(nums) for i in range(n): for j in range(i + 1, n): if nums[i] == nums[j]: return True return False
标注复杂度有三条实用法则。第一,顺序执行取最大:一段 O(n) 的循环后面跟一段 O(n log n) 的排序,整体是 O(n log n)。第二,嵌套循环看乘法:外层跑 n 次、内层跑 m 次,就是 O(n 乘 m)。第三,递归看"递归调用次数乘每次的工作量":二分查找每次把问题砍半且只递归一边,是 log n 层、每层 O(1);朴素递归的斐波那契每个节点分裂成两个子问题,节点总数指数增长,就是 O(2 的 n 次方)。空间复杂度同一套逻辑,但要额外留意两个隐性来源:递归调用栈的深度也算空间,一个深度为 n 的递归即使不开数组,空间复杂度也是 O(n);而临时变量、交换用的暂存变量只要与 n 无关,就是 O(1)。
常见复杂度的增长速度对比
四、实战演练:给一道真题算账
用两数之和的暴力解做次完整练习。题目:给整数数组 nums 与目标值 target,返回和为 target 的两个下标。暴力写法是双重循环:外层固定一个数,内层扫它右边的所有数,逐对求和比对。外层跑 n 次,内层平均跑二分之 n 次,总操作量约 n 的平方的一半——按大 O 的规则,常数与系数丢掉,记 O(n 的平方)。空间上只用了几个变量,O(1)。假设 n 是一万个测试数据,按"一秒一亿次"口诀,需要大约一亿次操作的一半,也就是零点五秒左右——勉强能过。但 n 一旦升到一百万,操作量是十的十二次方的一半,几个小时都跑不完,必挂。这个"账"就是在告诉我们:暴力解有它的适用边界,超出边界就必须沿着进化链往下走。下一节我们就亲手把这道题优化到 O(n)。
做道变式巩固一下:判断回文串的函数,从头尾两个下标相向而行逐字符比对,每次比对排除两个字符,最多比对一半长度,时间 O(n)、空间 O(1)。再变式:把字符串反转后与原串比较,时间仍是 O(n),但空间变成 O(n)——多开了一份完整拷贝。你看,同样的时间复杂度下,空间开销可以完全不同,这正是面试官爱追问"空间还能不能省"的原因。
本节要点回顾
- 大 O 描述增长趋势:忽略常数与低阶项,衡量的是 n 变大后耗时按什么速度增长;
- 速度口诀:把计算机当一秒一亿次,O(n) 与 O(n log n) 在百万规模内安全,平方级一万起步危险;
- 三种口径:说复杂度默认指最坏情况,动态扩容与并查集要用均摊口径才说得清;
- 三条标注法则:顺序取最大、嵌套做乘法、递归等于层数乘每层工作量;
- 空间也要算账:递归栈深度是隐性空间,"时间相同、空间不同"的解法大有人在。
下一节我们把度量衡装上弹药:用两数之和这道最经典的题,完整走一遍"暴力解、找瓶颈、哈希表进化到 O(n)"的全程,看看空间换时间这笔交易怎么谈。