3.1 资源管理与编排
3.1 资源管理与编排
本节摘要:资源管理与编排是云上"秩序"的来源:资源管理负责"盘清、分好、盯住、回收"云资源,资源编排负责把部署与变更自动化。本节先讲资源生命周期的四个动作(盘点、分配、监控、回收),再讲基础设施即代码(IaC)与容器编排如何让环境"可重复、可审计",最后给出资源治理的实操清单,帮你摆脱"资源失控、账单失控"的常见困境。
阅读收获
阅读完本节,你应当能够:
- 说出资源管理的四个基本动作:盘点、分配、监控、回收。
- 解释基础设施即代码(IaC)如何解决"环境漂移"问题。
- 区分 IaC(管资源定义)与容器编排(管容器调度)的职责。
- 为"资源越建越多、没人知道是谁建的"这类问题开出一剂治理药方。
一、问题与直觉
云让资源创建变得太容易了——点几下就开一台机器。于是半年后,你的账号里躺着两百多台虚拟机、几十个存储桶、一堆没人记得的数据库实例。谁建的?跑什么业务?要不要留着?没人说得清。账单却一点不含糊。
这就是"资源失控"。第 2 章我们兴奋地买了各种服务,本章第一个要面对的现实是:资源的数量一旦超过人手能数的范围,就需要体系化管理。 资源管理解决"我知道我有什么",资源编排解决"我知道它怎么来的、怎么重建"。
打个比方:资源管理是仓库管理员——每件货有台账、有位置、有领用人;资源编排是自动化流水线——货物按标准流程入库出库,不靠人肉搬运。没有台账,仓库会乱;没有流水线,效率会低。
二、核心原理
2.1 资源管理的四个动作
盘点(Discover):自动发现账号里所有资源,维护元数据(类型、配置、状态、所有者、成本)。这是治理的第一步——不盘清家底,后面全是空谈。
分配(Allocate):按业务需求把资源分给合适的任务,涉及调度策略(先进先出、优先级、公平调度)、亲和性(相关任务放同节点)与反亲和性(关键任务分散到不同节点)。
监控(Monitor):实时跟踪资源使用率(CPU、内存、磁盘 IO、流量),用阈值告警发现瓶颈,用监控数据驱动动态调整(自动扩缩容、资源迁移)。
回收(Reclaim):及时回收闲置资源、清理过期数据与配置。资源回收是成本治理里性价比最高的一环——很多团队的第一笔"云省钱"就是删掉一堆闲置机器。
2.2 基础设施即代码:让环境可重复
基础设施即代码(IaC,Infrastructure as Code)把"环境配置"写成代码:虚拟机开什么规格、存储桶怎么配权限、网络怎么划,全部声明在配置文件里,用工具(如 Terraform、CloudFormation)一键应用到云上。它的三大收益:
第一,可重复。环境不再靠人肉点击创建,代码在,环境就能重建,测试环境和生产环境用同一套代码,杜绝"环境漂移"。第二,可审计。配置的每次改动都进版本控制,谁改了什么一目了然。第三,可回滚。改坏了,回退到上一个版本的配置即可。
2.3 容器编排:让容器自动化运转
容器编排(如 Kubernetes)负责容器化应用的部署、伸缩、故障恢复。它和 IaC 分工不同:IaC 管"资源定义长什么样",容器编排管"容器怎么跑起来、怎么调度、坏了怎么补"。可以把 IaC 理解为"画图纸",容器编排理解为"调度工人"。两者常常配合使用:IaC 搭出集群,Kubernetes 在集群里跑应用。
三、工程实践要点
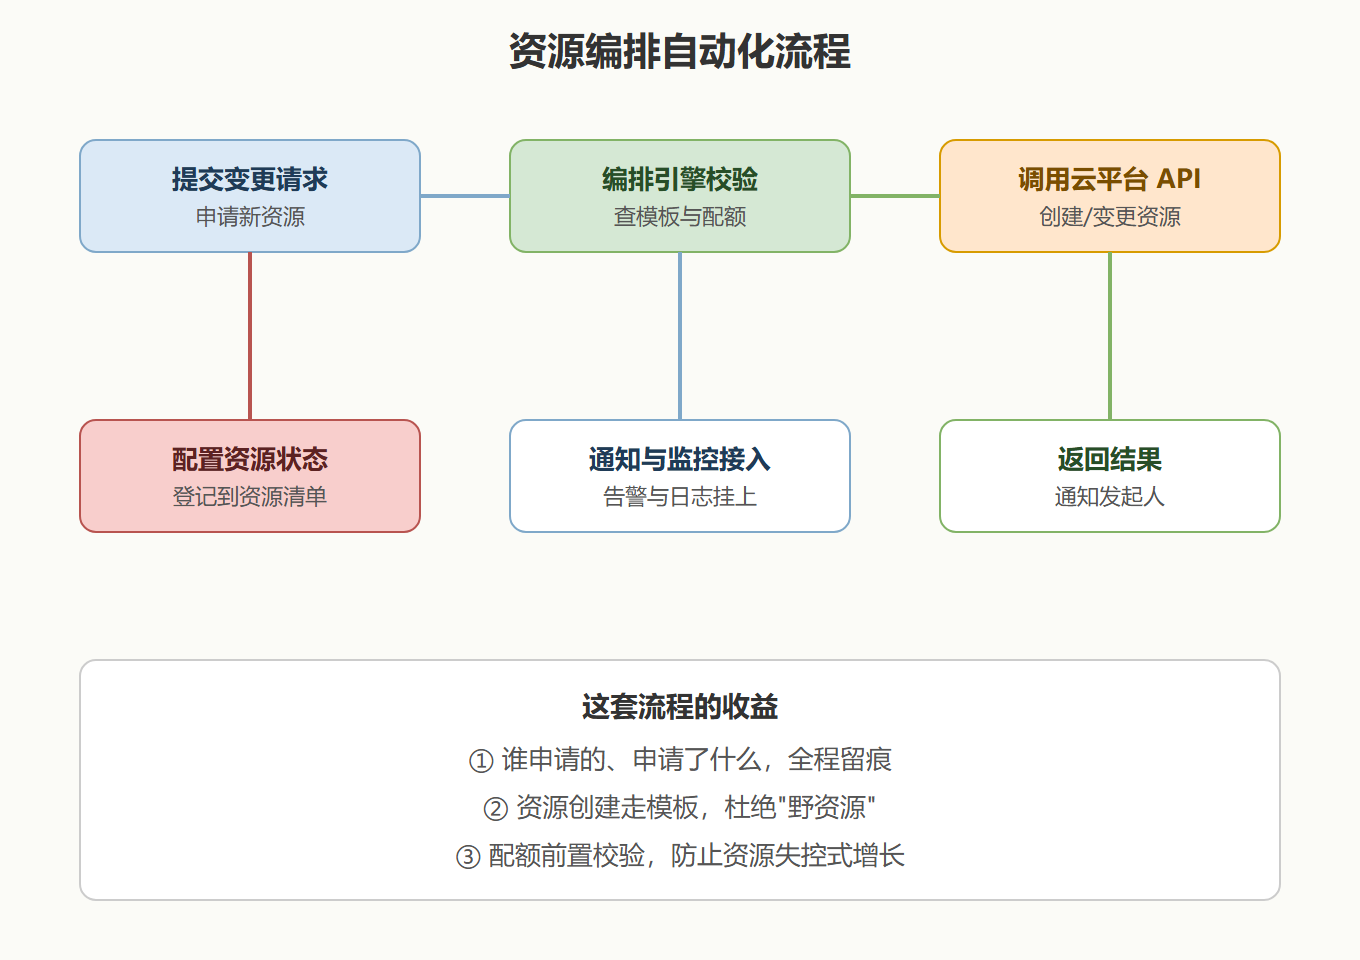
3.1 资源编排的自动化流程
3.2 资源治理实操清单
| 动作 | 具体做法 | 解决的问题 |
|---|---|---|
| 打标签 | 每类资源打上项目/环境/所有者标签 | 账单与归属对不上 |
| 配额控制 | 按项目设置资源上限 | 资源无限膨胀 |
| 闲置回收 | 定期扫描低利用率机器并下线 | 闲置资源持续扣费 |
| 环境代码化 | 测试/生产都用 IaC 声明 | 环境漂移、无法重建 |
| 权限收敛 | 资源创建权按角色收敛 | 野资源无人认领 |
⚠️ 常见坑:只做"盘点"不做"回收"。资源清单建好了却没人负责清理,家底是盘清了,账单照样涨。治理必须是"盘点—分配—监控—回收"的闭环,缺回收环节等于白盘点。
💡 关键直觉:资源管理治标,资源编排治本。真正摆脱"人肉运维"的,是把"建环境"变成"跑代码"——环境代码化的那一天,你的运维负担才开始真正下降。
3.3 编排工具的选型建议
IaC 工具选型看团队习惯:Terraform 跨云支持最好、社区最大;CloudFormation 只在 AWS 生态里强,胜在原生。容器编排基本是 Kubernetes 的天下(详见第 5.1 节)。工具之争不是重点,重点是"是否已经用代码管理环境"——哪怕先从一个存储桶、一台虚拟机开始,也比完全手工强。
四、常见问题(FAQ)
Q1:资源管理就是看控制台吗?
看控制台只是盘点的一部分。完整的资源管理包含:自动发现、元数据维护、配额与调度、监控与回收,以及贯穿其中的标签与权限治理。控制台是入口,体系才是关键。
Q2:IaC 和配置管理工具(如 Ansible)是一回事吗?
不完全一样。IaC(Terraform)管"资源的存在与定义"(创建虚拟机、开存储桶);配置管理(Ansible)管"已存在资源内部的状态"(装软件、改配置文件)。两者常配合:先用 IaC 建资源,再用配置管理工具装好里面的软件。
Q3:小团队也需要资源编排吗?
需要,但可以轻量起步。哪怕只有十几台资源,用 IaC 管理"环境定义",配合标签与配额,就能避免"环境漂移"和"资源失控"。规模小不等于可以不治理,而是治理可以更简单。
Q4:编排失败怎么办?
编排工具都支持"计划—应用"两步走,先看会改什么,再真正执行;失败则回滚到上一版本配置。配合版本控制,每一次变更都有据可查、可回退。这比手工操作的"改错了就回不去"强太多。
Q5:资源治理的投入产出划算吗?
非常划算。资源治理省下的通常不是小钱:闲置机器、超额存储、重复建的环境,每一项都是持续的账单黑洞。治理投入的是初期的一次性梳理,换来的是长期的成本可控与运维可控,这是云运营里"最值得先做"的事之一。
五、资源生命周期管理全景
把资源从"创建"到"销毁"的完整生命周期画出来,能帮你看到治理动作分别落在哪个阶段。一个典型的云资源生命周期是这样的:
申请阶段:业务方提出需求,通过 IaC 模板或审批流程创建资源。这一阶段的治理重点是"模板化"与"配额校验"——资源按标准模板建,配额前置检查,从源头杜绝野资源。
运行阶段:资源投入使用,被监控、被调度、被优化。这一阶段的治理重点是"监控"与"弹性"——利用率低的下调规格,负载高的自动扩容,标签与权限随时维护。
变更阶段:规格调整、配置升级、环境迁移。这一阶段的治理重点是"可回滚"——每一次变更都通过代码与版本控制,出问题能退回上一个稳定状态。
回收阶段:资源不再使用,下线并销毁。这一阶段的治理重点是"定期扫描"与"确认机制"——批量发现低利用率资源,确认无人使用后下线,避免"僵尸资源"长期扣费。
四个阶段对应四个不同的治理动作,缺一个,生命周期就出现管理真空。最常见的真空在"回收阶段"——资源建了不销毁,账单默默流了几个月才被发现。把生命周期图画出来贴墙上,每个阶段该做什么、谁负责,一目了然。
六、资源编排的进阶:从编排到平台工程
资源编排做到成熟阶段,会向"平台工程"演进:把常用的环境模板、部署流水线、监控基线固化成内部平台,开发团队自助申请、自助发布,运维团队从"挨个配置"变成"维护平台规则"。
这不是遥不可及的目标,而是一个清晰的方向:先做 IaC 与环境模板,再做自助化平台,最后形成"内部开发者平台"。每一步的收益都可量化——自助化程度越高,重复性运维工时越少。读完第 3.3 节自动化与 DevOps,这个方向会更完整。这里先记住:资源编排的终点,不是"自动化做更多事",而是"让团队不需要重复做这些事"。
七、资源编排的常见失败模式
自动化做了一半反而更乱的案例并不少见,提前认识三种失败模式,能帮你绕开坑。
第一种是"伪 IaC":写了 IaC 文件,但实际环境还是手工改出来的。代码和环境对不上,配置文件变成"文档",别人照着跑根本建不出真实环境。根治办法是纪律:环境只能由代码变更,任何人不得手工改生产资源。
第二种是"模板僵化":环境模板写得太死,每次业务有变化都要改模板、走全流程,团队觉得麻烦,又开始手工建环境,退回老路。根治办法是模板参数化——把规格、数量、网络段做成参数,一套模板适配多种需求。
第三种是"权限失控的自动化":给了自动化工具过大的权限,一旦配置写错,一条命令可能批量删掉生产资源。根治办法是"最小权限 + 变更审批"——自动化脚本只持有它需要的那部分权限,关键操作走人工确认。
这三种失败模式的共同点,是把"自动化"当成了目的本身,而忘了自动化是为"稳定、可审计、可回滚"服务的。工具本身没有错,错的是用它的方式和度。记住这个判断标准:自动化没有让环境更稳定、更可追溯,那它就是反向的自动化。
要点串联
- 四个动作:盘点、分配、监控、回收,构成资源管理的完整闭环。
- 盘点先行:不盘清家底,治理无从谈起;标签是归属管理的抓手。
- IaC 三大收益:可重复、可审计、可回滚,消灭"环境漂移"。
- IaC vs 容器编排:IaC 管资源定义,编排管容器调度,常配合使用。
- 回收的价值:删除闲置资源是性价比最高的成本优化。
- 编排闭环:请求 → 校验 → 执行 → 登记 → 监控,全程留痕。
- 工具选型:Terraform 跨云通用,Kubernetes 是容器编排事实标准。
资源管理好了,但怎么知道它们"活得好不好"?下一节讲监控与日志——把仪表盘和录音笔装上,出问题才能第一时间发现、最快速度定位。