3.2 监控与日志
3.2 监控与日志
本节摘要:监控与日志是云上"感知系统":监控负责看指标(CPU、内存、响应时间、错误率),日志负责看细节(请求轨迹、错误堆栈、审计记录)。两者配合才能完成"发现异常 → 定位根因 → 恢复服务"的完整闭环。本节拆解性能监控、应用监控、告警、可视化,以及集中式日志管理、日志分析、安全审计的用法,并给出一套从指标到告警再到日志排障的实践方法。
先说结论
阅读完本节,你应当能够:
- 区分监控(指标)与日志(事件)各自解决的问题。
- 说出性能监控与应用监控分别盯哪些指标。
- 描述"告警规则 → 告警通知 → 响应处理"的完整链路。
- 解释集中式日志管理为什么是排障与审计的基础设施。
一、问题与直觉
没有监控的云环境是什么感觉?就像开车没有仪表盘、没有后视镜——你知道车在动,但不知道速度、油量、哪个轮胎在冒烟。用户报"网站打不开",你连"是网络、是应用、还是数据库"都分不清,只能凭感觉重启。
监控与日志就是给系统装上"仪表盘"和"录音笔":监控实时报告各项指标的健康状态,日志记录每一件发生过的事。两者是互补的——指标告诉你"哪里不对",日志告诉你"为什么不对"。只有指标没有日志,你能发现故障但查不到根因;只有日志没有指标,你要等用户投诉才知道出了问题。
本节的工程要点可以用一句话概括:让"发现问题"从靠用户投诉,变成靠系统自己告警。 这是运维从被动到主动的分水岭。
二、核心原理
2.1 监控:指标的世界
监控采集两类指标。性能监控(资源层):CPU 使用率、内存占用、磁盘 IO、网络流量,回答"机器累不累"。应用监控(应用层):响应时间、错误率、吞吐量,回答"服务好不好"。后者比前者更接近用户体验——机器很闲但应用很慢,问题往往出在应用或依赖上。
2.2 告警:把异常变成通知
指标本身不会喊救命,告警规则才会。告警要做三件事:定义规则(CPU 超 90% 持续 5 分钟、错误率超 1%)、选择通知渠道(短信、邮件、IM、电话)、设定升级策略(无人响应则升级到更高一级)。告警不是越多越好——垃圾告警会让人麻木,真正的告警体系追求"少而准"。
2.3 日志:事件的记录
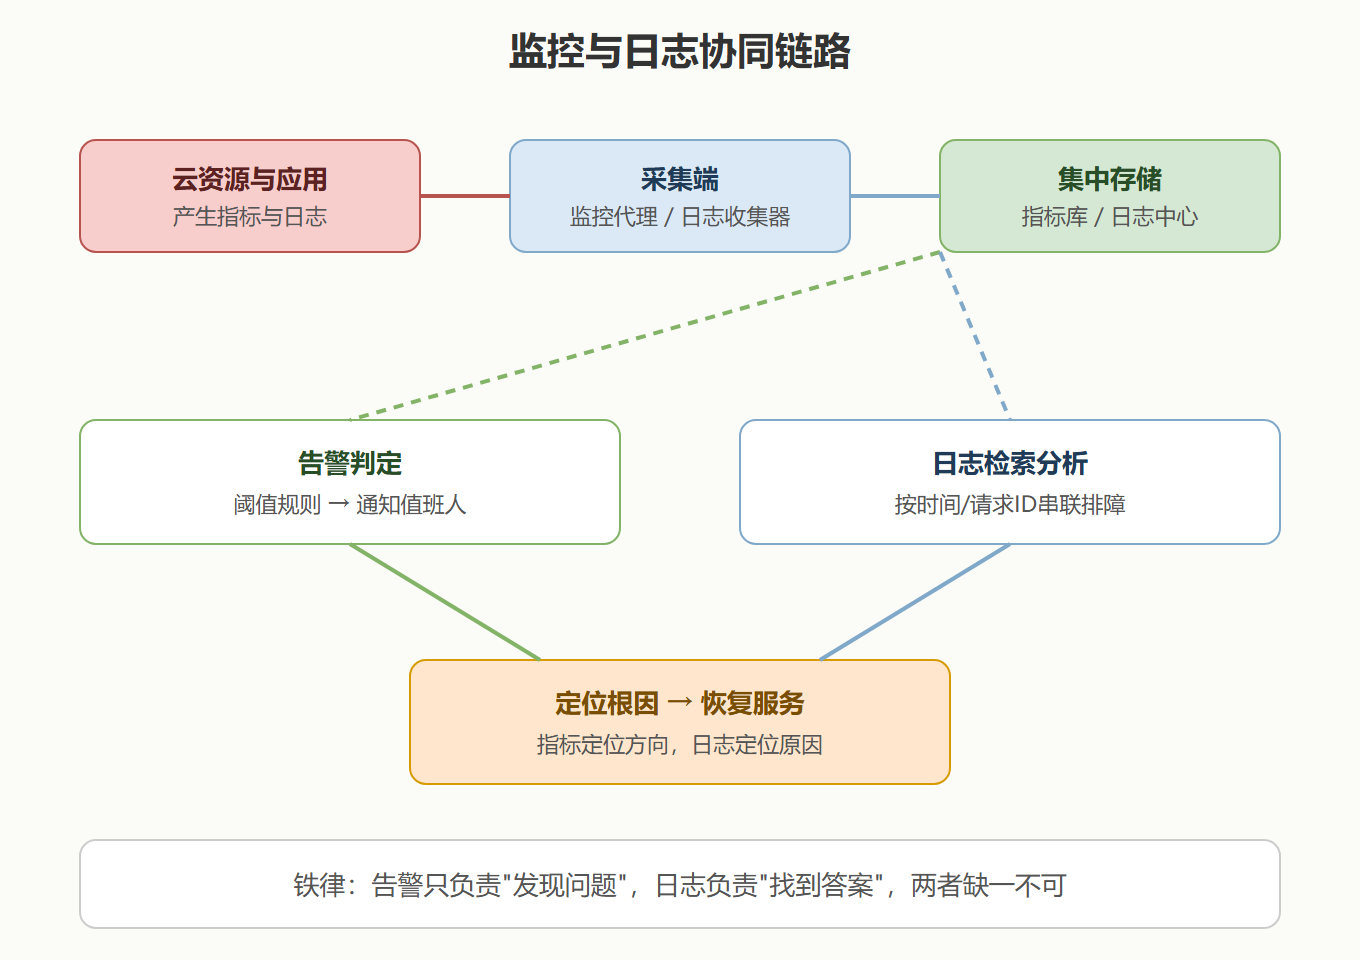
日志记录系统中发生的事件:请求日志、错误日志、审计日志、系统事件。集中式日志管理把分散在每台机器上的日志收集到一个中心化存储,统一搜索与分析——否则排障时你需要在几十台机器上挨个翻文件。常见工具如 Elasticsearch(存储检索)+ Kibana(可视化)+ Logstash(收集),合称 ELK 栈;商业方案如 Splunk。
日志分析的价值有两个方向:一是排障——出问题时,通过时间戳与请求 ID 串起一条链路,定位根因;二是安全审计——追踪用户行为和系统事件,发现异常与合规风险。
2.4 可视化:把数据变成判断
监控数据量大,纯看数字不直观。仪表盘(Dashboard)把关键指标组织成图:服务健康总览、资源趋势、业务指标。仪表盘的价值不是"好看",而是"一眼看出有没有问题"——一个好的运维大屏,值班人员扫一眼就知道今天有没有要处理的事。
三、工程实践要点
3.1 监控与日志的完整链路
3.2 监控对象与关键指标对照
| 监控对象 | 关键指标 | 告警信号 |
|---|---|---|
| 计算实例 | CPU、内存、磁盘 IO、网络流量 | 持续高水位 → 扩容或排查 |
| 应用服务 | 响应时间、错误率、吞吐量 | 错误率突增 → 应用或依赖异常 |
| 数据库 | 连接数、慢查询、锁等待 | 连接数打满 → 排查连接池与慢 SQL |
| 网络 | 延迟、丢包、带宽 | 丢包率升高 → 链路问题 |
| 业务指标 | 订单量、转化率、支付成功率 | 指标异动 → 业务逻辑问题 |
⚠️ 常见坑:监控装了一堆,告警全设成"严重"级别,结果值班手机半夜响个不停,第二天全部静音。告警要分级:严重(立即处理)、警告(班内处理)、信息(记录即可),并持续调优规则,把"假警"压下去。
💡 关键直觉:监控的终点不是"有图表",而是"有人会在问题扩大前被通知到"。设计监控的第一问永远是:这个指标异常了,谁在几秒内会知道?
3.3 排障的标准动作
故障发生时,按"告警 → 确认影响 → 指标定位 → 日志定位 → 恢复 → 复盘"六步走。前两步决定响应速度,中间两步决定定位效率,最后两步决定不再复发。排障时最忌讳一上来就翻日志——先看指标确认问题范围(哪台机器、哪个服务),再用日志深挖根因,效率最高。
四、常见问题(FAQ)
Q1:告警和日志是一回事吗?
不是。告警是"基于指标阈值触发通知"的主动机制;日志是"记录事件"的被动记录。告警让你在问题发生时被叫醒,日志让你醒后能查到发生了什么。两者分工明确、必须配合。
Q2:监控数据要存多久?
指标数据通常保留较短(30 天到 90 天),用于日常排障与趋势分析;日志因合规与审计需要可能保留更久,按法规与业务要求定,可以归档到廉价存储。存储成本与追溯能力要平衡着定。
Q3:Prometheus 和 Grafana 是干嘛的?
Prometheus 是监控与指标采集系统(拉取指标、存时序、触发告警),Grafana 是可视化仪表盘(把 Prometheus 等数据源的指标画成图)。两者是当前最流行的开源监控组合,常配合使用。
Q4:没有专职运维,还要不要搞监控?
更要搞,而且用托管监控服务更合适。云厂商自带的监控与告警服务开箱即用,配上"免费额度内的核心指标",就足够小团队用了。没有运维更要让系统自己会喊救命。
Q5:日志太多太贵怎么办?
三层策略:只采集有意义的日志(过滤掉 debug 噪音)、分环境采集(生产全量、测试精简)、冷热分层(热日志在线检索、老日志归档存储)。日志成本失控大多是"什么都存、存多久都行"造成的。
五、监控指标的两个经典视角
聊监控,有两个常被混淆的视角值得单独拎出来讲清楚:资源视角与用户体验视角。
资源视角问的是"基础设施够不够":CPU 是不是跑满了、磁盘是不是快满了、带宽是不是不够了。它回答的是"机器层面的健康"。这个视角适合资源预警——提前发现机器要撑不住了,在故障发生前扩容。
用户体验视角问的是"用户是不是受影响了":页面响应时间、接口成功率、关键业务转化率。它回答的是"服务层面的健康"。这个视角才真正反映业务——有可能机器都挺闲,但某个接口依赖的下游服务变慢,用户已经卡到崩溃。
成熟的监控体系两个视角都要有:资源视角保底(基础设施不崩),体验视角兜业务(用户不卡)。很多团队只盯着 CPU 这类资源指标,结果资源一切正常、用户却在投诉,就是因为缺了体验视角。架构上常用的做法是"黄金指标"——延迟、流量、错误、饱和度四类,既覆盖资源也覆盖体验,值得作为建立监控体系的起点。
六、日志的价值:不止排障
日志常被当作"排障工具",但它还有两个更深远的价值。第一是审计与合规:谁在什么时间对什么资源做了什么操作,日志里都有据可查,这是安全审计与法规合规的原始材料(呼应第 4.5 节)。第二是业务洞察:请求日志里的访问模式、错误分布、功能使用频度,能反向指导产品决策——哪个接口没人用、哪个流程总出错,日志比问卷诚实得多。
这也解释了为什么"集中式日志管理"值得认真投入:散落在各机器的日志只有排障价值,集中后的日志才有审计与洞察价值。把日志当成资产而不是垃圾,是运维思维的一次升级。好的日志体系,平时默默无闻,关键时候既是安全证据,又是业务情报。
七、监控体系的落地顺序
建立监控体系不用一步到位,按"先保底、再优化、后完善"的顺序推进,比憋大招靠谱。
第一步,上线基础监控:给所有核心资源开启云厂商自带监控,采集 CPU、内存、磁盘、网络四类基础指标,设置最基本的告警(资源持续高水位)。这一步半天内完成,先把"系统失明"的问题解决掉。
第二步,接入应用监控:给应用接上探针或埋点,采集响应时间、错误率、吞吐量,建立"服务健康"仪表盘。这一步需要开发配合,但收益立竿见影——从此故障定位有了方向。
第三步,建立日志中心:把分散日志集中起来,统一检索。这一步让"能发现故障"升级为"能查清根因",是排障效率的分水岭。
第四步,完善告警治理:梳理告警规则,分级、去重、设升级策略,让告警"少而准"。同时做故障复盘,把每次故障沉淀成新的监控规则。
四步走完,一个能自愈、能预警、能追根因的监控体系基本成型。每一步的完成标准都很明确,不会陷在"先搞个大平台"的泥潭里。记住:监控的价值是逐步兑现的,第一步的收益就已经很大,别等全部做完才用上。
温故知新
- 监控 vs 日志:指标告诉你"哪里不对",日志告诉你"为什么不对"。
- 两层监控:性能监控盯资源,应用监控盯体验,后者更贴近用户。
- 告警三件事:定规则、选渠道、设升级,追求"少而准"。
- 集中式日志:统一收集与检索,是排障与审计的基础设施。
- 可视化:仪表盘的价值是"一眼看出有没有问题"。
- 六步排障:告警→确认→指标→日志→恢复→复盘。
- 告警分级:严重/警告/信息分级,避免告警疲劳。
- 日志成本:只采有用的、分环境采集、冷热分层,控制存储开销。
监控告诉我们系统"现在好不好",但"怎么让系统长期好"要靠自动化与流程——下一节讲自动化与 DevOps,把部署从手工变成流水线。