第5章 工程实践与性能优化
第 5 章 · 工程实践与性能优化
章节摘要:前面四章的算法要"跑得快、跑得稳",离不开两件事:趁手的数据结构与清醒的复杂度意识。本章前半讲图算法的两大支柱数据结构——优先队列(Dijkstra、Prim 的引擎)与并查集(Kruskal、连通性判断的引擎)的实现要点;后半讲复杂度分析驱动的优化路径,并以 Dijkstra 的三档实现为解剖标本;最后把三大算法族放进导航、社交、物流、推荐等真实场景做综合演练。读完本章,你应当完成从"会写算法"到"会工程化地用算法"的跨越。
学习目标
阅读完本章,你应当能够:
- 说明二叉堆的插入、取最小操作及其对 Dijkstra、Prim 复杂度的贡献;
- 实现带路径压缩与按秩合并的并查集,并理解其近常数复杂度;
- 用复杂度分析定位瓶颈,按"数据结构、算法、并行、空间"四条路径优化;
- 复述 Dijkstra 朴素版、二叉堆版、斐波那契堆版的三档复杂度与工程取舍;
- 在真实场景中完成"业务问题—图模型—算法选型—性能预估"的完整链路。
核心概念速览
算法决定上限,数据结构和常数决定你离上限有多近。
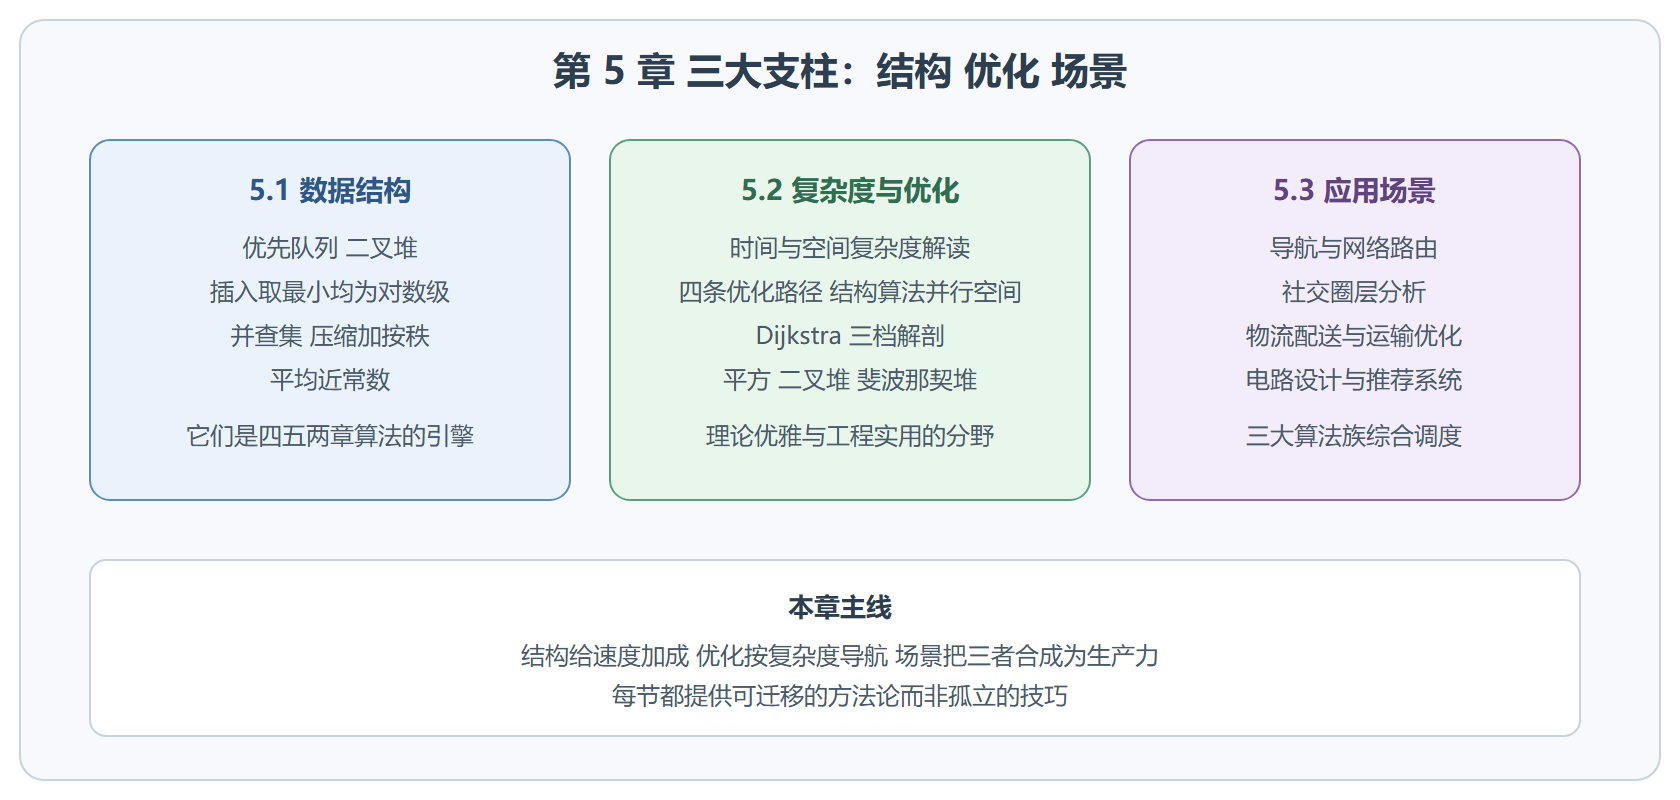
工程化三支柱
子章节导航
5.1 常用数据结构:优先队列与并查集
两大引擎的实现细节、复杂度与选型,含"什么情况下不值得用堆"的判断。
5.2 性能优化与复杂度分析
复杂度怎么读、瓶颈怎么找、四条优化路径怎么选,Dijkstra 三档实现做全样本解剖。
5.3 典型应用场景:导航、社交与物流
把三大算法族装进五个行业场景,演练从业务问题到性能预估的完整链路。
子章节之间的逻辑关系
三节是"装备—方法—战场"的关系:5.1 提供装备,5.2 提供方法论(并直接解剖 5.1 装备在 Dijkstra 上的三档表现),5.3 把装备与方法一起拉进真实约束(规模、延迟、成本)下检验。
优先队列 ┐ 并查集 ┴─> 复杂度分析定位瓶颈 ─> 四路优化 ─> 场景实战检验 Dijkstra 三档为标本 导航 社交 物流 推荐
常见疑问解答
复杂度分析总是记不住规则怎么办?
放弃背规则,改用"代入估算":拿 n 等于一百万代入,线性是百万、平方是万亿、log 项约二十——数字比符号好记得多。再配合"每层循环贡献一个因子、每次减半贡献一个 log"的观察法,绝大多数图算法的复杂度都能现场推出来,本章 5.2 节的速查表则负责兜底。
优化一个图算法服务,从哪里下手?
按 5.2 的顺序:先量规模与操作模式,判断当前复杂度档位是否匹配;再查数据结构是否有"高频问话没缓存"的模式(5.1 的两个引擎正是为此存在);然后考虑算法换挡或预处理;最后才轮到并行与分布式。反过来的顺序(一上来就想加机器)是性能工程最常见的烧钱方式。
本章的案例能直接套到我的业务吗?
链路能套,结论不能。5.3 的四步链路(业务问题、图模型、算法族、工程约束)是方法论,任何关系型业务都能走一遍;但每一步的答案——顶点是什么、权重怎么定、规模多大——完全取决于你的业务。建议拿自己业务里的一个真实问题把四步走一遍,走通了,这本书就算真正读完了。
本章的自测清单
五题收官自查:说明堆的两个修复动作及其复杂度;写出并查集双优化的含义与复杂度结论;复述四条优化路径并各举一例;比较 Dijkstra 三档实现的复杂度与工程评价;用自己的业务走一遍四步建模链路。最后一题没有标准答案——它就是本书希望你带走的东西:从任何关系型问题到图模型,一步之遥,而这本教程已经替你把这一步铺平。
章末的一句提醒
工程能力与算法知识的差别在于"约束意识":知识告诉你算法多快,约束告诉你它在你这台机器、这个规模、这个时效要求下还剩多少余量。本章的一切工具——结构选型、复杂度账本、基准测试、四步链路——都是为了把"约束"变成可度量的数字。带着数字做决策,是工程师与爱好者的分水岭,也是这本书希望你带走的最后一件行李。
前置知识与后续延伸
- 前置:第 2 章 Dijkstra 与第 3 章 Kruskal 的算法流程(本章直接讨论它们的内部结构);大 O 记号的基本读法。
- 为后续延伸:本章给出的优化思维(结构换时间、常数工程、并行化)可直接迁移到任何算法工程问题;应用场景一节可作为读者用自己业务做图建模的模板。