Dijkstra算法:非负地形上的贪心行军
Dijkstra 算法:非负地形上的贪心行军
阿姆斯特丹一间咖啡馆的露台上,一位年轻的荷兰科学家望着街道出神:怎样用电脑算出这座城市任意两地的最短路线?他后来在回忆里说,整个算法在头脑里成形只花了一支烟的工夫,没有纸笔。这就是 Dijkstra 算法的诞生现场。本章远征队打响急行军竞赛的第一仗,本节完整推演这支贪心部队的作战逻辑:它凭什么敢断言"当前离起点最近的那个据点,距离已尘埃落定",又为什么必须要求地形非负。上一章的疆域勘定解决了"通不通",本节开始回答"多快能到"。
战役背景:从跳数到里程
第 3 章广度优先已经解决过"最短"——但那是跳数意义下的最短,每条边等长。现实地形里,通往相邻据点的道路有长有短:绕远的高速与抄近的土路,代价完全不同。一旦边带上互不相同的权重,"层次即距离"立即失效——两跳的路可能比五跳的路远得多。
问题的形式化:给定带权图与起点 s,对每个可达顶点 v 求一条从 s 到 v 的边权总和最小的通路。约定权重表示代价(里程、耗时、费用),求最小;若权重表示收益,则最小化和最大化可以互相转换,思路不变。还须排除一类病态地形:负环——沿环走一圈总权为负,转的圈数越多总代价越小,"最短"就失去了定义。Dijkstra 不需要显式处理负环,因为它干脆拒绝一切负权边,这是它的入场条件,也是它的软肋。
思路推演:贪心的胆量从哪来
算法核心是一个反复执行的判断:在所有"尚未敲定距离"的据点里,挑出当前估值最小的那个 u,宣布它的距离就此定死、不再更改;然后用 u 的出边去改善邻居们的估值。
这个宣布凭什么成立?关键是两条:其一,估值只减不增——改善估值的操作(术语叫松弛:发现经过 u 到 v 更近,就用新值覆盖旧值)永远把估值往下修;其二,权重非负。设 u 是当前未敲定顶点中估值最小者,若存在某条更短的真路线到 u,这条路必须先经过另一个未敲定顶点 x 再抵达 u;但那条路走到 x 时的已付代价已经不低于 x 的当前估值,而 x 的估值又不小于 u 的估值(u 是最小者),再加上 x 到 u 还要付出一段非负的路费——这条"更短的路"怎么算都不短。矛盾收场,u 的估值就是精确值。
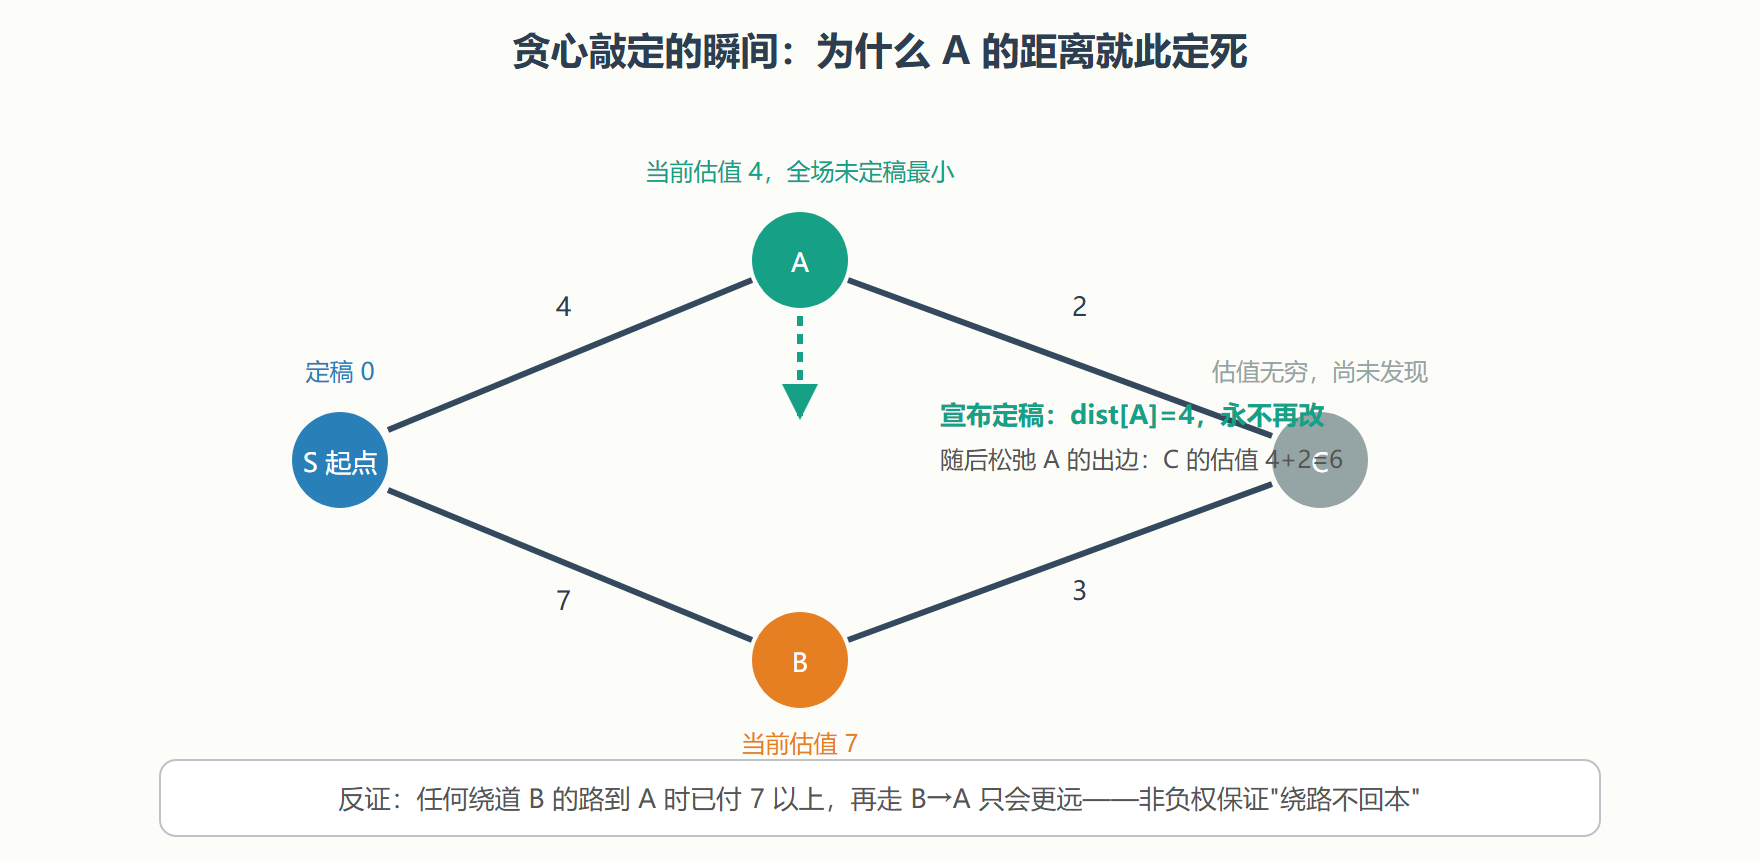
对照上一章广度优先的证明结构会发现惊人的相似:那里靠"先发现者先扩展"保证层次精确,这里靠"估值最小者先敲定"保证距离精确——把普通队列升级成按估值排序的优先队列,无权图的最短路就推广成了非负加权图的最短路。这是算法演化里最漂亮的一条谱系线。
算法步骤与实现
步骤归纳成口诀:白点估无穷,择近而定稿,出边勤松弛,直至无白点。先写朴素版(每轮线性扫找最小估值),它胜在清晰:
import networkx as nx def dijkstra_plain(G, s): """朴素版:每轮线性扫最小估值。适合稠密图。""" INF = float("inf") dist = {v: INF for v in G.nodes} dist[s] = 0 done = set() parent = {s: None} while len(done) < len(G.nodes): u = min((v for v in G.nodes if v not in done), key=lambda v: dist[v]) # 择近 if dist[u] == INF: # 剩下的都不可达 break done.add(u) # 定稿 for v, attr in G[u].items(): nd = dist[u] + attr["weight"] # 松弛 if nd < dist[v]: dist[v] = nd parent[v] = u return dist, parent roads = nx.Graph() roads.add_weighted_edges_from([("S","A",4),("S","B",7),("A","C",2), ("B","C",3),("A","B",1)]) dist, parent = dijkstra_plain(roads, "S") print("距离表:", dist) print("nx 对照:", nx.single_source_dijkstra_path_length(roads, "S"))
朴素版每轮扫一遍顶点表,总代价是顶点数的平方量级。稀疏图上(现实路网的常态)可以换堆优化版:估值塞进优先队列,谁被弹出谁定稿,松弛成功就压新条目进堆:
import heapq def dijkstra_heap(G, s): """堆优化版:适合稀疏图,代价与 边数·log顶点数 同阶""" INF = float("inf") dist = {v: INF for v in G.nodes} dist[s] = 0 heap = [(0, s)] while heap: d, u = heapq.heappop(heap) # 弹出即定稿 if d > dist[u]: # 过期条目,跳过 continue for v, attr in G[u].items(): nd = d + attr["weight"] if nd < dist[v]: dist[v] = nd heapq.heappush(heap, (nd, v)) # 惰性删除:不删旧条目 return dist print("堆优化版:", dijkstra_heap(roads, "S"))
堆优化版里有一个必讲的工程细节:惰性删除。Python 的堆不支持改键,松弛后直接压新条目,旧条目留在堆里过期;弹出时用"当前距离对不上"一句判断丢弃。同一顶点在堆里可能躺几个条目,堆的大小至多与边数同阶,复杂度依然干净利落。这个技巧在 A 星搜索、网络流的优先队列实现里反复出现,值得一次学透。
复杂度与正确性账本
朴素版总体是顶点数的平方量级;堆优化版是"边数乘边数对数"量级——在稀疏图(边数与顶点数同阶)上,后者把对数级优势兑现为实打实的加速,而稠密图(边数接近平方级)上两者打平,朴素版反而省掉堆的常数开销。正确性证明的主干已在推演段给出,补充一句收尾:归纳基础是起点的距离零;归纳步骤是每次敲定都由"估值单调不增、权非负、取最小"三件套背书——三个条件抽掉任何一个,论证即塌。负权塌得最干脆:一条负边让"绕远路"可能回本,"择近定稿"就成了过早关门。下一节就专门收复这块失地。
应用与变体
Dijkstra 的工程化身遍布各处。导航系统在亿级顶点的路网上跑它,靠的是分层图与双向搜索两味加速剂:先在高速公路骨架上算主干,再下沉到街道细节;从起终点同时对进,搜索前沿相遇即停。互联网路由协议里的链路状态算法(以 OSPF 为代表)本质也是它:每台路由器用泛洪收集全图,再各自算最短路树定转发表。变体方面,单目标最短路把边全部反向即可;次短路在状态里带上"此路是否已偏离开销"的标记;A 星搜索给估值加上"到终点的启发式下界",让搜索不再盲目向四面扩散,而是被启发式牵着直奔目标——启发式若不高估真实距离,正确性证明与 Dijkstra 同构。
⚠️ 常见坑:图里混进一条负权边还继续跑 Dijkstra。算法不会报错,只会安静地给出错误答案——先体检权重,再选兵器。
💡 关键直觉:把"定稿"理解为封箱。每敲定一个据点,就把它的最终距离封进箱子;非负权保证后来者不可能再撬开箱子。贪心算法的正确性从来不是态度问题,是担保物问题。
非负地形上的竞赛已经拿下。可要是地图上藏着"越走越倒贴"的负权道路呢?下一节的稳健打法专治这种地形。