Bellman-Ford与负权地形:反复松弛的稳健打法
Bellman-Ford 与负权地形:反复松弛的稳健打法
「relaxation」,松弛——最短路领域的行话里,这个词指一种极其朴素的动作:发现一条能让距离估值变小的边,就顺着它把估值压下去。Dijkstra 的精妙在于用优先队列让松弛按最优次序发生;而本节的主角干脆放弃次序讲究,抱定一个信念:只要反复松弛足够多轮,任何正确的距离终将被压出来。这支看似笨拙的部队,是上一节贪心打法进不去的负权地形上唯一稳阵的单源最短路算法,还附赠一项独门侦查能力——负环检测。它是新增的一节,补全最短路战役的完整版图。
战役背景:负权是什么地形
负权边初听荒谬,实际应用里却真实存在。运输问题里,某段航线的补贴高过油耗,走这段路反而赚钱;通信问题里,某条链路的增益大于衰减;最经典的是汇率市场——把货币设为顶点、兑换设为边、汇率取对数后取负作权,"最短路"就是在找兑换损耗最小的路径,而一旦出现总收益为正的环(对应负权环),套利机会就浮出水面。
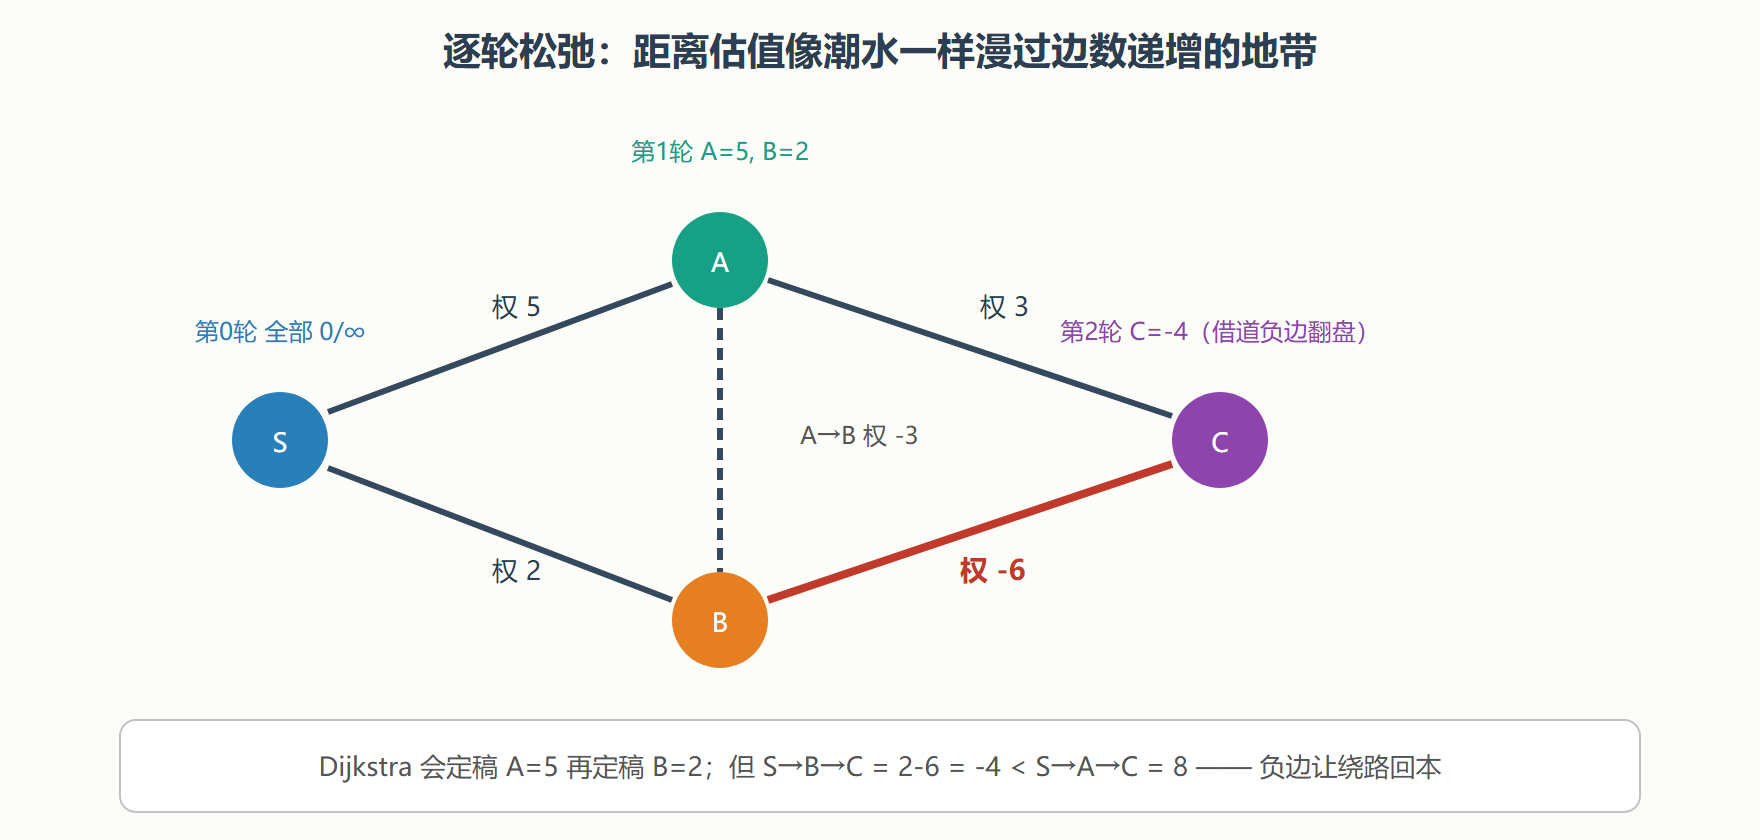
负权为什么击穿 Dijkstra?上一节的证明靠"绕路不回本":已付代价只会越滚越多,所以当前最近的未定稿顶点可以放心敲定。负权边让"回本"成为可能——一条深藏的负边可能让某条绕远的路后来居上,而 Dijkstra 早把近处顶点定稿封箱,再无翻案机会。算法不会崩溃,只会安静地给出错误答案,这比崩溃危险得多。
思路推演:多轮松弛为何够用
Bellman-Ford 的全部内容一句话讲完:把所有边拿过来松弛一遍算一轮,重复"顶点数减一"轮。为什么恰好这么多轮就够?论证的支点是一条结构性观察:若最短路存在,则存在一条"不重复经过任何顶点"的最短路——重复经过某顶点意味着走了环,正环去掉更短,零环去掉不变,所以最短路总能取到无环形态。无环路径至多包含"顶点数减一"条边。
再配合归纳:第一轮松弛结束后,所有"至多一条边"可达的最短距离已被正确压出——因为那一步松弛必然发生过;归纳地,第 k 轮结束后,所有"至多 k 条边"的最短距离已正确压出。跑满"顶点数减一"轮,一切无环最短路都被覆盖。这个证明还解释了算法的稳健来源:它对边的处理次序毫无要求,哪怕某一轮里松弛的传导被打乱,下一轮还会继续传导——正确性只依赖轮数,不依赖顺序。
算法步骤与实现
步骤归纳:初始化所有估值为无穷、起点为零;外层循环"顶点数减一"轮,每轮内层遍历全部边做松弛;结束后再做一轮"体检"——若仍有边能松弛成功,说明存在负环。
import networkx as nx def bellman_ford(G, s): """返回 (距离表, 是否有负环)""" INF = float("inf") edges = [(u, v, d["weight"]) for u, v, d in G.edges(data=True)] dist = {v: INF for v in G.nodes} dist[s] = 0 n = len(G.nodes) for _ in range(n - 1): # 主循环:顶点数减一轮 improved = False for u, v, w in edges: if dist[u] != INF and dist[u] + w < dist[v]: dist[v] = dist[u] + w # 松弛 improved = True if not improved: # 提前收敛,白送的优化 break for u, v, w in edges: # 体检:还能压说明有负环 if dist[u] != INF and dist[u] + w < dist[v]: return dist, True return dist, False terrain = nx.DiGraph() terrain.add_weighted_edges_from([("S","A",5),("S","B",2),("A","C",3), ("B","C",-6),("A","B",-3)]) dist, neg = bellman_ford(terrain, "S") print("距离表:", dist, "| 有负环:", neg) print("nx 对照:", nx.single_source_bellman_ford_path_length(terrain, "S"))
两个实现细节值得圈点。其一,dist[u] != INF 的守卫不能省:无穷加有限还是无穷,但无穷加负数在浮点运算里可能出幺蛾子,守卫让"尚不可达"的边明确跳过。其二,improved 早停:某一轮一条边都压不动,说明估值已全体收敛,后续轮次必然空转——随机图上常常几轮就停,均摊代价远好于最坏情形的账面值。
负环检测那"体检一轮"的正确性同样来自轮数论证:跑满额定轮数后一切无环最短路都已压出,此时若还有边能松弛,唯一的解释是存在能在环上无限套利的负环。负环一旦确认,"最短路"问题本身作废——下面的演练把它变成一个报警器:
def arbitrage_detector(rates, base="美元"): """汇率图负环检测:rates[(a,b)] 是 1 单位 a 换成 b 的数量""" import math G = nx.DiGraph() curs = set() for (a, b), r in rates.items(): curs.add(a); curs.add(b) G.add_edge(a, b, weight=-math.log(r)) # 乘法套利 → 加法负环 G.add_edge(b, a, weight=-math.log(1/r)) _, has_cycle = bellman_ford(G, base) return "发现套利机会" if has_cycle else "市场无套利" rates = {("美元","欧元"): 0.9, ("欧元","英镑"): 0.85, ("英镑","美元"): 1.32} print(arbitrage_detector(rates)) print("三步兑换积:", 0.9 * 0.85 * 1.32) # 大于 1 即套利
汇率乘积大于一,等价于对数权重之和小于零——套利检测就这样精确翻译成负环检测。金融工程里真实的高频套利监控,跑的正是这个算法的工程强化版。
复杂度账与排队优化
账单直白:每轮扫全部边,轮数与顶点数同阶,总代价是"顶点数乘边数"量级——比 Dijkstra 的堆优化版慢出一截,这是稳健的价钱。工程上有一味著名的补救:队列优化(国内文献常称 SPFA),把"发生过松弛的顶点"塞进队列,只从这些顶点出发松弛出边,避免每轮全图空转。它在随机图上表现优异,最坏情形却仍会退化回与 Bellman-Ford 同阶——竞赛圈里"SPFA 已死"的调侃说的正是这种被构造数据打回原形的风险;生产系统若不能担保输入分布,还是老老实实跑原始版本,慢而稳。
应用与选型定位
Bellman-Ford 的地盘集中在三处:其一,权重可能为负且规模不大的场景(成本模型带补贴、带奖励的调度);其二,必须做负环检测的场景(汇率套利、带约束系统的可行性判定);其三,作为分布式最短路协议的理论骨架——距离向量路由协议里每个节点只与邻居交换距离表,本质就是异步的分布式 Bellman-Ford,它对松弛次序不敏感的特性恰好成全了分布式的乱序执行。
⚠️ 常见坑:无向图的一条负权边等于两条负权有向边,立刻构成负环——无向负权图根本没有"稳"的解法,别指望 Bellman-Ford 救场;要么改模,要么先把负权问题重构成非负问题。
💡 关键直觉:Dijkstra 像 VIP 通道——按身份(当前距离)优先敲定;Bellman-Ford 像全体列队操练——不问身份反复演练直到无人进步。身份优先赢在速度,全体演练赢在稳健,算法设计里速度与稳健的取舍在此一览无余。
单源战役两支主力都已成军。下一节换一个更大的战场:不再问"从一个据点到各处",而是一次算清"任意两地之间"的最短路线。