1.3 隐私计算技术地图:MPC 站哪里
1.3 隐私计算技术地图:MPC 站哪里
本节摘要:隐私计算不止 MPC 一条路。本节把同态加密、可信执行环境、差分隐私、联邦学习与 MPC 放在同一张地图上,按"信任假设、计算位置、信息暴露面"三条轴线逐项对比,并给出三个典型场景的选型演算。
选型的三条轴线
技术选型最常见的错误是问"哪个技术更好",正确的问题是"哪个技术对我的威胁模型更贴合"。判断贴合度,看三条轴线就够了。轴线一:你信任谁? 是信任密码学假设(没人能破解数学),还是信任硬件厂商(芯片没开后门),还是信任统计极限(聚合后的数字推不回个人)。轴线二:计算发生在谁的地盘? 数据不动、代码动,还是代码不动、数据进加密域。轴线三:暴露面是什么? 是密文、是中间消息、是聚合统计量,还是模型的梯度。
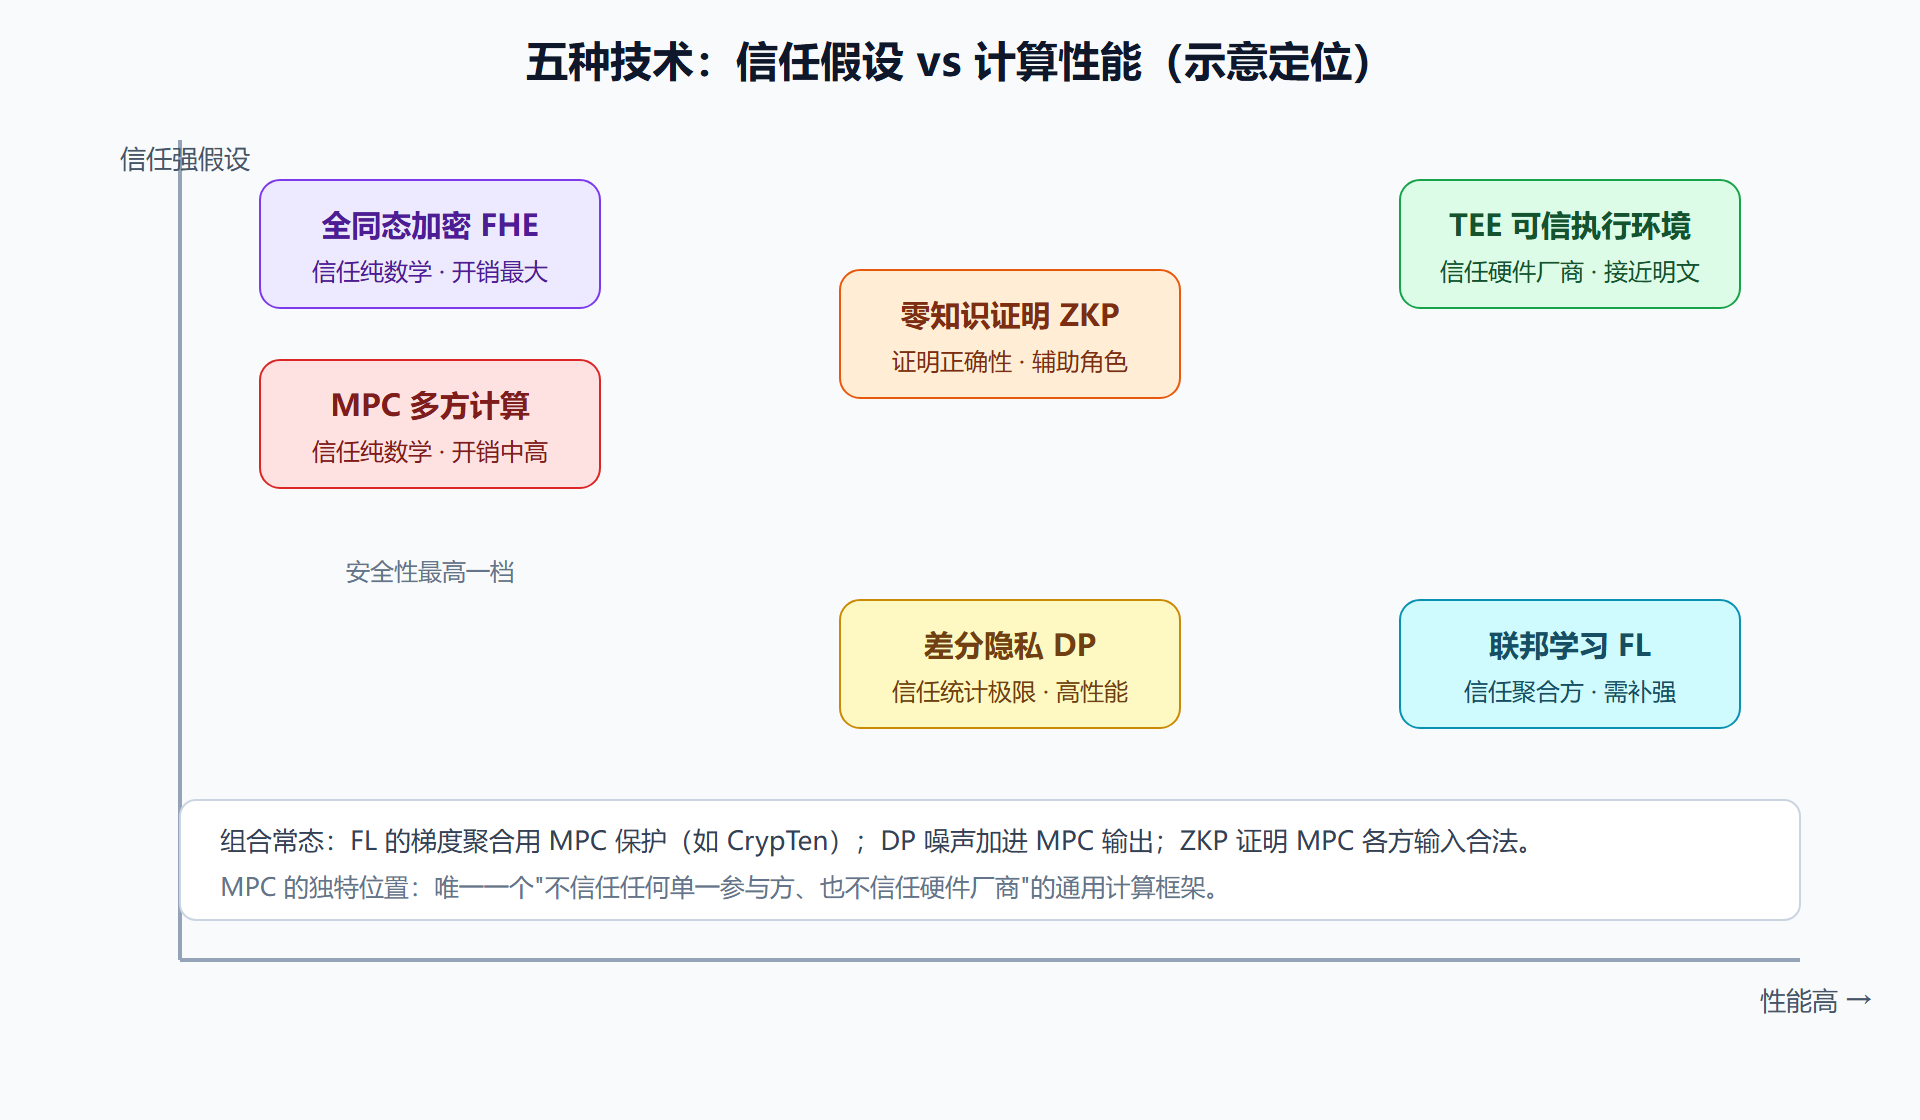
把五种技术往三条轴线上一摆,分歧立刻清晰。同态加密(HE)让计算发生在密文上,暴露面是密文,信任完全押在数学难题上,代价是计算开销高出明文几个数量级。可信执行环境(TEE)把计算搬进一块隔离的芯片飞地,暴露面几乎为零、性能接近明文,但信任押在 CPU 厂商的硬件实现上——Intel SGX 曾被披露的侧信道漏洞就是这类风险的现实注脚。差分隐私(DP)不保护计算过程,只在发布的结果里注入校准过的噪声,用统计上"无法区分"来保护个体,适合发布统计量而非完成联合计算。联邦学习(FL)让数据不动、模型参数动,但梯度本身可能被反推出训练数据(成员推断攻击是实证过的),所以常需要 MPC 或 DP 来补刀。
图:隐私计算技术地图
三道选型演算题
题目一:两家银行联合反洗钱筛查。 双方各有千万级客户流水,规则引擎要精确匹配对方名单。要求精确结果、不允许任何原始明细出域。TEE 方案性能最好,但两家是竞争关系,"信任同一家芯片厂商"在合规审查里说不清;MPC 门电路路线对精确匹配这类逻辑运算天然合拍。答案倾向 MPC(真实系统常用混淆电路或 PSI 变体,见第 7 章)。
题目二:监管部门发布行业统计数据。 只需要发布若干聚合指标,不需要交互计算。DP 直接加噪声发布,成本几乎为零,MPC 在这里属于杀鸡用牛刀。这个题的意义在于提醒:只有"多方能各自保留输入的联合计算"才是 MPC 的主场。
题目三:若干机构联合训练模型。 数据量大、需要迭代训练。纯 MPC 跑完整训练的通信开销在广域网上仍然吃紧;FL 先把"数据不动"做到,再用 MPC 保护梯度聚合环节,是最常见的混合架构。这也解释了为什么第 7 章会把 MPC 与联邦学习放在一起正面对比——它们在真实系统里更多是搭档。
MPC 的位置一句话
MPC 是隐私计算版图里唯一同时满足"不信任任何单点、支持通用计算、保护全过程"的框架。它用性能换信任下限:当你的威胁模型里存在"参与方本身不可信"这一条时,其他技术都要求你额外信任某个单点,只有 MPC 把信任完全交给了数学。这份信任有多贵、怎么把账算细,正是后续六章的内容。
本节要点:选型先画威胁模型再谈技术;五条路线的信任假设互斥而非优劣;MPC 的独特性在于去中心化信任下的通用计算能力。
选型速查问答
问:两边数据都脱敏过了,还需要 MPC 吗? 脱敏不是保险箱:k-匿名被背景知识攻破、哈希被字典攻击反推,都是有公开案例的结论。判断标准不是"有没有处理过",而是"处理后的数据面对掌握外部信息的对手还剩多少信息量"。手机号这类低熵字段即使哈希过,也应走加密求交(7.2 节)而不是明文比对。
问:TEE 性能好得多,机构间合作为什么不直接用它? 因为合作双方往往互不接受"信任对方选的芯片"这个前提。TEE 方案里数据在对方机房解密计算,机密性依赖那颗芯片的实现正确性;MPC 方案里数据根本不离开本地,把"对方需要承诺的事"变成了"对方不需要承诺的事"。信任模型不同,不是性能高低的问题。
问:小团队没有多方需求,MPC 还有用吗? 有一个常被忽略的用途:密钥管理。把一张重要私钥用 Shamir 方案分享给多个内部节点,任意三台在场才能签名、单机被入侵丢不了钥匙(2.2 节)——这是 MPC 思想在零合作场景下的直接落地。
五技术对照的成本补遗
主图的对照表还可以再补一行"成本集中在哪":MPC 的成本集中在网络与工程集成,HE 集中在算力采购,TEE 集中在指定型号硬件与运维,DP 集中在统计方案设计,FL 集中在建模流程改造。预算紧张的团队按"成本集中点"评估哪条路线最痛,比按性能参数对比更贴近决策实际。
地图的动态视角:技术边界在互相渗透
这张地图不是静态的。近几年的趋势是边界渗透:MPC 与 HE 在预处理环节互相借力(2.5 节与 8.3 节的混合模式),FL 与 MPC 在聚合环节合流(7.1 节的混合架构),TEE 与 MPC 在部署层组成"硬件加速加密码兜底"的混合体(8.2 节)。单技术选型正在让位给组合编排,这是隐私计算工程化成熟的重要标志——就像当年"用什么数据库"的问题演变成"怎么设计存储架构"。
对个人能力的启示:只懂一个技术的工程师,价值正在被组合能力稀释。市场更需要的画像是"能画威胁模型、能按责任边界拆技术、能算混合方案的成本账"的架构型选手。本教程刻意把每种技术都放进对照框架里讲(而非孤立讲深),就是为了训练这种组合视角——读完后你可以不记得每个协议的细节,但那张"信任假设乘计算位置乘暴露面"的三轴图要留在脑子里,它是应对未来任何新技术入场的框架。
最后补一个实用提醒:给管理层画技术地图时,别按学科分类画,按"业务问题的形状"画——要精确匹配的画一条线连到 PSI,要联合建模的画一条线连到 FL 加安全聚合,要外部分析证明的连到 ZKP。技术地图的业务化翻译,常常比地图本身更能推动决策。
地图使用的三条禁忌
选型地图用错比不用还糟,三条禁忌记下来。禁忌一:拿地图代替威胁模型。 地图只回答"哪类技术大概适配哪类问题",每一段具体合作都必须先写威胁模型再回到地图——顺序颠倒就是刻舟求剑。禁忌二:按厂商地图做决策。 每家厂商的技术地图都把自己画在中心,这是一切选型材料的第一性偏见;只信你自己画的图。禁忌三:一图定终身。 技术边界在渗透(本章开头说的),你的地图也要随项目复盘不断重画——每次落地后更新一版,一年后它就是机构最值钱的技术资产之一。
三条禁忌背后是同一种职业习惯:把地图当假设,把威胁模型当证据。证据驱动假设更新,地图服务决策——这套方法不止适用于隐私计算,也适用于你职业生涯里的每一次技术选型。