1.2 安全属性三件事:隐私性正确性公平性
1.2 安全属性三件事:隐私性、正确性、公平性
本节摘要:把"协议安全"拆成三个可独立讨论的属性——隐私性(学不到结果之外的输入信息)、正确性(结果确实等于函数值)、公平性(诚实方拿得到结果)。本节给出每个属性的定义、违反场景、与实现代价的关系,并解释它们之间的优先级权衡。
先看三个出事现场
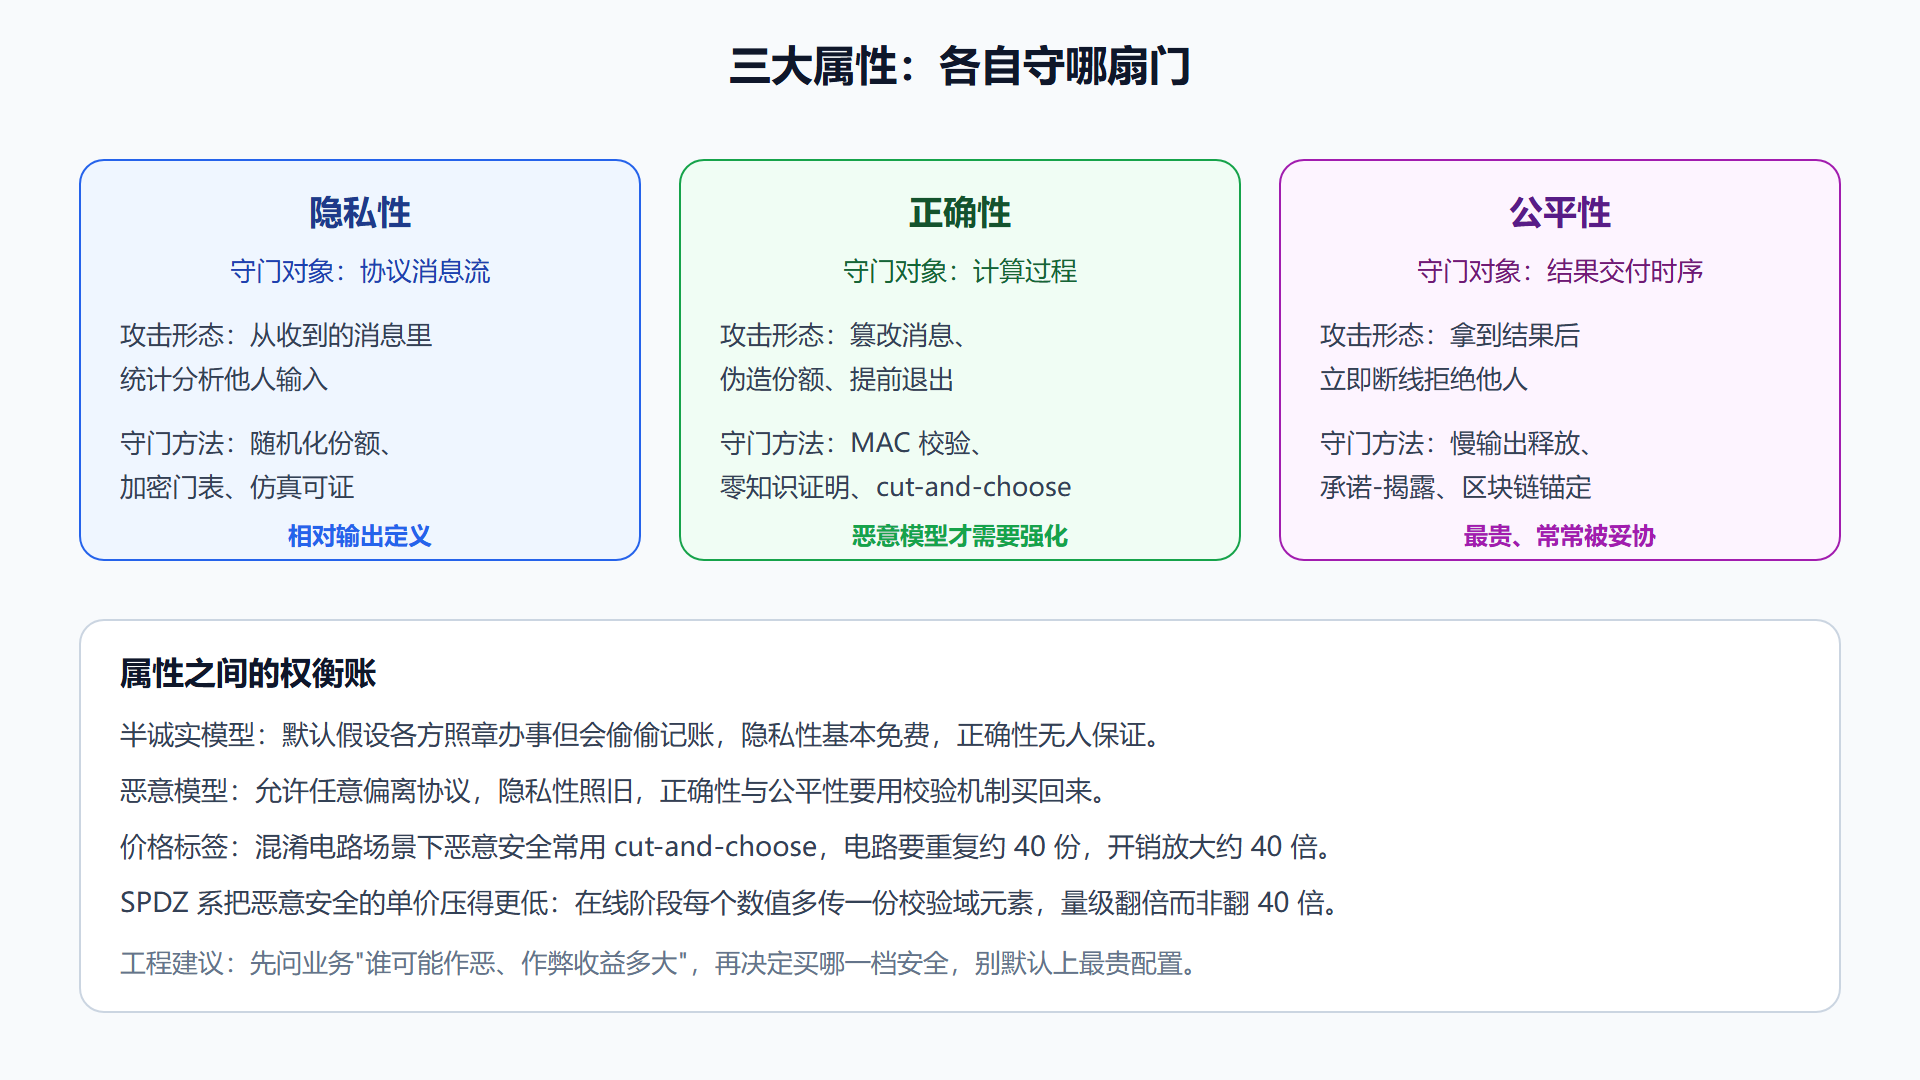
抽象定义不好记,记事故就行。现场一:协议跑完,乙方拿着一堆中间消息做统计分析,居然还原出了甲方输入的大致范围——隐私性被破坏。现场二:甲方中途把自己发出的消息换成了伪造的,最后双方算出一个被操纵的"共识结果",还都以为是真值——正确性被破坏。现场三:甲方在拿到结果的第一时间发消息"我收到了,拜拜",然后断线,乙方永远等不到自己的那份输出——公平性被破坏。
这三种事故对应协议的三条底线。工程上谈 MPC 方案时说的"半诚实安全""恶意安全",本质上就是在说:这套协议在多大的事故范围内守得住。把属性拆开谈还有个实际好处——不同属性的实现代价差得很远,业务上也许只需要强化其中一两项,没必要为用不上的保障付账。
图:三大安全属性与各自的攻击面
隐私性:相对输出定义的守护
隐私性的严格表述绕不开一个直觉:协议泄露的一切,理论上都必须能从输出推算出来。为什么这样定义?因为输出本身就是要给对方看的,输出里自然含有输入的信息——两家银行算完联合均值,每家当然能结合自己的数据估出对方的总和范围,这不算协议的错。协议的错是:你从消息流里学到了"给定你的输入与输出之外"的东西。
用一个最小例子体会边界。函数是 f(x,y) = x+y,甲方输入 x=5,协议结束后甲方拿到和为 12,于是推知 y 在 7 附近——这是输出允许的泄露。但如果甲方从消息流里还能判断出"y 是偶数",这就是超出输出的额外信息,协议在隐私性上不合格。第 2 章会看到加法秘密分享如何做到消息流对 y 完全"零知识":拆出来的每一半都是均匀随机数,单独看与任何秘密都不相关。
正确性与公平性:诚实人的保障
正确性在半诚实模型里近乎免费——大家照着协议算,结果自然对。一旦允许作弊,问题就来了:作弊者能否让结果偏向自己而不被发现?防御手段在后续章节会逐个登场:SPDZ 用 MAC 标签给每个数值配上"防伪码"(5.2 节),混淆电路用 cut-and-choose 抽查电路(3.4 节提到其 40 份复制的代价)。共同思路都是让作弊在统计上必然留痕。
公平性是最微妙的一项。理想状态是"要么所有人都拿到结果,要么谁都拿不到"。但一个只提交一轮消息就下线的参与方,总能比别人早拿到(或干脆不让别人拿到)结果。严格的公平性在两方场景理论上可以做到,代价高昂;实践中常见的妥协是"指定输出方":只有一方拿结果,或借区块链的公开性做交付锚定。谈方案时明确"结果给谁、何时给",比追求教科书式公平更务实。
属性清单的自测
- 给定一个业务场景,能指出它最在乎三项属性中的哪一项;
- 能解释为什么"从结果推算"不算泄露,并举一个输出选择不当导致信息泄露的反例;
- 能说出半诚实到恶意模型的代价跨度:混淆电路约 40 倍、SPDZ 在线约翻倍。
下一节把这三种属性放到更大的技术版图里,看 MPC 的邻居们各守哪一段。
用一次演算看三属性如何互相牵制
设想三家医院联合统计某类术后并发症的平均发生率,输入是各家的并发症例数与手术总量。先看隐私性与正确性的牵制:直接开放均值,隐私性达标(只泄露结果本身),但若某家报错数据,均值随之被污染——半诚实模型下没人校验,正确性是君子协定。上 MAC 校验(第 5 章展开)可以检出篡改,代价是每家多传校验标签。再看隐私性与公平性的牵制:若输出只发给牵头方,另两家贡献了数据却看不到结果,公平性受损;改成多方广播输出,泄露面变成"每家都能拿到均值",统计口径就得重新评估。三个属性不是三个开关,是一台天平上的三个砝码。
# 均值输出的泄露演算:已知均值与自己的输入,他人输入即被确定 total_ops = 3000; my_ops = 1200 published_mean = 1100 / total_ops # 对外发布的联合发生率 for other_ops in (900, 1000, 1100): if abs((my_ops + other_ops) / total_ops - published_mean) < 1e-9: print("反推出对方例数:", other_ops) # 输出:反推出对方例数 1100 —— 泄露源于输出粒度,不是协议缺陷
会话输出一行:给定发布值与自身输入,他方输入唯一确定。这说明"选择输出什么"与"选择什么协议"同等重要——协议给过程兜底,输出粒度给结果兜底。
档位判断的一句话版本
判断题只有一道:参与方有没有作弊的收益。集团内部部门之间的联合报表,作弊收益趋零,半诚实档够用;竞争对手之间的联合风控,作弊收益真实存在,恶意档是必选项。判断错档位的代价不对称:往保守错,多花预算;往激进错,出事故。宁可先保守上线,再按运行数据降档。
一张验收清单的演化史
安全属性的另一面是验收口径——不同年代、不同机构用它的方式差异很大,值得知道脉络。早期项目的验收是"跑通了、结果对",安全停留在口头承诺;合规介入后,验收升级为"敌手模型声明加协议参数清单",开始有了可对照的文本;如今成熟甲方会要求"信息暴露时间线"(3.2 节引入的概念)与第三方审计报告,验收粒度细到了消息级。这条演化线对你读方案文档很有用:看一份方案把安全承诺写到哪一层,就能判断撰写团队的成熟度——只写"采用 MPC"的是初级,写明模型与参数的是中级,给出暴露时间线与审计安排的是高级。
顺带澄清一个高频混淆:半诚实模型不等于"假设大家是好人",它是"假设大家遵守协议"这个可测试的行为约束,与道德无关——竞争方完全可能一边守协议一边把拿到的每条消息喂给分析管道,这正是半诚实模型要防的。相反,恶意模型也不是"假设大家是坏人",而是"假设对手会做任何协议没禁止的事"。两个模型的命名都偏温和,理解时请按行为约束来,别按人品来。
把这些口径装进工具箱后,你会发现后续章节的每个协议细节都能归位到三属性之一:份额设计在守隐私性,校验机制在守正确性,输出安排在守公平性。属性不再抽象,它们是每张协议时序图背后那只看不见的手。