4.2 BMR 协议:多方合扮电路生成者
4.2 BMR 协议:多方合扮电路生成者
本节摘要:BMR(Beaver-Micali-Rogaway)让 n 方共同扮演混淆电路的生成者:每方各持一份随机标签片,拼起来才是完整标签,没有人知道"标签与比特"的对应关系。预处理重、在线常数轮,是广域网多方场景的经典折中。
定位:本节解决什么
混淆电路最优雅的性质是"电路一次混淆、求值一轮跑完"。GMW 把这个性质丢掉了(逐门交互),BMR 想把它在多方场景下找回来。核心障碍只有一个:第 3 章里生成者知道每根导线两枚标签的完整对应(w0 是谁、w1 是谁),若由一方独任生成者,他的输入可以藏住,求值方的输入靠 OT 藏住,但第三方呢?多方场景必须让"对应关系"本身成为秘密。BMR 的答案是:让对应关系被 n 方的秘密分享拆掉——每个参与方只掌握对应关系的一片,合起来才成立。
核心原理:标签的拼装
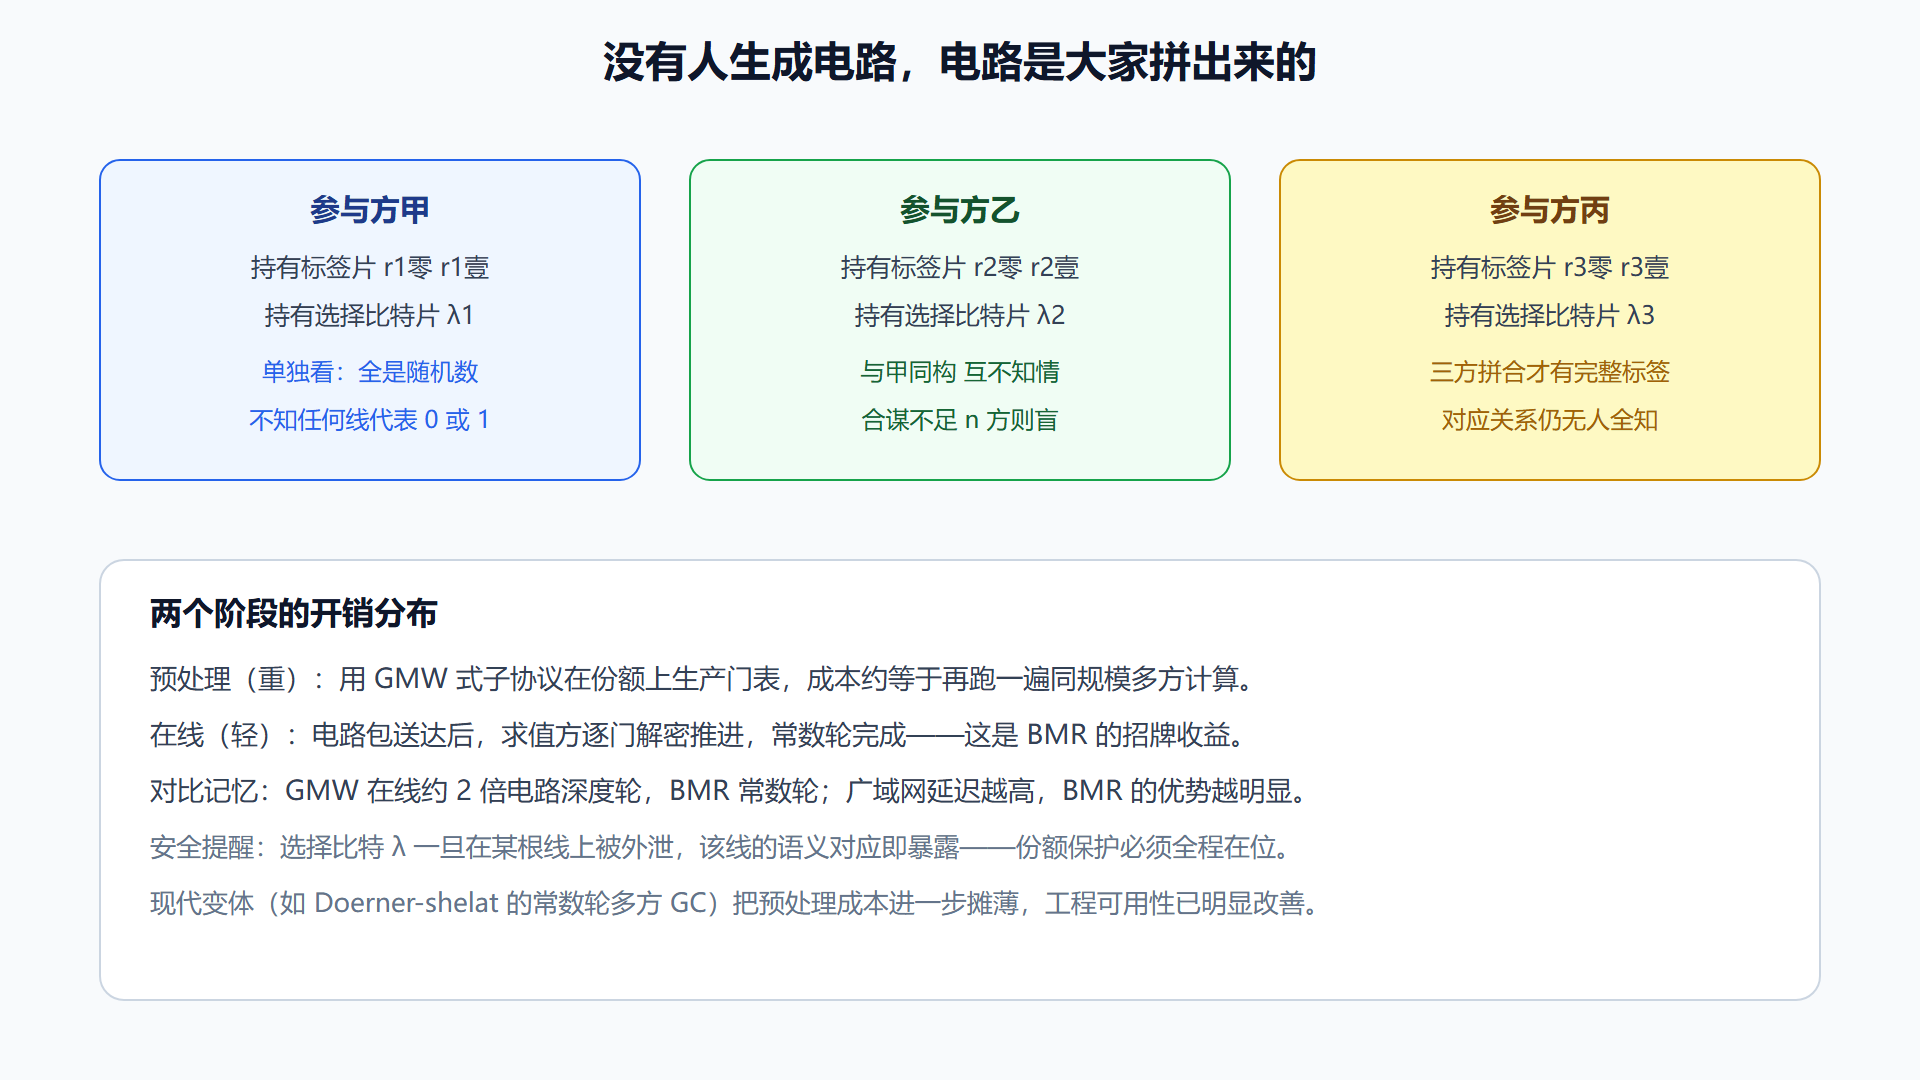
BMR 的做法分两层。第一层,每根导线的两枚标签 w0、w1 由 n 方"各自贡献一片"拼成:第 j 方提供随机片 r_j(0) 与 r_j(1),标签取全体按位异或——w0 = r_1(0) 异或 r_2(0) 异或 … 异或 r_n(0)。任何少于 n 方的合谋都凑不出完整标签,标签本身是安全的。第二层更关键:"哪枚标签代表比特 0"这个对应关系也要分享。引入一枚随机选择比特 λ(每根导线一枚,全体分享),令"对外语义"由它定义:真实标签对是 w(λ) 与 w(1 异或 λ),λ 被拆成 n 片分持。于是没有任何一方知道求值方将来拿到的标签对应明文里的 0 还是 1。
门表的加密沿用第 3 章逻辑,但"用标签对加密"这一步需要各方在不知道完整标签的情况下协作完成——这就是预处理阶段的主要开销来源:各方用 GMW 式的子协议在"标签的份额"上完成异或与加密的模拟,等于用一套多方计算去生产另一套多方计算的材料。开销确实不小(这也是 BMR 长期"理论优雅、工程遇冷"的原因),但换来的是漂亮的在线形态:求值方集齐输入标签后,逐门解密一路冲到输出,常数轮完成。
图:BMR 的多方标签拼装与执行形态
工程实践要点
什么时候选 BMR 而不是 GMW? 判断变量是"在线轮数"与"延迟乘积"。GMW 的在线轮数约两倍电路深度——深度 40 的电路要跑 80 轮,广域网单轮 50 毫秒就是 4 秒,且这是每次执行都要付的。BMR 把大头挪进可离线的预处理,在线只剩几轮:高延迟网络、电路又深、同型计算反复执行(预处理可复用批量化)时,BMR 开始赢。反过来,局域网低延迟、电路浅、一次性计算,GMW 更简单直接。
与第 5 章 SPDZ 的关系。 BMR 的"预处理重、在线轻"哲学与 SPDZ 一脉相承——事实上可以把 BMR 理解为"预处理阶段的 MPC 自己给自己造混淆材料"。现代 SPDZ 引擎里常见"用 SPDZ 的预处理跑 BMR 型在线"的混合架构,取算术的预处理效率与布尔的在线少轮各自所长。
⚠️ 常见坑:把 BMR 当成"多方版混淆电路直接用"。它的预处理成本不是常数 overhead,而是与电路规模成正比的另一场多方计算;小电路场景下这笔固定开销反而远超 GMW 的逐门交互。先量电路规模再选路线。
本节要点:标签多方拼装、选择比特秘密分享是 BMR 的两根支柱;预处理重换在线常数轮;适用面是"深电路加广域网加重复执行"。下一节换算电路本身的账本。
BMR 的现代遗产与两个安全细节
BMR 论文距今三十余年,直接照它实现的生产系统不多,但它的思想遗产遍布现代协议。今天所有"预处理重、在线轻"的多方方案——包括第 5 章 SPDZ 的两阶段结构——都能在 BMR 这里找到原型:用一套多方计算为另一套多方计算准备材料,这个"自举式预处理"的范式是 BMR 首创。学到 SPDZ 时不妨回头对照,会发现两阶段经济学在 1990 年就已写好剧本。
两个实现层面的安全细节值得单独强调。其一,选择比特 lambda 的份额保护必须全程在位:任何一根导线的 lambda 被单方拼凑出来,该线的语义对应即刻暴露,整个混淆随之失效——它是 BMR 的命门,代码评审的必查项。其二,多方拼装标签时的通信要用认证信道,标签片在传输中被篡改不会破坏机密性,但会破坏正确性且难以追责,恶意模型下应配校验。理解了这两点,再去读任何现代常数轮多方 GC 论文,都会觉得似曾相识——这就是概念筑基的意义:新论文只是老思想的新排列。
BMR 的成本核算实例
把 BMR 的"预处理重"量化一次。三方场景跑一张一万个与门的电路:预处理阶段要为每扇门生成标签份额并用子协议完成加密材料的协作计算,通信量约等于跑一遍同等规模 GMW 计算的量级(粗估百万字节级),外加数轮全局交互;在线阶段则只有电路包传输(约 32 万字节)加常数轮求值。对比 GMW 直接跑:预处理为零,在线通信约等于 BMR 预处理与在线之和,轮数约两倍电路深度。
两组数字摆出来,选择逻辑自动浮现:这张电路只算一次,选 GMW,BMR 的预处理成本摊不薄;同一张电路每天算一百次,选 BMR,预处理一次摊薄到每次执行,在线常数轮的延迟优势按次兑现。执行次数与延迟敏感度,是 BMR 适用性的两个开关。
最后补一个历史注脚帮你记这个名字:三位作者 Beaver、Micali、Rogaway 都是密码学奠基期的巨人——Beaver 的另一个遗产正是第 2 章的三元组,Micali 是零知识证明的奠基者之一,Rogaway 在对称密码与协议形式化上贡献卓著。BMR 协议常被形容为"三位巨人的一篇小品",但小品里藏着预处理范式的火种——学术史有时候就是这么有趣,小品比大部头流传得更远。
BMR 与 GMW 的选择速查卡
把两条路线的选择逻辑压成一张速查卡。看执行次数:一次性计算选 GMW,重复执行选 BMR——预处理的摊薄逻辑。看网络延迟:局域网 GMW 顺滑,广域网 BMR 的常数轮在线占优。看电路深度:浅电路两边都轻松,深电路(深度过百)几乎必选 BMR 系。看合谋模型:两者都按"过半诚实"设定,恶意安全需求出现时优先评估第 5 章的算术路线。四行速查覆盖九成选型场景,剩下的两成边界情况,回到 4.2 节的成本核算实例里代入你的真实数字——数字永远比直觉可靠。