4.3 布尔电路的代价:深度宽度与轮数
4.3 布尔电路的代价:深度、宽度与轮数
本节摘要:同一函数可以有无穷多种电路画法,不同画法的开销天差地别。本节建立三个指标——深度决定在线轮数、宽度决定并行度与内存、与门数决定通信量——并用加法器与比较器两个例子演示"电路写法"这门手艺。
定位:本节解决什么
前两节反复出现"约 2 倍深度轮""门数正比通信"这类表述,本节把这三个旋钮一次性讲清。给 MPC 选电路就像给仓库选货架布局:同样的货物(函数),布局(电路结构)决定搬运成本(协议开销)。读完本节,拿到一个任务你应当能先画电路、再估算开销、最后选协议,而不是写完高级语言代码才被框架的编译结果惊吓。
核心概念
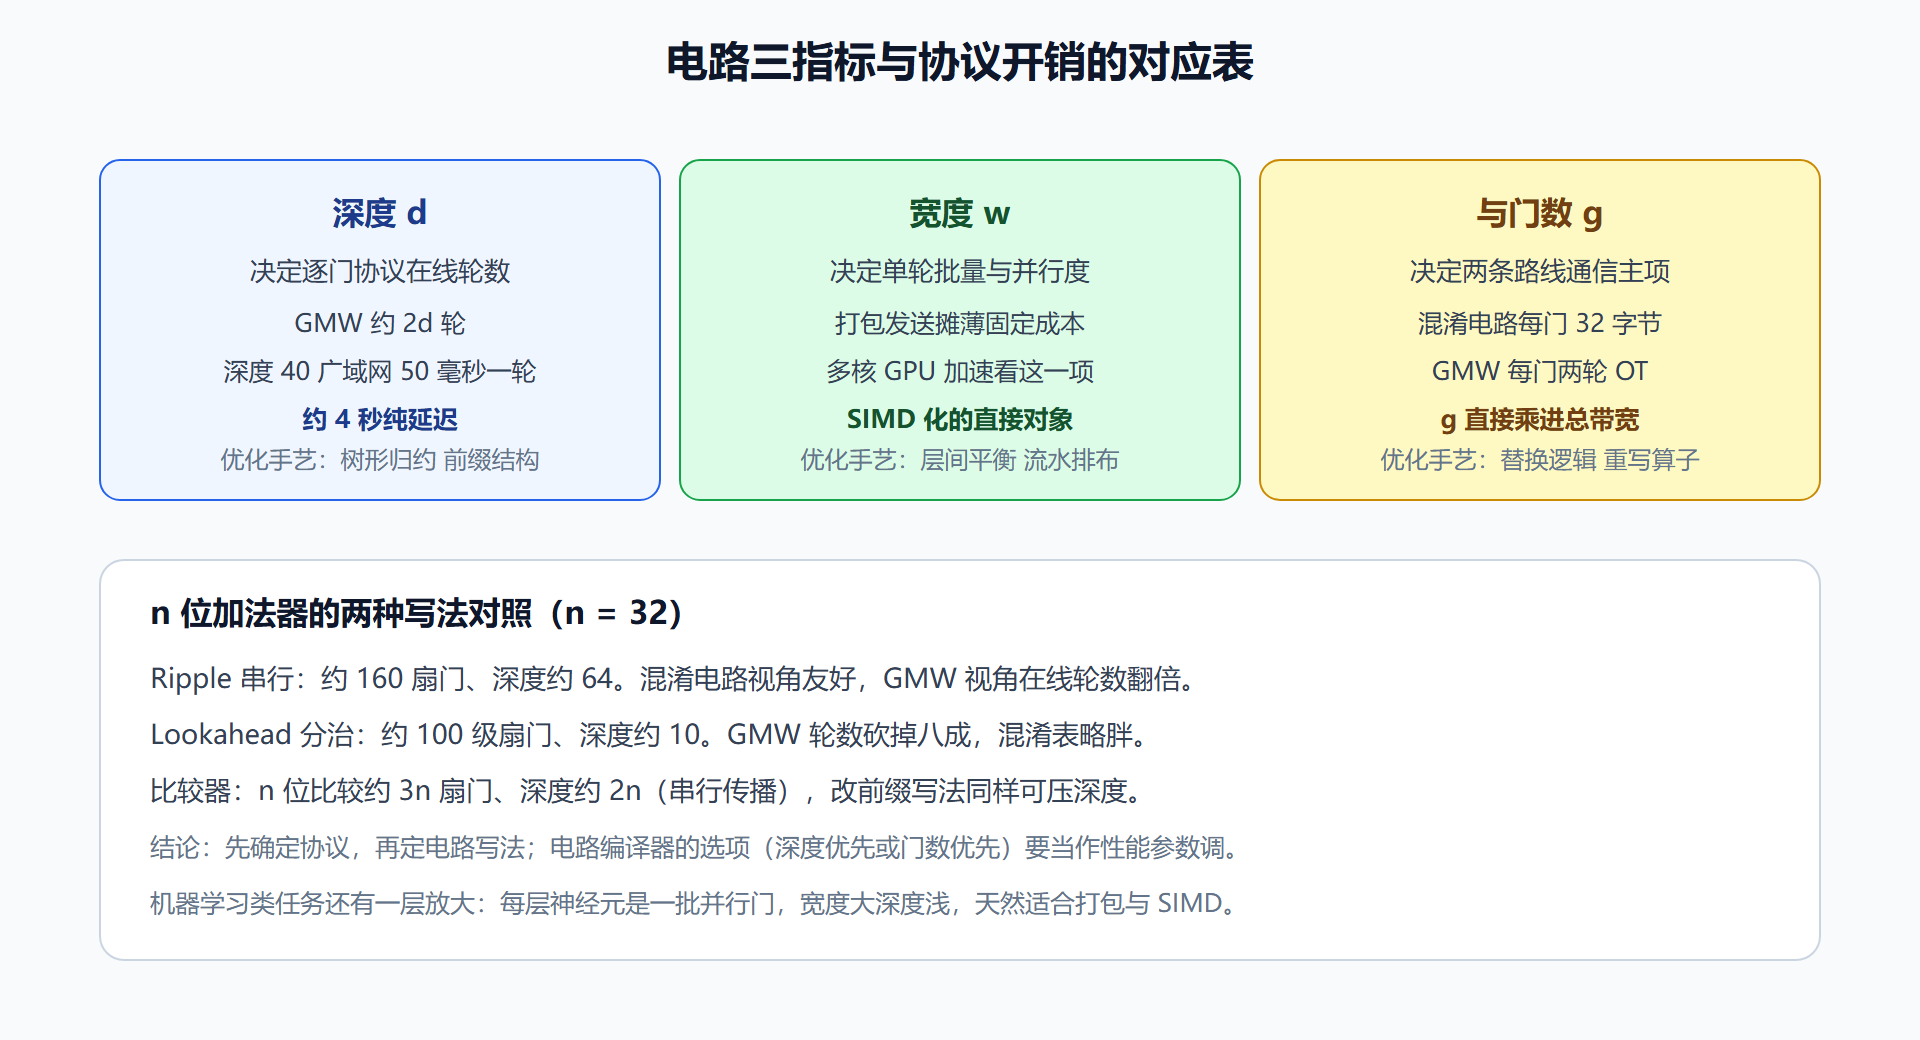
深度(depth):从输入到输出最长路径上的门级数。它决定逐门协议(GMW)的在线交互轮数——深度为 d 的电路,信号要过 d 级门,每级一轮(与门两级:OT 加重组),总轮数约 2d。宽度(width):同一层上并行门的最大数量,决定单轮消息的批量大小与内存占用——宽度大的层适合把成千上万个门的消息打包一次发送(摊薄每轮固定成本)。与门数(AND count):混淆电路路线的通信量主项(每门 32 字节级),也是 GMW 的 OT 主项(每门两次)。异或门在两条路线里都近乎免费,所以电路编译器的核心 KPI 是"少用与门、压低深度"。
拿两个例子算账。 Ripple 进位加法器:n 位加法用 n 个全加器串行,深度 2n、约 5n 扇门——深度深、门省。Carry-Lookahead 加法器:用分治的生成传播结构,深度降到对数级(约 2 倍 log n 加常数)、门数涨到约 3n——门多点、深度换时间。哪个划算取决于协议:混淆电路看门数(Ripple 便宜),GMW 看深度(Lookahead 便宜)。同一个函数,协议不同,最优电路不同——这是 MPC 工程里最反直觉也最值钱的一条经验。
图:三个指标如何各自决定一种开销
动手演练:从函数到开销估算
def estimate_circuit(kind, n): """常见构件的门数与深度粗估(经验公式,量级准确)。""" table = { "adder_ripple": (5 * n, 2 * n), # 门数, 深度 "adder_cla": (3 * n, 2 * n.bit_length()), "comparator": (3 * n, 2 * n), "equality": (2 * n, 1 + n.bit_length()), "mux": (3 * n, 2), } gates, depth = table[kind] gc_kb = gates * 32 / 1024 # 混淆电路:与门按 32 字节上限粗估 gmw_rounds = 2 * depth # GMW 在线轮数 return gates, depth, gc_kb, gmw_rounds for k in ["adder_ripple", "adder_cla", "comparator"]: g, d, kb, r = estimate_circuit(k, 32) print(f"{k}: 门数{g} 深度{d} GC约{kb:.0f}KB GMW约{r}轮")
会话输出三行,直接可见同一构件两种写法在两条协议下的开销翻转——adder_ripple 在混淆电路下省表、adder_cla 在 GMW 下省轮。把这段估算嵌进你的选型文档,比任何口头争论都有说服力。
工程实践要点
三个来自实战的提醒。控制流是深度杀手:一段十层的 if 嵌套展开成电路后深度暴涨,把条件改写成算术选择(乘法掩码)往往既省深度又省与门。查表要警惕:S 盒这类非线性构件若按"真值表逐项比对"展开,门数爆炸;成熟电路库都用位运算重写过的等价实现(AES 的 bitsliced 版本就是范例)。别忘了负数与定点数:带符号比较要额外处理符号位,浮点在 MPC 里通常改造成定点或对数表示——表示法的选择会传导到电路的每一层。
💡 关键直觉:电路的深度是"时间的下限",宽度是"空间的下限",与门数是"通信的下限"。三条下限里先压哪条,由你的协议与网络决定——这句话值得写进每个 MPC 项目的架构评审纪要。
本节要点:深度换轮数、宽度换并行、与门数换带宽;同一函数在不同协议下的最优电路不同;电路写法本身就是性能优化的一线阵地。布尔路线到此收官,下一章进入算术世界。
一次真实的调优记录
把抽象指标落成一次调优经过。某个联合评分任务初版用通用编译器生成电路:深度 87、与门约 21 万,广域网 GMW 实测在线 7 秒多。调优分三步。第一步剪枝:规则引擎里三成条件在编译期可判定恒真恒假,删除后与门降到 14 万,深度降到 61——省的是"明文侧本来就知道答案"的计算。第二步换写法:阈值比较链从串行传播改前缀结构,深度砍到 22,GMW 轮数从 122 降到 44,在线时间近半。第三步打包:评分按 64 通道 SIMD 化,单轮消息变大、轮次不变而吞吐翻倍。三轮过后在线约 1.8 秒,满足业务窗口。
复盘这次调优的时间分配:剪枝两小时、改写两天、SIMD 一周——收益递增的同时成本也在递增,先摘低垂果实再啃硬骨头,是所有性能工作的通用节奏。这张时间账值得抄进你自己的项目计划书。
电路指标的度量方法
指标要能度量才有用。三个指标的实操获取方式:门数与深度直接从电路编译器输出的统计报告读——主流工具链都会输出 gate count 与 depth,没有这个输出的工具链要谨慎选用;宽度看编译器的层划分报告或自己按拓扑序分层统计;与门占比决定混淆电路路线的成本结构,也是判断"该不该换算术路线"的第一指标——与门占比过半的大电路,通常值得评估换成 SPDZ 系的收益。
拿不到编译报告的场合(接手历史项目、评审外部方案),退路是按算法原型粗估:比较与加法是线性门数、乘法是二次(长乘)到对数(Karatsuba 类),深度与数据位宽同阶。粗估不精确但足够做量级判断,而量级判断恰恰是立项阶段最需要的。
最后一个提醒关于"指标的综合":三个指标不能同时最优,压深度往往涨门数(前缀结构)、压门数往往涨深度(串行结构),打包又要求宽度与定点格式配合。电路优化是多目标规划,先按协议与网络定权重,再动手改电路——这句收束了本章,也预告了第 6 章性能工程的全部方法论。