6.1 通信复杂度:MPC 的第一瓶颈
6.1 通信复杂度:MPC 的第一瓶颈
本节摘要:MPC 的耗时近似等于"总通信字节除以带宽"加"轮数乘单程延迟"。本节给出这个估算模型的两个参数怎么取,用三个真实量级的算例展示为什么局域网与广域网的结论经常相反,并给出降低通信量的第一性思路。
核心概念
明文计算的成本模型是"指令数乘主频",MPC 的成本模型多了两个主项。项一:带宽时间,等于总通信字节除以有效带宽——总字节由协议单价(每乘法 16 字节、每与门 32 字节、恶意加价倍数)乘任务规模算出。项二:延迟时间,等于在线轮数乘单程往返延迟。两项相加再除以并行度修正,就是粗估耗时。公式粗糙,但量级判断足够准,而且立刻揭示一个要害:带宽时间可以靠堆带宽压,延迟时间只能靠砍轮数——跨城专线把带宽拉到十吉比特不难,把物理延迟从 40 毫秒压到 4 毫秒近乎不可能。
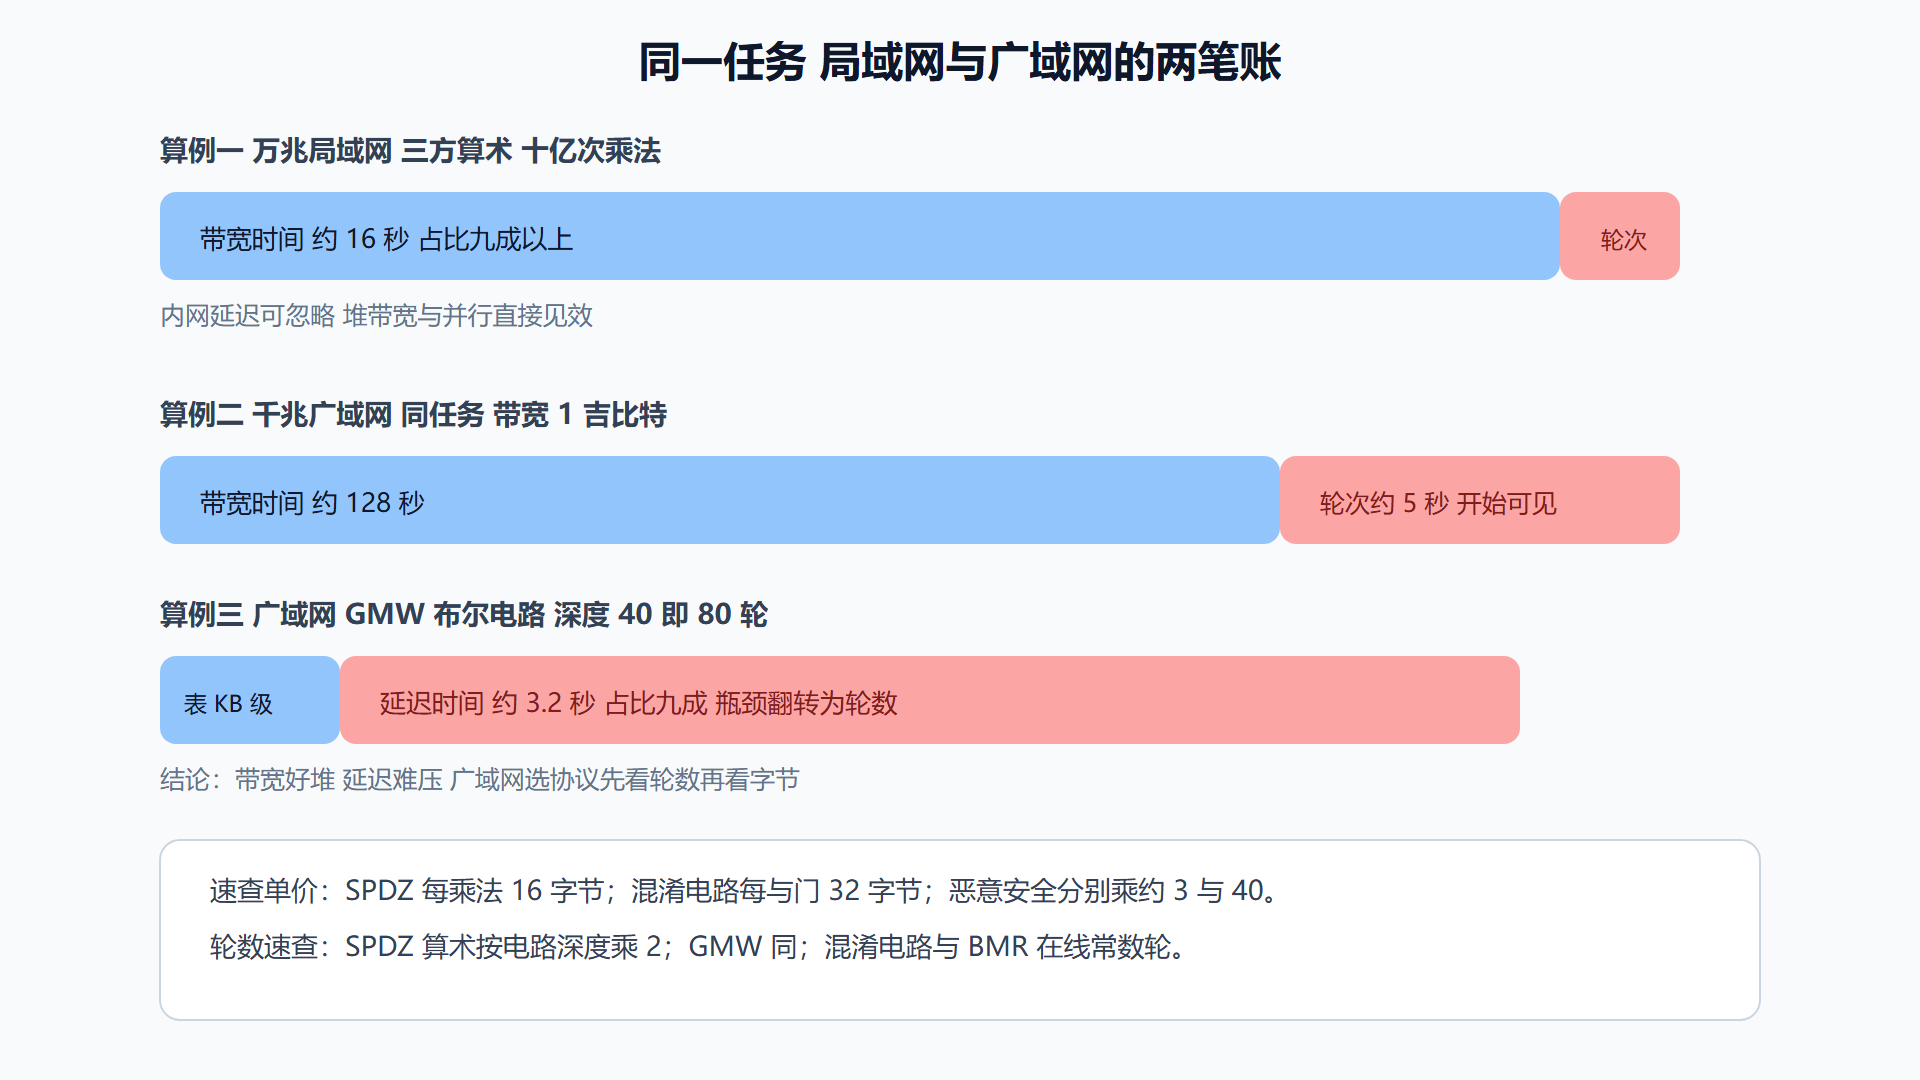
三个算例建立手感。算例一,局域网三方算术任务:十亿次乘法,每乘法 16 字节共 16 GB 通信,万兆内网有效带宽每秒约 1 GB,带宽时间 16 秒;轮数几十轮、单轮内网延迟低于 1 毫秒,延迟时间可忽略——瓶颈是带宽,堆机器与万兆见效。算例二,同样的任务搬到跨区域广域网:带宽时间若带宽 1 吉比特则 128 秒;轮数若协议在线有 60 轮、单程 40 毫秒则 4.8 秒——带宽仍是大头,但延迟开始可见。算例三,GMW 跑深度 40 的布尔电路在同一广域网:80 轮乘 40 毫秒约 3.2 秒纯延迟,而它的总通信可能只有几十 MB、带宽时间不到 1 秒——瓶颈整个翻转到轮数。结论不是"哪个协议好",而是"先测网络,再谈协议"。
图:两笔时间账在不同网络下的占比翻转
降低通信量的第一性思路
治带宽有三招,优先级从高到低。第一招换表示粒度:能算术就别布尔——一个 32 位乘法在算术世界 16 字节,在布尔世界展开成电路后按百字节计。第二招批处理摊薄单价:把许多小消息合并成大消息,省的是每条消息的封装与确认开销(TCP 头、加密 nonce、批处理校验),协议层对应"批量开放"——开放一千个值不比开放一个贵一千倍。第三招压缩与复用:随机掩码复用要格外小心(复用即泄密),但验证材料、密钥派生缓存这类"非随机性材料"的复用是安全的常规操作。
治轮数同样三招:SIMD 打包(一个环元素塞多个短数值并行运算,轮数不变吞吐翻倍)、协议换道(逐门协议改混淆型常数轮协议,即第 4 章 BMR 的思路)、电路优化压深度(4.3 节的前缀结构与层平衡)。
动手演练:写一个容量估算器
def estimate_seconds(mul_count, and_count=0, rounds=0, mbps=1000, rtt_ms=40, parallel=1): """MPC 耗时粗估:带宽账加轮次账,除以并行度。""" bytes_total = mul_count * 16 + and_count * 32 bandwidth_time = bytes_total / (mbps / 8 * 1_000_000) latency_time = rounds * rtt_ms / 1000 return (bandwidth_time + latency_time) / parallel print(estimate_seconds(mul_count=1e9, rounds=60, mbps=10000, rtt_ms=1)) print(estimate_seconds(mul_count=1e9, rounds=60, mbps=1000, rtt_ms=40)) print(estimate_seconds(and_count=1e5, rounds=80, mbps=1000, rtt_ms=40))
会话输出约 16.1 秒、132.4 秒、3.2 秒——与正文三个算例一致。把这个函数抄进项目,参数换成你自己任务的真实规模与机房网络,比任何通用基准都贴近真相。
⚠️ 常见坑:拿框架论文里的局域网数字去推广域网表现。两者瓶颈项不同,外推结论常常差一个数量级。选型前先在目标网络上跑一遍官方基准示例,这半小时的功夫能省掉整个项目的返工。
本节要点:耗时等于带宽账加轮次账;局域网压带宽、广域网砍轮数;单价表与轮数表是估算的全部输入。下一节把"怎么变快"的工具箱逐个打开。
网络参数的实测方法
估算模型的好坏取决于参数是否真实。三个参数的实测要点:有效带宽用大文件对拷测,取持续值而非峰值,TCP 窗口与加密开销都会让有效值低于标称值三到七成;往返延迟用小包连续探测取中位数,注意跨机房线路在忙时延迟波动可达数倍,按忙时数据做容量规划;并行度取决于框架的并发通道数与双方 CPU 核数,单连接吞吐打满后再加连接,并行度的真实上限要靠压测找。
实测之外还有一类"伪瓶颈"值得警惕:消息序列化与加解密在应用层排队,会伪装成网络慢。区分办法是在两端打点——发送排队时间与线路传输时间分开统计。6.1 节的估算模型给出数量级,打点数据给出真凶,两者合用才有说服力。
把每次实测数据存档成网络档案:带宽、延迟、抖动、忙时曲线,四项数据跟着机房走。下一个 MPC 项目立项时,这份档案就是最可靠的容量规划依据——比任何厂商承诺都值钱。
通信优化的两条暗线
字节账之外还有两条容易被忽略的暗线。暗线一:消息形状。同样 1 MB 数据,一个大消息与一千个小消息在网络栈里的待遇天差地别——每条消息的头部、加密nonce、确认开销是固定税,消息越小税率越高。这就是批处理的本质:不是少传字节,是少缴笔数税。实测里"合并到 64 KB 以上"往往就能吃到大消息的绝大部分红利,调参成本极低,值得作为通信优化的第一动作。
暗线二:方向与拓扑。多方场景里消息流经的拓扑(星型、环型、全互联)决定同一份数据被发送的次数——全互联下每方都要向其余各方广播,字节量随参与方数平方增长;星型结构省带宽但引入中心角色。拓扑选择因此是安全结构与通信成本的交换点,7.1 节联邦学习的聚合角色之争,本质就是这道拓扑选择题。
两条暗线合起来修正一个常见误判:通信优化不是"把字节变小"的压缩问题,而是"让字节流得便宜"的物流问题——形状、批次、路径三者合起来,常常比换协议省得更多。6.1 节的估算模型给的是总量判断,这两条暗线决定的是总量之下的实际表现,账要两层一起算。