6.2 优化工具箱:批处理预计算剪枝
6.2 优化工具箱:批处理、预计算、剪枝
本节摘要:MPC 提速不是单一技巧而是工具箱:批处理省通信单价、预计算搬走在线开销、剪枝砍电路规模、打包(SIMD)摊薄轮数、并行化吃满硬件。本节逐项讲收益机制、适用边界与互相冲突之处,并给一个组合使用的优先级。
一、四类工具各自省哪笔账
**批处理(batching)**把粒度放大:单独开放一个值是一条消息、一次校验、一份封装开销;开放一万个值仍是"一次批量动作"。省的是每笔固定开销(封包、nonce、校验摊薄),不改变字节总量——适合"海量小操作"的统计任务,对"少量巨型操作"帮助有限。**预计算(preprocessing)**把与输入无关的贵重材料挪到离线:Beaver 三元组、OT 扩展点火、随机掩码全部提前生产。在线阶段只剩对称运算加一轮开放,这是 SPDZ 与 BMR 共同的经济学(第 4、5 章已反复出现)。它的约束是"材料一次性"——三元组用一次就废,库存规划成为部署课题。
**剪枝(pruning)**在电路层做减法:机器学习推理里的死分支(条件恒假的子树)、恒等运算(乘 1 加 0)、可以合并的相邻层,都在编译期裁掉。收益直接作用于门数与深度,两条路线通吃。打包(packing 或 SIMD)是环上的并行术:64 位元素塞进多个短数值(比如 8 个 8 位数),一次环运算带 8 份计算量,轮数不变而吞吐翻倍——深度大、批量大的任务收益最大。最后还有并行化这个压舱石:多方协议的消息彼此独立,多线程收发与多核校验几乎是白送的加速,GPU 则对混淆电路的批量解密有立竿见影的效果。
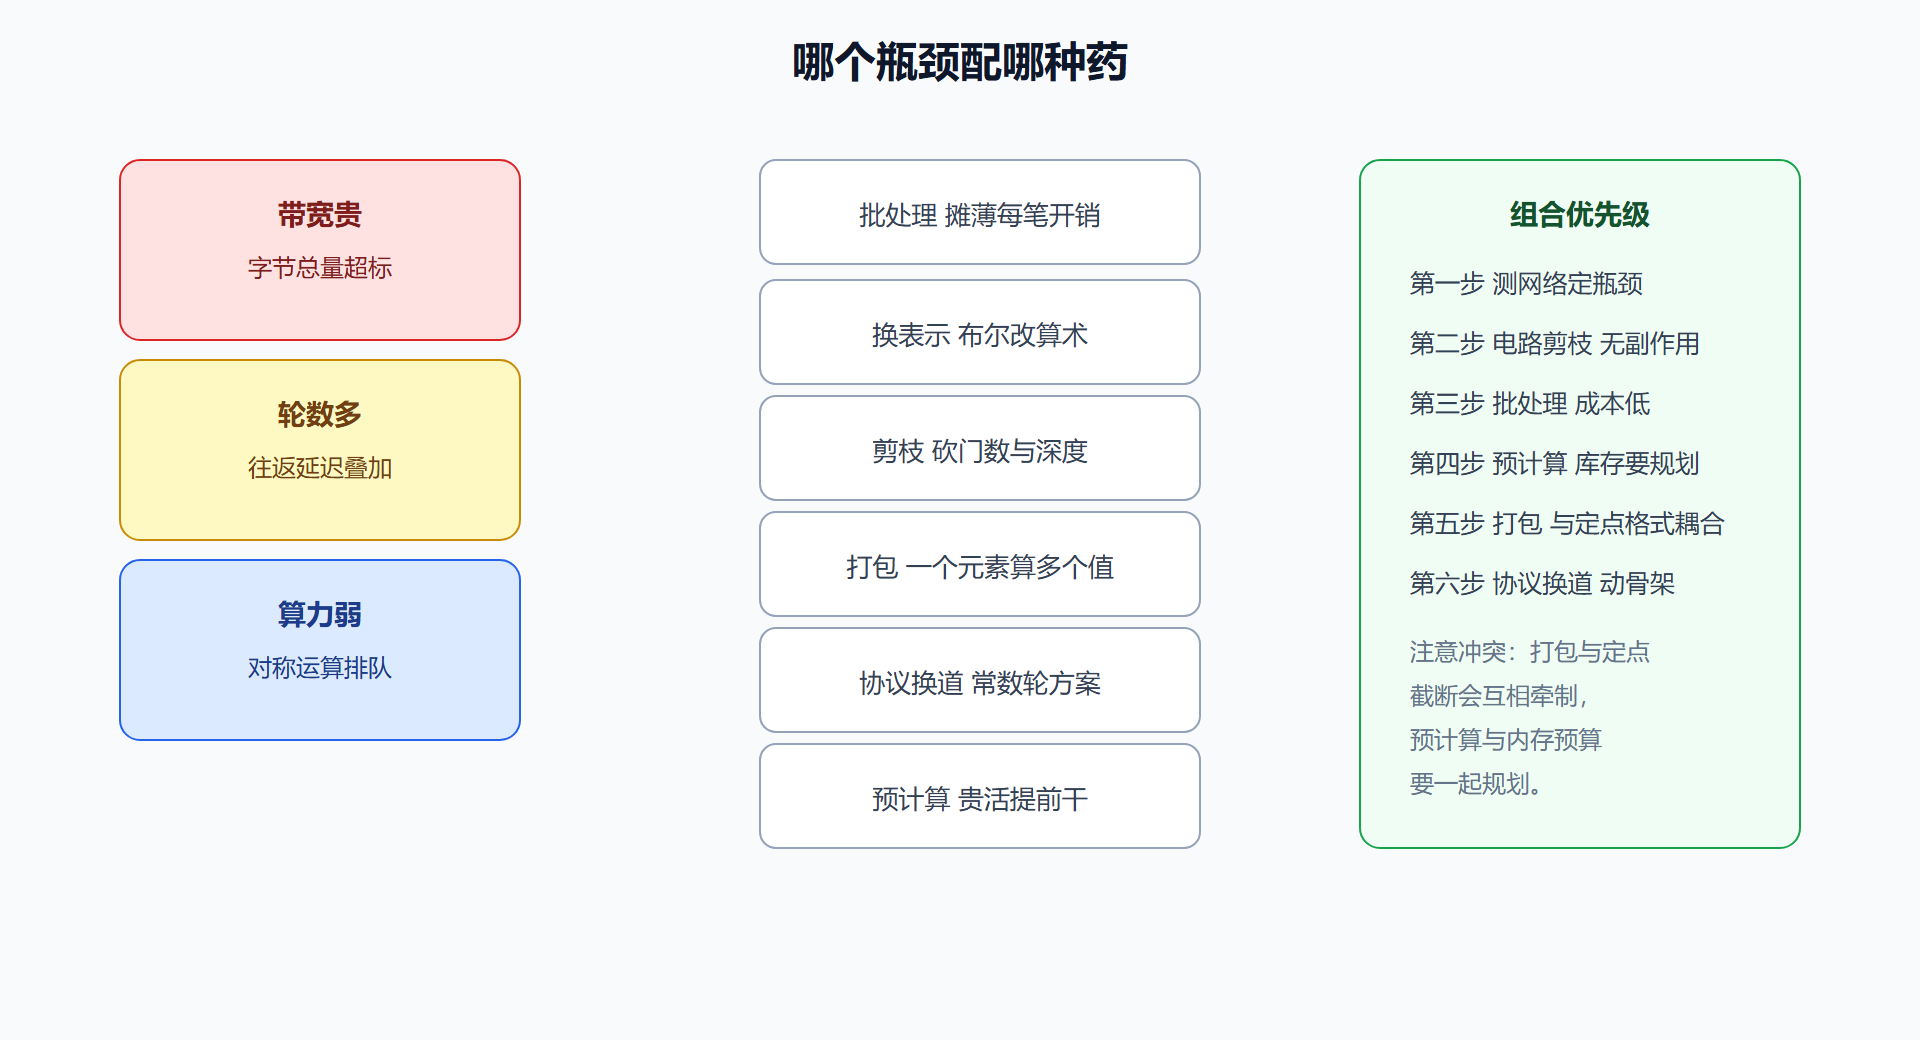
图:优化手段与瓶颈的对应关系
二、动手演练:剪枝前后的开销对比
def nn_forward_gates(inputs, hidden, outputs, dead_branch_ratio=0.0): """两层网络在混淆电路下的与门数估算(演示剪枝收益)。""" layer1 = inputs * hidden # 每个权重乘法在布尔世界摊平为多个与门 layer2 = hidden * outputs gates = 32 * (layer1 + layer2) # 32 位乘法约 32 个与门的粗估 # 剪枝:编译期发现死分支与恒等节点按比例移除 pruned = gates * (1 - dead_branch_ratio) return gates, pruned g0, g1 = nn_forward_gates(128, 64, 10) gp0, gp1 = nn_forward_gates(128, 64, 10, dead_branch_ratio=0.35) print(g0, g1) # 与门总数:约 29.7 万 print(gp0, gp1) # 剪枝后:约 19.3 万,省 35% 带宽
会话输出显示同一网络仅靠编译期剪枝就省下约三分之一的混淆表传输。真实框架的收益因网络结构而异,量级可信。
三、工程实践要点
工具箱使用的三条军规。先测量后优化:用 6.1 节的估算器定位瓶颈项,再选工具——给带宽瓶颈的任务上 GPU 并行是最常见的南辕北辙。一次改一个变量:打包、截断、批处理三者互相牵连(打包改变截断的边界行为),同步改动会让性能回退无从归因。预计算当库存管理:按"任务峰值乘法数乘安全余量"备货,监控库存水位并告警——在线引擎因三元组断供而停摆,是运维事故里的高频条目。
💡 关键直觉:所有优化都在回答同一个问题——"这次通信能不能不做、晚做、便宜做、合并做"。四个动词对着瓶颈清单过一遍,方案自然浮出来。
本节要点:批处理省单价、预计算换时段、剪枝做减法、打包摊轮数、并行吃硬件;先测网络再动手,一次改一个变量。下一节进入具体框架的选型。
一次完整调优的决策序列
把工具箱串成一次真实调用的顺序。某联合统计任务初测 47 秒,目标 10 秒。第一步测网络:广域网 200 兆带宽、40 毫秒往返;用 6.1 节公式拆账,通信 41 秒、轮次 5 秒——带宽是主矛盾。第二步批处理:开放操作从逐值广播改为攒批,通信量不变但封包开销下降,实测降到 39 秒——收益有限,说明瓶颈在字节总量而非笔数。第三步换表示:布尔子任务改算术,字节总量砍半,降到 21 秒。第四步剪枝:编译期恒定条件删除,再降两成,17 秒。第五步打包 SIMD:短数值塞满环元素,同轮次吞吐翻倍,最终 9.4 秒达标。
复盘可见两个反直觉之处:最先想到的批处理收益最小,真正的大头在"换表示"与"打包"这类动结构的手段。调优顺序应当按"预期收益除以改动成本"排序,而不是按工具箱顺序——这也是 6.2 主图把"测网络"放在第一步的原因:不知道瓶颈在哪个科目,排序无从谈起。
工具箱的反向清单:什么不该做
正向清单之外,三类"看起来是优化、实际是负债"的动作值得点名。其一,过早打包:SIMD 化把数值格式、截断边界、电路分层全部耦合,一旦业务格式变更,打包层全部重调——在吞吐瓶颈未确认前引入这种耦合是负债。其二,激进剪枝:把"当前恒真"的条件删掉,业务规则一变电路就错,且错得悄无声息——剪枝清单必须与业务规则版本绑定,规则变更触发重编译。其三,预计算囤积过量:三元组不是免费的内存与生成算力,囤积过大既浪费又拉长故障恢复时的对账时间——按峰值乘安全余量备货即可,余量系数要有监控数据支撑而非拍脑袋。
三类负债的共同病根是把优化当成了"越多越好"的堆叠,而它实际是一组带维护成本的资产——每项优化都要有明确的瓶颈依据、版本绑定与回退路径。把"这项优化什么时候该撤"写进方案,与写"什么时候该上"同样重要。养成这个习惯,你的性能工作才能经得起一年后的复盘。
工具箱使用的一页速查
把 6.2 节浓缩成一页速查,贴在工位上够用一年。批处理:攒批到 64 KB 以上再发,先于一切通信优化。预计算:三元组库存水位告警是上线第一周就该配的监控。剪枝:与业务规则版本绑定,规则变更触发重编译。打包:吞吐瓶颈确认后再做,同时冻结数值格式。并行化:打点确认计算占比过半再投入。换表示:与门占比过半的大电路评估换算术路线。换协议:最后手段,换完重走安全评审。七行口诀按投入成本从低到高排列,照序执行即可——顺序本身就是这门手艺的精华。